
Redis 数据库
1. Redis 架构认知与核心特性
1.1 NoSQL 生态与数据模型
NoSQL通常展开为Not Only SQL,覆盖多种不同的数据模型与系统设计。它不是“关系数据库天然性能不足”的统一替代品,也不意味着所有产品都没有事务、Schema或查询语言。
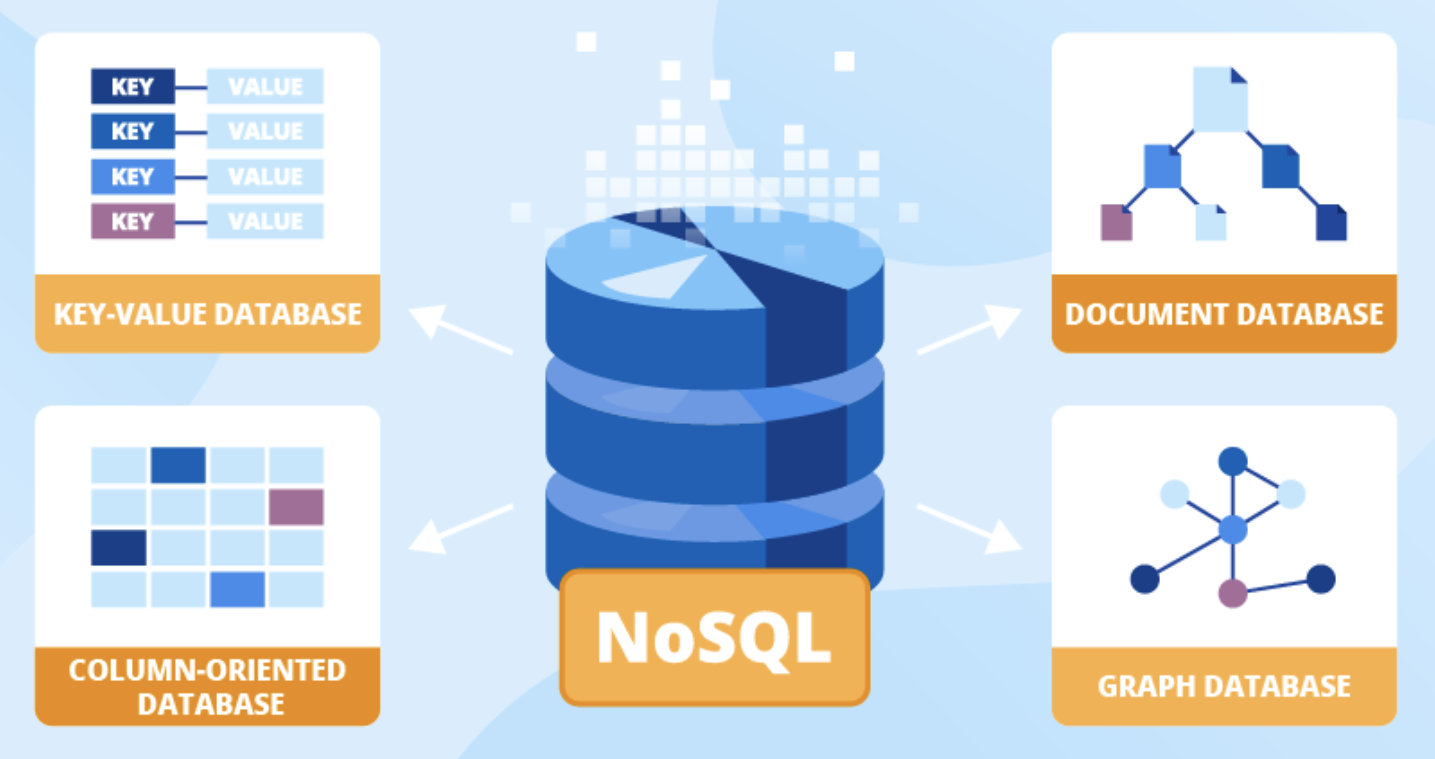
| 模型 | 数据组织和代表 | 常见适用场景与边界 |
|---|---|---|
| 键值 | Key映射Value;Redis、Memcached等。 | 缓存、会话、计数等。普通String不按内部JSON字段索引,但Redis还提供Hash等结构和可选扩展能力。 |
| 宽列/列族 | 以行键、分区/聚簇及列等组织,HBase、Cassandra等各有模型。 | 大规模写入、时序和按预设访问路径查询,不等于列式OLAP数据库。 |
| 文档 | JSON/BSON等文档,MongoDB等。 | 字段灵活、支持文档内部查询;仍需数据契约,也可使用Schema验证。 |
| 关系 | 表、列、键及关系,MySQL、PostgreSQL、Oracle等。 | 交易、约束和关联查询;一致性还取决于隔离级别、复制和应用设计。 |
| 图 | 节点、边及属性,Neo4j等。 | 社交关系、知识图谱、风控和路径遍历;不只存“关系”而不存实际数据。 |
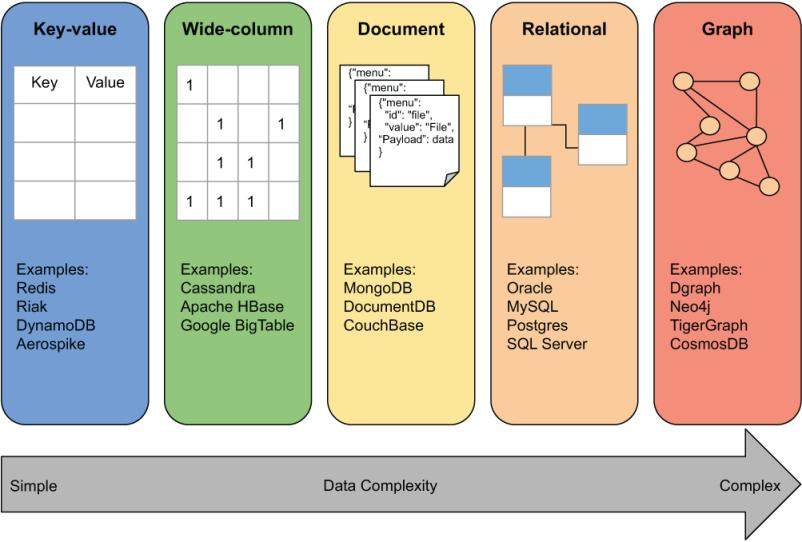
图中“从键值到图、关联复杂度逐步上升”是原理示意,不是任何产品都按相同顺序获得读写性能、查询能力或扩展性。选择应依据访问模式、数据量、约束和故障要求。
1.2 列式存储与宽列数据库
| 维度 | 列式存储 Columnar | 宽列数据库 Wide-column |
|---|---|---|
| 本质 | 一种物理组织方式,可属于关系数据库等系统。 | 一类逻辑数据模型及数据库设计。 |
| 数据布局 | 同列或列块组织,适合少量列扫描、压缩与聚合。 | 按行键/分区、列族或列组织,具体布局因产品而异。 |
| 代表 | ClickHouse、Vertica;Greenplum也支持不同表存储方式,不能说它只有列存。 | HBase、Cassandra、Bigtable。 |
| 查询 | 分析、BI、日志和用户行为聚合;重构整行的成本与存储/查询有关。 | 大规模写入、按键/分区或预设范围读取;跨行聚合能力依产品和计算层。 |
| 典型模型 | 按列保存age、name等字段的数据块。 | HBase可用行键—列族—qualifier—版本时间理解;不能把同一四维模型原样套给Cassandra。 |
列族中可有大量稀疏列,但不是无限容量;列数、行大小、热点、压缩和索引都有现实约束。宽列系统也不都等同传统OLTP,更不能因都带“列”字就把它们与列式分析引擎混为一类。
1.3 Redis 定位与典型业务
Redis是以内存数据和键值/数据结构操作为核心的数据库,常用于缓存、会话、计数、排行、队列和协调。它支持持久化、复制与高可用方案,但内存读写、命令原子性和副本存在都不自动等于强一致或永不丢数据。
| 场景 | 常见实现 | 必须另行设计的部分 |
|---|---|---|
| 热点缓存 | String/Hash,Cache-Aside等。 | TTL、失效、穿透/雪崩、热点重建及与数据库的一致性。 |
| 分布式会话 | 共享会话状态及过期时间。 | 客户端身份、Cookie/Token、安全策略、续期及登录语义。 |
| 计数/库存 | INCR、INCRBY、DECRBY等。 | 业务去重、库存下界、数据库同步及失败重试。 |
| 排行榜 | Sorted Set。 | 分数规则、并列次序、更新来源和数据持久性。 |
| 消息 | List或Stream。 | 取走后崩溃、确认/重试、积压、顺序和消息保留。 |
| 分布式锁 | 原子SET NX EX/PX及随机持有者标识。 | 租期、续约、旧持有者、故障切换和必要的栅栏/幂等。 |
| 限流 | 计数器或ZSet时间窗口。 | 多步骤原子性、时间/窗口语义、容量和过期清理。 |
List可以有多个竞争消费者,也可以按Redis持久化配置落盘;它缺少Stream消费者组式的原生Pending/ACK管理,不能写成“List不持久化、不支持多消费者”。Stream的可靠性同样依赖持久化、复制和应用确认策略。
1.4 性能与容量评估
吞吐取决于命令复杂度、值大小、网络、并发、Pipeline、TLS、持久化和复制,不能给 Redis 或 MySQL 设一个通用 QPS 上限。压测记录成功率、吞吐、P50/P95/P99、CPU、内存、网络和磁盘,使用与业务接近的数据及访问分布。
QPS 是每秒请求或命令数,TPS 是每秒事务数,统计范围必须一致。稳态下平均在途量约等于吞吐量乘平均响应时间;空闲连接数不能代替在途请求数。
1.5 内存结构、线程与事件循环
Redis常用SDS、字典、紧凑编码、quicklist、listpack、跳表等结构,实际编码随版本、大小和配置变化。并不是所有操作都O(1)/O(logN)或没有额外成本;扫描、集合运算和返回大量元素可能与数据量成正比。
核心命令路径通常由主线程串行执行,可以减少多个命令执行线程同时修改共享数据带来的锁竞争;这不表示整个Redis进程只有一个线程、绝对没有锁、没有并发缺陷或任何命令都不会阻塞其他请求。
Redis6.0开始提供可配置的多线程网络I/O,后续版本继续演进,是否处理读取、写入及协议工作要按版本/配置确认。后台线程、fork出来的持久化子进程及模块能力也不能与主命令执行线程混为一谈。
事件循环的基本过程:
- 为监听socket和客户端连接登记事件。
- 通过平台对应的事件机制等待就绪。
- 读取、解析并执行相应命令,处理待发送结果。
- 结合定时任务、过期等工作,继续下一轮。
Linux 常用 epoll,其他平台可能使用 kqueue 等后端。epoll管理就绪事件不等于零内核开销,也不保证任意程序都能承受百万连接。
Redis 的 epoll 后端不应默认视为边缘触发。以 Redis 7.0 的ae_epoll.c为例,注册EPOLLIN/EPOLLOUT时没有设置EPOLLET,不能据通用epoll原理给它套上默认ET结论。select的FD_SETSIZE限制与poll不同,poll并没有同一固定1024描述符限制。
长时间Lua、大量元素返回、大Key删除、低效集合计算、fork及内存压力等都可能增加其他请求延迟。BLPOP等“阻塞客户端等待”的命令会把客户端挂起,不是把整个服务器主线程一直卡在那里等待一条消息。
1.6 性能瓶颈与环境准备
不要先假设CPU一定不是瓶颈。即使GET/SET也可能耗满执行核心;多核总利用率低,不能证明主要执行线程有余量。对比单线程CPU、事件循环、网络和客户端端到端延迟,才能判断所在环节。
| 方向 | 常见现象和处理 |
|---|---|
| 网络 | 返回值大、吞吐高、RTT高。千兆链路理论约125MB/s,10万次/秒各回1KB约100MB/s,还未计协议等开销;拆Key不自动减少总传输量。 |
| CPU/命令 | 复杂命令、序列化、Lua、TLS、协议和分配成本;按实际命令优化,而不只增加机器核数。 |
| 内存 | 数据本体、对象开销、客户端/复制缓冲、碎片、持久化COW等;maxmemory不是进程RSS绝对上限。 |
| 延迟尖峰 | 大Key、fork、磁盘fsync、内存换页、调度和外部干扰。 |
| 复制/客户端 | 副本延迟、连接/文件描述符、客户端消费和Pipeline策略。 |
持久化fork采用写时复制,不是立即完整复制所有内存;高写入可产生大量COW额外内存。内存不足也不保证一定自动淘汰,具体看maxmemory和策略,noeviction会拒绝相应写入。
实验节点应互通,并按角色限制Redis6379、Sentinel26379及Cluster所需端口。关闭防火墙不是安装前提;后续故障、复制和高可用实验只在授权的独立测试环境进行。
2. 数据类型与典型应用
2.1 业务模型示例
| 需求 | 类型和示例 |
|---|---|
| 简介/阅读计数 | String,star:jay保存简介或独立计数键。 |
| 人物档案 | Hash,star:info:1001中name=ZJL、age=46、city=台北市、fans=8000。 |
| 评论排队 | List,向comment:star_jay依次加入评论。 |
| 关注者去重/共同粉丝 | Set,保存用户ID并做交集。 |
| 热度排名 | ZSet,hot:star_rank:ZJL=98000、LJJ=92000、XZQ=86000。 |
| 日活/签到 | Bitmap,一个分配好的用户偏移对应一位。 |
| 近似UV | HyperLogLog,估计不重复访客数。 |
| 场馆/附近位置 | Geo,地点经纬度与距离查询。 |
| 直播事件/弹幕 | Stream,事件ID、消费者组及确认。 |
这些是业务建模示例,名字、年龄和分数不作为现实人物事实。
2.2 String
String可保存二进制安全的字节序列,也可由相应命令解释为整数/数值。通常默认单个值上限为512MiB,实际版本及协议/配置限制需核对,不应接近上限才开始治理大Key。
SET key value EX 60
SET key value NX EX 30
SET key value XX
GET key
INCR counter
INCRBY counter 10
DECR counter
DECRBY stock 1
EXPIRE key 60
每行是独立语法示例,不在同一个业务键上混用字符串与计数。INCR类命令要求可表示的整数,单条原子性不等于包含查库、库存检查及写库的完整业务事务原子性。
适合热点缓存、计数、序列化对象和会话等。SET ... EX可以将写值与过期放在一次命令里;把SETNX与EXPIRE拆开可能在进程崩溃时留下无期限锁。
“超过10KB就是不允许的大Key”不是Redis硬规则,应按访问量、网络、复制、删除和内存开销评估。
2.3 Hash
Hash按field读写对象属性,支持HINCRBY等字段操作,减少每次读取/改写整个序列化对象的需求。
HSET user:1001 name zhangsan age 20
HGET user:1001 name
HGETALL user:1001
HINCRBY user:1001 age 1
HDEL user:1001 age
HSCAN user:1001 0 COUNT 100
现代Redis常见小Hash紧凑编码为listpack,较大时可转为hashtable;不能把旧ziplist固定描述为所有当前版本的默认。Hash比一个JSON String更省内存也不是恒定结论,取决于字段、编码、键数和序列化形态。
原“字段建议不超过5000”仅是教学经验数,不是容量限制;单个巨大field同样可能产生问题。HGETALL返回全部字段,HSCAN可分次遍历但不是一致性快照,COUNT也不是严格返回条数。
Redis中的对象字段不自动拥有关系表的类型、外键和约束;业务仍需定义数据格式与校验。
2.4 List
List保存有序的字符串序列,可从两端插入/弹出,按索引或范围读取。常见现代实现使用quicklist及紧凑节点等,不能把其内部编码永久写死为ziplist加链表。
LPUSH jobs job1 job2
RPUSH comments message1 message2
LPOP jobs
RPOP jobs
BLPOP comments 0
BRPOP jobs 0
LTRIM comments 0 99
LRANGE comments 0 9
LINDEX comments 0
LPUSH配合BRPOP或RPUSH配合BLPOP可组织FIFO,LPUSH/LPOP可组织LIFO;具体消息顺序需按实际插入次序观察。LTRIM会丢弃范围外数据,不只是改变显示范围。
阻塞弹出可用于简单任务队列;多个消费者可以竞争获取消息,但弹出后消费者崩溃,List不会自动维护一份待确认记录。可靠队列需额外处理中间队列/确认恢复等,或采用适合的Stream模式。
List本身可纳入RDB/AOF持久化,因此原“List不支持持久化”错误。持久化与消费确认是两个不同问题。原10000元素建议不适用于所有负载,仍需按元素大小、操作和延迟评估。
2.5 Set 与 Sorted Set
Set
元素唯一,不保留业务插入顺序,适合关注、去重、共同好友等。
SADD fans:jay u1 u2 u3
SADD fans:lin u2 u3 u4
SMEMBERS fans:jay
SINTER fans:jay fans:lin
SRANDMEMBER fans:jay
SRANDMEMBER fans:jay 2
SSCAN fans:jay 0 COUNT 100
SMEMBERS/大集合交并差可能返回或处理大量元素;SSCAN减少单次遍历规模,不代表没有重复、稳定排序或并发快照。随机取样也不自动替代需要审计、公平性及防重复的完整抽奖流程。
Sorted Set / ZSet
成员唯一,每个成员一个score,可按分数与相应规则排序;相同成员更新score,不新增重复成员。相同分数还会按成员字节序等规则区分,业务需明确并列名次口径。
ZADD hot:star_rank 98000 ZJL 92000 LJJ 86000 XZQ
ZRANGE hot:star_rank 0 9 WITHSCORES
ZREVRANGE hot:star_rank 0 9 WITHSCORES
ZRANGE hot:star_rank 0 9 REV WITHSCORES
ZRANGEBYSCORE hot:star_rank 90000 +inf WITHSCORES
ZINCRBY hot:star_rank 100 ZJL
ZREVRANGE等保留旧接口示例,现代版本也可用ZRANGE的REV/BYSCORE等选项。小集合可能用紧凑编码,较大集合通常结合字典和跳表,不是始终只有跳表。范围查询还要加上返回元素数量的成本。
可用于排行、时间分数延迟队列和滑动窗口。ZSet也受Redis持久化保护,原“不支持消息持久化”不成立;真正缺少的是内置完整的消费确认、重试与调度协议,不能只凭取到到期score就保证任务只执行一次。
2.6 Bitmap、HyperLogLog、Geo、Stream
Bitmap
使用String中的位表示布尔状态,适合签到、访问集合和按位集合操作。
SETBIT active:20260620 1001 1
GETBIT active:20260620 1001
BITCOUNT active:20260620
BITCOUNT active:20260620 0 -1
BITCOUNT传统start/end默认按字节范围;需要按bit范围的版本可用对应BIT选项,不能把字节位置误当bit下标。
偏移上限常见为2^32-1,过大的稀疏用户ID仍可能让值扩展到很大容量。一个bit/用户的说法不包含键对象等开销,也隐含偏移分配紧凑,不能因为只置了一位就认为只分配一位内存。
HyperLogLog
估算基数,不保留可枚举的成员集合;常见密集结构约12KiB,另有对象等开销,稀疏状态也有不同表示。约0.81%是标准误差指标,不是任意样本都不超过该比例的最大误差保证。
PFADD page:uv u1 u2 u3
PFCOUNT page:uv
PFMERGE total:uv page:uv page2:uv
适合允许近似误差的UV,不能直接用于必须精确计费或需要逐个列出用户的场景。
Geo
保存地点坐标并进行附近/距离查询,底层利用Sorted Set及坐标编码。
GEOADD venues 116.397477 39.908692 tiananmen
GEOADD venues 116.4074 39.9042 demo
GEODIST venues tiananmen demo km
GEORADIUS venues 116.397477 39.908692 5 km WITHCOORD WITHDIST COUNT 10
GEOSEARCH venues FROMLONLAT 116.397477 39.908692 BYRADIUS 5 km WITHDIST
顺序为经度、纬度。GEORADIUS为旧接口示例,支持时优先GEOSEARCH等现代表达;经纬度要在支持范围内。距离是近似地理距离,不等于道路导航距离。
Stream
Redis5.0引入的消息流结构,提供有序ID、读取和消费者组等能力;存储可靠性仍与RDB/AOF、复制及故障模型相关。
XADD events '*' type login user u1
XADD events NOMKSTREAM '*' type logout user u1
XREAD COUNT 10 STREAMS events 0-0
XREAD BLOCK 1000 STREAMS events '$'
XGROUP CREATE events workers 0-0 MKSTREAM
XREADGROUP GROUP workers worker1 COUNT 10 STREAMS events '>'
XACK events workers 1710000000000-0
这些是交互/客户端命令形式;引号保护示意中的通配/特殊符号,具体客户端解析规则按所用redis-cli或SDK确认。XACK的ID必须替换成实际收到的ID,不固定存在上述样例ID。
消费者组中的待确认记录、重试/认领、保留与裁剪要由业务设计。XACK不等于删除消息,Stream也不会自动实现端到端恰好一次或在任意故障下不丢数据。
2.7 企业场景与一致性边界
Cache-Aside
读取先查缓存,未命中再查数据库并按策略填充;修改数据库后处理旧缓存及并发竞争。TTL限制陈旧数据可能保留的时间,不会凭空保证缓存与数据库强一致。
- 穿透:对不存在的数据设计校验、空值策略或布隆过滤;过滤器存在更新与误判特性。
- 雪崩:过期时间分散、分层缓存、容量与故障降级;随机TTL不能解决所有Redis节点整体失效。
- 击穿:热点重建合并、互斥和逻辑过期等;永不过期仍需更新、容量与故障处理。
后续章节继续给出MySQL/Redis实际交互与持久化、复制的完整实验。
Session
把会话状态存到共享Redis可减少多应用实例切换时本地Session不一致的问题,但App/Web是否共享会话取决于业务认证协议,并不会因为连同一个Redis就自动跨端登录。
String或Hash由所用框架及数据模型选择,不一概推荐Hash。EXPIRE续期也需由应用/框架实际执行,不是用户一有操作Redis便自行刷新。会话令牌需要不可预测、受保护的传输与客户端策略,不能只给Redis值加一段签名就认为完整安全。
计数与库存
INCR/DECR等单条命令原子执行,点赞的业务去重、取消次数、库存非负和数据库同步仍可能涉及多步骤。库存检查加扣减应采用原子的脚本/合适事务及幂等策略,不先GET检查后随意DECRBY就宣称防超卖。
租约式分布式锁
SET lock:order:12345 unique-request-token NX EX 30
获取失败时不会成为持有者,解锁必须比较自己获得的唯一标识。源中的完整解锁Lua逻辑:
if redis.call('GET', KEYS[1]) == ARGV[1] then
    return redis.call('DEL', KEYS[1])
else
    return 0
end
校验和删除在一次脚本中执行,避免误删新持有者的锁。但租期到期后旧工作仍继续、异步复制故障切换和续期失败等,仍可破坏业务互斥;按场景考虑栅栏、幂等和其他协调方式。Redlock有自己的故障与时钟假设,不能把它描述为自动解决所有可靠性问题的替代品。
固定窗口与滑动窗口限流
String计数配TTL适合简单固定窗口;INCR和首次设置过期时间等需要原子组合,避免失败后留下永不过期计数。固定窗口有边界突发问题。
ZSet可以把时间记为score,清理窗口外成员并计数;请求成员要唯一,裁剪、计数和允许/拒绝需要一起考虑并发。它不是仅给每个成员自动设置TTL,仍需主动清理和整体键生命周期管理。
3. Redis 安装与基础配置
3.1 软件包与源码安装
3.1.1 Ubuntu仓库方式
Ubuntu24.04自带源与Redis官方源是不同版本来源,先确定选择和升级政策,不因apt list看到多个版本就混装两套守护进程。传统sources.list示例为noble、noble-security、noble-updates、noble-backports的main/restricted/universe/multiverse;现代系统可能用DEB822 ubuntu.sources,按真实格式维护。
官方源示例:
apt-get install lsb-release curl gpg
curl -fsSL https://packages.redis.io/gpg -o /tmp/redis-repo-key.asc
# 通过可信发布信息核对指纹后导入专用keyring。
gpg --show-keys --fingerprint /tmp/redis-repo-key.asc
gpg --dearmor -o /usr/share/keyrings/redis-archive-keyring.gpg /tmp/redis-repo-key.asc
printf '%s\n' 'deb [signed-by=/usr/share/keyrings/redis-archive-keyring.gpg] https://packages.redis.io/deb noble main' > /etc/apt/sources.list.d/redis.list
apt update
apt-cache policy redis redis-server
apt install redis
redis-cli -v
ss -ltnp | grep redis
原官方源记录redis/noble 6:8.8.0-1rl1~noble1,redis-cli8.8.0;Ubuntu源另一轮为5:7.0.15-1ubuntu0.24.04.4、客户端7.0.15。冒号前6/5是Debian包epoch,不是Redis6/5。客户端版本也不证明当前运行服务端必为同版本,应另查INFO server。
原两轮监听都为127.0.0.1:6379及[::1]:6379,PID分别4745/2196,属于本地默认配置观测。
3.1.2 线程观察
pstree -p | grep redis
ps -L -p 4745 -o pid,tid,comm
原PID4745显示7个额外线程,2196显示4个。线程名称可能包含bio_close_file、bio_aof/bio_aof_fsync、bio_lazy_free、jemalloc_bg_thd等;不能把内核io_uring轮询线程名 iou-sqp-* 直接认定为Redis业务I/O线程。主线程命令执行、可配置网络I/O、后台任务、分配器线程和fork子进程是不同实体,不能用pstree花括号数量推断命令并行度。
Redis6开始的I/O线程和8.x后续演进按实际版本确认;不会因为多核上有几个辅助线程就自动让所有GET/SET并行执行。主线程CPU饱和时只加I/O线程未必解决瓶颈。
3.1.3 源码编译
源码下载:Redis releases。本课后续源码实验固定8.4.0,不是任意版本都可不改依赖与Makefile选项使用。完整模块构建和仅内核构建需要不同依赖,应查该版本INSTALL/Makefile。
apt install -y --no-install-recommends ca-certificates wget gcc g++ libc6-dev \
  libssl-dev make automake autoconf libtool build-essential pkg-config \
  libjemalloc-dev libsystemd-dev
redis_version=8.4.0
cd /usr/local/src
wget -O "redis-$redis_version.tar.gz" "https://download.redis.io/releases/redis-$redis_version.tar.gz"
# 按可信发布校验信息确认源码后再解包/编译。
tar -xf "redis-$redis_version.tar.gz"
cd "redis-$redis_version"
export BUILD_TLS=no
export BUILD_WITH_MODULES=no
export INSTALL_RUST_TOOLCHAIN=no
export DISABLE_WERRORS=yes
make -j "$(nproc)" all USE_SYSTEMD=yes
make PREFIX=/usr/local install
这些选项沿用该版本的仅内核实验,不提供TLS支持;需要TLS应按支持方式重新构建和配置,不能把“关闭TLS更快”视为生产结论。未识别的BUILD_MODULES等变量不会因写在make后就必然生效,应查看所用版本支持的变量。
原源目录有deps/modules/src/tests/utils、redis.conf、redis-full.conf、Makefile、runtest等。redis-full.conf是否加载扩展、扩展数量及打包能力随发行版/版本而变,不泛化为所有版本固定四大模块。
安装后原二进制列表:redis-server、redis-cli、redis-sentinel、redis-benchmark、redis-check-aof、redis-check-rdb。redis-check-rdb是校验工具,不是通用RDB修复工具;AOF修复也可能截断数据,后文另述。
ls /usr/local/bin/redis-*
ls utils/*.service
原模板systemd-redis_server.service和systemd-redis_multiple_servers@.service位于utils。USE_SYSTEMD用于相应构建支持,不会自动把服务安装到/etc/systemd/system;make install通常只安装相关程序。
3.1.4 前台运行和启动日志
./src/redis-server redis.conf
# 另一个独立实验,不与已占用该端口的实例混跑:
./src/redis-server --port 6380
原8.4.0单机日志分别显示6379/PID15944与6380/PID15813、Server initialized、Ready to accept connections tcp。没有配置文件不等于不读取任何持久化文件:默认工作目录及默认RDB名仍可能使它加载已有dump.rdb。原6380加载RDB,age606秒、内存约0.64MB、0个键,即是该行为。
3.2 内核内存策略与systemd
3.2.1 vm.overcommit_memory
原告警:
WARNING Memory overcommit must be enabled! Without it, a background save or
replication may fail under low memory condition.
| 值 | Linux含义 |
|---|---|
| 0 | 启发式overcommit检查,拒绝部分明显过大的承诺;不是精确检查当前空闲物理内存 |
| 1 | 允许overcommit,不按通常承诺限制拒绝分配;不代表物理内存凭空增加,实际写入仍可能OOM |
| 2 | 严格承诺限制,受swap、overcommit_ratio/overcommit_kbytes等影响;不是允许无限超过物理+swap |
Redis fork/COW场景常按官方建议选择1,仍需预留真实内存。它不会自动减少所有fork阻塞或保证永不OOM。
printf '%s\n' 'vm.overcommit_memory=1' > /etc/sysctl.d/99-redis-overcommit.conf
sysctl -p /etc/sysctl.d/99-redis-overcommit.conf
不要反复向sysctl.conf追加重复项后把任何错误输出隐藏掉。
3.2.2 单实例服务
先确认没有APT服务或其他实例占用同一端点/路径。源码单实例完整示例:
id redis
# 仅在专用账号不存在时创建:
useradd --system --home-dir /var/lib/redis --shell /usr/sbin/nologin redis
install -d -o redis -g redis -m 0750 /var/lib/redis/6379 /var/log/redis
install -d -o redis -g redis -m 0750 /etc/redis
用户已存在时先核对,不把任意useradd失败都当成“已经存在”。/etc/redis/redis-6379.conf最小配置:
bind 127.0.0.1 -::1
protected-mode yes
port 6379
daemonize no
supervised systemd
dir /var/lib/redis/6379
dbfilename dump-6379.rdb
appendonly no
logfile ""
[Unit]
Description=Redis instance 6379
Wants=network-online.target
After=network-online.target

[Service]
Type=notify
User=redis
Group=redis
WorkingDirectory=/var/lib/redis/6379
RuntimeDirectory=redis-6379
RuntimeDirectoryMode=0750
ExecStart=/usr/local/bin/redis-server /etc/redis/redis-6379.conf --supervised systemd --daemonize no
LimitNOFILE=65535
NoNewPrivileges=yes
PrivateTmp=yes
UMask=0077
TimeoutStartSec=300
TimeoutStopSec=300
Restart=on-failure
RestartSec=5
StandardOutput=journal
StandardError=journal

[Install]
WantedBy=multi-user.target
systemctl daemon-reload
systemctl enable --now redis.service
systemctl status redis.service
journalctl -u redis.service -f
daemonize no + Type=notify/supervised systemd是正常生产管理方式,不是“不适合生产的前台程序”。OOMScoreAdjust=-900不是一律必开,它会改变整机OOM牺牲对象,应按整体资源政策选择。PrivateTmp隔离服务的/tmp、/var/tmp,不等于服务看不到其他所有文件系统。
注释掉的ExecStart会被systemd忽略,不存在原文“即使注释也判定重复”的通用规则;普通notify服务应只有一个有效ExecStart,oneshot另有语义。
3.2.3 多实例模板
每个实例隔离数据目录、运行目录、日志、RDB、AOF目录和端点,不能只改端口却共用所有持久化路径:
[Unit]
Description=Redis teaching instance %i
After=network-online.target
Wants=network-online.target

[Service]
Type=notify
User=redis
Group=redis
WorkingDirectory=/var/lib/redis/%i
RuntimeDirectory=redis-%i
RuntimeDirectoryMode=0750
ExecStart=/usr/local/bin/redis-server /etc/redis/redis_server_%i.conf --supervised systemd --daemonize no
NoNewPrivileges=yes
PrivateTmp=yes
UMask=0077
Restart=on-failure
RestartSec=5

[Install]
WantedBy=multi-user.target
保存为redis@.service。准备6379/6380各自配置与目录;例如6380:
bind 127.0.0.1 -::1
protected-mode yes
port 6380
daemonize no
supervised systemd
dir /var/lib/redis/6380
dbfilename dump-6380.rdb
appendonly no
logfile ""
systemctl daemon-reload
systemctl start redis@6379
systemctl start redis@6380
systemctl status redis@6379
systemctl status redis@6380
不能让之前单实例redis.service同时占用6379。原“清理”删除整个/etc/redis、var/log目录及redis用户会影响其他实例;应先停止本实验实例、保留数据与配置,只退役明确属于该实例的资源,不清理共享用户和目录。
3.3 完整源码部署脚本
原 deploy_redis.sh 覆盖依赖、下载、编译、用户、配置、内核和服务。以下保留完整流程但限定新实验环境,修正失败继续、覆盖现有配置、隐去诊断、数据目录未隔离和配置不完整。它不是升级已有Redis的脚本。
#!/bin/bash
set -euo pipefail
umask 077
REDIS_VERSION=8.4.0
REDIS_URL="https://download.redis.io/releases/redis-$REDIS_VERSION.tar.gz"
SRC_BASE=/usr/local/src
REDIS_SRC="$SRC_BASE/redis-$REDIS_VERSION"
CONF_DIR=/etc/redis
REDIS_PORT=6379
DATA_DIR=/var/lib/redis/6379
MAIN_CONF="$CONF_DIR/redis-$REDIS_PORT.conf"
SYSTEMD_SVC=/etc/systemd/system/redis.service
RUN_USER=redis
info() { printf '[INFO] %s\n' "$*"; }
error() { printf '[ERROR] %s\n' "$*" >&2; }
[[ $EUID -eq 0 && ${REDIS_SOURCE_FRESH_LAB:-} == YES ]] || {
  error '仅适用于已确认的新实验环境,需要root和REDIS_SOURCE_FRESH_LAB=YES'
  exit 1
}
[[ ! -e $MAIN_CONF && ! -e $SYSTEMD_SVC && ! -e $DATA_DIR ]] || {
  error '实例配置/服务/数据目录已存在,拒绝覆盖或升级'
  exit 1
}
if systemctl is-active --quiet redis-server.service; then
  error '已运行软件包Redis,先明确选择部署方式,不混装占用6379'
  exit 1
fi
: "${REDIS_SOURCE_SHA256:?请先提供可信发布渠道核对过的源码SHA256}"
[[ $REDIS_SOURCE_SHA256 =~ ^[0-9a-fA-F]{64}$ ]] || exit 1
install_deps() {
  apt update
  apt install -y --no-install-recommends ca-certificates wget build-essential \
    pkg-config libssl-dev libjemalloc-dev libsystemd-dev automake autoconf libtool
}
download_extract() {
  mkdir -p "$SRC_BASE"
  cd "$SRC_BASE"
  [[ ! -e $REDIS_SRC ]] || { error '源码目录已存在,请审阅后选择新工作目录'; return 1; }
  wget -O "redis-$REDIS_VERSION.tar.gz" "$REDIS_URL"
  printf '%s  %s\n' "$REDIS_SOURCE_SHA256" "redis-$REDIS_VERSION.tar.gz" | sha256sum -c -
  tar -xf "redis-$REDIS_VERSION.tar.gz"
}
compile_install() {
  cd "$REDIS_SRC"
  export BUILD_TLS=no BUILD_WITH_MODULES=no INSTALL_RUST_TOOLCHAIN=no DISABLE_WERRORS=yes
  make -j "$(nproc)" all USE_SYSTEMD=yes
  make PREFIX=/usr/local install
}
create_user_dir() {
  if ! id "$RUN_USER" >/dev/null 2>&1; then
    useradd --system --home-dir /var/lib/redis --shell /usr/sbin/nologin "$RUN_USER"
  fi
  install -d -o redis -g redis -m 0750 "$CONF_DIR" "$DATA_DIR"
}
init_config() {
  cat > "$MAIN_CONF" <<CONF
bind 127.0.0.1 -::1
protected-mode yes
port $REDIS_PORT
daemonize no
supervised systemd
dir $DATA_DIR
dbfilename dump-$REDIS_PORT.rdb
appendonly no
logfile ""
CONF
  chown redis:redis "$MAIN_CONF"
  chmod 640 "$MAIN_CONF"
}
sysctl_optimize() {
  printf '%s\n' 'vm.overcommit_memory=1' > /etc/sysctl.d/99-redis-overcommit.conf
  sysctl -p /etc/sysctl.d/99-redis-overcommit.conf
}
config_systemd() {
  cat > "$SYSTEMD_SVC" <<UNIT
[Unit]
Description=Redis instance
After=network-online.target
Wants=network-online.target
[Service]
Type=notify
User=redis
Group=redis
WorkingDirectory=$DATA_DIR
RuntimeDirectory=redis-$REDIS_PORT
ExecStart=/usr/local/bin/redis-server $MAIN_CONF --supervised systemd --daemonize no
NoNewPrivileges=yes
PrivateTmp=yes
UMask=0077
LimitNOFILE=65535
Restart=on-failure
RestartSec=5
TimeoutStartSec=300
TimeoutStopSec=300
StandardOutput=journal
StandardError=journal
[Install]
WantedBy=multi-user.target
UNIT
  systemctl daemon-reload
  systemctl enable redis.service
}
start_and_check() {
  systemctl start redis.service
  systemctl is-active --quiet redis.service
  [[ $(/usr/local/bin/redis-cli -h127.0.0.1 -p "$REDIS_PORT" PING) == PONG ]]
  systemctl status redis.service --no-pager
  info '本机新实例启动和PING通过,尚未配置远程业务/持久化与高可用验收'
}
main() {
  install_deps
  download_extract
  compile_install
  create_user_dir
  init_config
  sysctl_optimize
  config_systemd
  start_and_check
}
main
源码SHA256须来自可信发布信息,不能把下载同一路径任意返回内容的散列当作真实性证明。构建变量、依赖和仅内核/TLS策略仍按该版本核对。脚本仅本机回环无密码新实例,后续开放远程前再配置认证/授权与访问边界,不把这个最小服务当作生产完成。
3.4 客户端、INFO与网络配置
redis-cli
redis-cli INFO
redis-cli INFO CPU
redis-cli -h127.0.0.1 -p6379 INFO CPU
原INFO样本Redis8.4.0:connected_clients1、used_memory744088字节、loading0、role master、cluster_enabled0;io_thread_0及modules/vectorset等字段是具体构建信息,不保证“仅内核”构建仍加载相同模块。CPU统计如used_cpu_sys0.268340、used_cpu_user0.370143是累计CPU秒,不是即时CPU百分比。
listener0:name=tcp,bind=127.0.0.1,bind=-::1,port=6379
role:master
cluster_enabled:0
3.4.1 port与bind
port6379是常见默认,port0可关闭普通TCP端口(TLS监听另行设置);非零端口范围1~65535。低端口权限还受能力与内核设置影响,不绝对只有root能绑定。同一监听端点不能冲突,多实例需隔离端口或绑定地址并管理所有数据路径。
bind 10.0.0.13 127.0.0.1 -::1
port 6380
-::1的减号表示地址不可用等相应场景时允许忽略,不是排除IPv6;原日志本来就显示::1监听。bind指定本地监听地址,不限制客户端必须同网段;路由/VPN/转发仍可能使其他来源到达。
systemctl restart redis.service
ss -ltnp | grep redis
redis-cli -h127.0.0.1 -p6380 INFO CPU
redis-cli -h10.0.0.13 -p6380 INFO CPU
原监听10.0.0.13:6380、127.0.0.1:6380、::1:6380;回环请求返回CPU统计,内网地址请求得到protected-mode DENIED提示。具体保护模式条件随版本和配置判断,不能把绑定内网IP理解为自动获得安全远程访问。
恢复端口只改准确配置键,不全文件替换所有6380字符串:
sed -i -E 's/^[[:space:]]*port[[:space:]]+6380[[:space:]]*$/port 6379/' /etc/redis/redis-6379.conf
systemctl restart redis.service
3.5 requirepass、ACL与配置保存
requirepass Redis@2026
protected-mode yes
Redis6后requirepass与默认ACL用户认证有关,更细权限用专用ACL用户/命令/键范围;不是一个全局密码就能给所有客户端最小权限。保持protected-mode yes并限制来源,不把设置密码说成“保护模式开关自动变no”。
CONFIG SET requirepass "Redis@2026"
AUTH Redis@2026
CONFIG REWRITE
CONFIG SET仅改变相应运行值,重启按实际配置加载;CONFIG REWRITE需要可写配置文件/目录且进程由配置文件启动等条件。未持久化时也不是重启必“无密码”,而是回到原持久配置。
新连接需符合当前认证;已经认证的连接不保证因改密码自动被踢出/立即失效,轮换需按客户端、ACL与连接管理设计。CONFIG SET当前连接也不一定必须重新AUTH才可继续,原说法过强。
redis-cli -h127.0.0.1 -p6379 INFO CPU
redis-cli -h127.0.0.1 -p6379 -a 'Redis@2026' INFO CPU
redis-cli -h10.0.0.13 -p6379 -a 'Redis@2026' INFO CPU
原无口令NOAUTH Authentication required;有口令显示CPU数据和命令行认证告警。--no-auth-warning只隐藏提示,不消除进程参数/历史中的口令:
redis-cli -a 'Redis@2026' --no-auth-warning INFO Cluster
export REDISCLI_AUTH='Redis@2026'
redis-cli INFO Cluster
unset REDISCLI_AUTH
环境变量同样需要保护,不把口令写进所有用户可读的/etc/profile.d作为默认做法。可在受控终端使用支持的交互口令选项,或由进程安全提供凭据。别名不自动进入非交互脚本。
原rename-command禁用FLUSHDB/FLUSHALL/KEYS属于旧式限制;现代优先ACL,升级兼容和复制/脚本引用要核对,不能随意重命名命令后假定所有组件正常。
3.6 daemonize、日志和持久化路径
3.6.1 前台与forking对比
systemd notify方式用daemonize no/supervised systemd;传统forking需同时正确配置Type=forking、PIDFile与权限,不能只改daemonize一行。终端前台退出是否收到HUP也依会话/管理方式,不是一律相同。
daemonize yes
supervised no
pidfile /run/redis-6379/redis.pid
[Service]
Type=forking
PIDFile=/run/redis-6379/redis.pid
ExecStart=/usr/local/bin/redis-server /etc/redis/redis-6379.conf
该片段仅作前述完整unit的对应替换对照,不是把多个有效ExecStart追加到同一notify服务。课堂后恢复notify方式,避免后续复制实验混用管理模式。
3.6.2 日志
loglevel notice
logfile ""
空logfile把相应日志送标准输出,systemd可由journald持久/集中收集,是否持久取决于日志系统配置,并非“没有日志不可回溯”。文件方式:
logfile /var/log/redis/redis-6379.log
确保目录归属、写权限和轮转。原文件约1.2KB、0600、redis属主,日志包含RDB加载和Ready信息。Redis SLOWLOG是独立的慢命令记录结构,不是一律写进这个普通日志文件。
redis-cli -a 'Redis@2026' CONFIG GET logfile
tail -n 5 /var/log/redis/redis-6379.log
原返回/var/log/redis/redis-6379.log。logfile syslog只是字面文件名,不是切换syslog的魔法值;如需syslog,使用syslog-enabled yes及ident/facility,并协调普通输出方式:
syslog-enabled yes
syslog-ident redis
syslog-facility local0
3.6.3 dir、dbfilename和多部分AOF
RDB路径为dir/dbfilename,现代Redis7+ AOF通常位于dir下的appenddirname目录,含manifest、base、incr等,不再一律只有一个appendonly.aof。
dir /data/redis/6379
dbfilename dump-6379.rdb
appendfilename appendonly-6379.aof
appenddirname appendonlydir
每实例独立dir比仅改RDB名更完整;共用目录时还会有AOF目录/manifest等冲突。改变dir或dbfilename不会自动迁移旧文件,不能先重启读到空目录后才BGSAVE就声称保留旧数据。
对于RDB实验,先生成并确认有效快照,在停止/隔离实例后备份并迁移到新路径,再改配置重启;AOF启用时按完整AOF集合和加载优先级处理,详见第4章。不能只复制一个incr文件。
原配置/生成观测:
redis-cli -a 'Redis@2026' CONFIG GET dir
redis-cli -a 'Redis@2026' CONFIG GET dbfilename
redis-cli -a 'Redis@2026' CONFIG GET appendfilename
redis-cli -a 'Redis@2026' BGSAVE
dir: /data/redis
dbfilename: dump-6379.rdb
appendfilename: appendonly-6379.aof
Background saving started
原目录同时有dump.rdb和新dump-6379.rdb,说明改名不自动移除旧文件;需核对哪个被当前配置加载。AOF由no动态改yes:
CONFIG GET appendonly
CONFIG SET appendonly yes
CONFIG GET appendonly
CONFIG REWRITE
原结果no→OK→yes,目录出现:
/data/redis/appendonlydir/
├── appendonly-6379.aof.1.base.rdb
├── appendonly-6379.aof.1.incr.aof
└── appendonly-6379.aof.manifest
manifest描述当前生效base及incr顺序,不能删改其中某份后假定其余可以自动拼出完整状态。备份还需配置、ACL/密钥及一致快照/归档策略,不是任何时候cp整个目录就必然一致。
4. Redis 持久化机制:RDB 与 AOF
4.1 RDB 持久化
4.1.1 定时快照与文件结构
RDB 保存某个时间点的数据集,是全量、紧凑的二进制快照;部分字符串可采用 LZF 压缩,它不是把整个文件压成一个压缩包。适合冷备份、迁移和允许一定恢复点间隔的业务。异常退出后,最后一个成功快照之后尚未进入其他可靠持久化介质的变更可能丢失,包括新增、修改、删除和过期状态变化。
自动快照由 save <seconds> <changes> 配置。Redis 检查距上次成功保存的时间和累计修改量,满足任一规则便尝试触发后台保存;这不是精确的滑动时间窗口。修改计数也不等于不同键的数量或客户端命令条数:同一键可反复修改,一条命令可影响多个键,无实际变更的命令可能不增加计数。
# 历史配置示例,不代表所有版本的默认值
save 900 1
save 300 10
save 60 10000

# 本讲实验实例读取到的规则
save 3600 1 300 100 60 10000

# 关闭自动 save 规则;不阻止手动 SAVE/BGSAVE 或复制需要的快照
save ""
实际值通过 CONFIG GET save 确认,不能将不同版本的配置示例混作统一默认值。除自动规则外,SAVE、BGSAVE、需要全量同步的复制流程也会生成 RDB 数据。正常 SHUTDOWN 是否保存由持久化配置和 SAVE / NOSAVE 标志决定;关机保存不是自动执行一次后台 BGSAVE。
| 组成 | 含义 |
|---|---|
| 文件头 | REDIS 魔数和四字节 RDB 格式版本号;格式版本不等于 Redis 服务版本,AUX 元数据可另含 redis-ver |
| 元数据和数据库块 | 数据库选择、键值编码、过期时间等;普通实例数据库数量可配置,默认常见为 16,Cluster 只支持 DB 0 |
| EOF | 0xFF 结束标记 |
| 校验尾部 | CRC64 校验槽;关闭 rdbchecksum 时可写零值,并非简单删除这八字节 |
BGSAVE 的主要过程:主进程 fork(),子进程基于该时刻的地址空间生成临时文件,写入成功后原子重命名为配置的 RDB 文件。临时名通常类似 temp-<pid>.rdb,不应依赖讲义中的固定 dump.rdb.tmp。旧快照在替换前仍保留;磁盘、文件系统或电源故障仍要求备份和恢复验证。
fork() 不立即复制全部数据页,但需要复制页表,期间主线程暂停。之后父子进程通过 COW 隔离被修改的页。主线程继续接收请求,仍会受到内存、CPU、磁盘竞争和 COW 的影响,不能理解为“完全无阻塞、没有性能代价”。写入频繁时额外内存可能很大。
# 单实例示例
 dir /var/lib/redis/6379
 dbfilename dump-6379.rdb
目录与文件名共同决定路径。多实例优先各用独立数据目录,同时隔离 AOF 目录、端口和运行目录。修改配置不会迁移旧文件。Redis 运行账户必须有目录访问及创建、重命名文件的权限。
4.1.2 SAVE 与 BGSAVE
| 项目 | SAVE | BGSAVE |
|---|---|---|
| 执行者 | 主进程同步执行 | fork 后子进程执行 |
| 业务影响 | 整个保存过程阻塞命令处理 | fork 暂停及后续资源竞争 |
| 落盘 | 临时文件写完后替换目标 | 临时文件写完后替换目标 |
| 用途 | 小型离线测试、特定维护场景 | 常规手动/自动快照 |
同时只能有一个 RDB 后台保存任务;与 AOF 重写的调度也存在限制。重复 BGSAVE 可能报错,部分情形可用 BGSAVE SCHEDULE 排队,须按实际版本确认。
以下沿用原实验的独立练习实例 /data/redis,与第 3 章推荐目录不是同一套可直接混用的配置。已有数据迁移必须先完成一致性备份和文件迁移,不能改目录后直接重启期待自动搬移。
# /etc/redis/redis-6379.conf:本章实验配置
 dir /data/redis
 dbfilename dump-6379.rdb
 appendonly no
# 仅在已准备好的实验实例中,交互输入认证值
read -rsp 'Redis password: ' REDISCLI_AUTH; echo
export REDISCLI_AUTH
redis-cli SET nihao 123456
redis-cli GET nihao
redis-cli BGSAVE
redis-cli INFO persistence
redis-check-rdb /data/redis/dump-6379.rdb
原实验返回 OK、"123456" 和 Background saving started。后台保存完成后观察:
rdb_changes_since_last_save:0
rdb_bgsave_in_progress:0
rdb_last_save_time:1781591498
rdb_last_bgsave_status:ok
rdb_last_bgsave_time_sec:1
rdb_current_bgsave_time_sec:-1
rdb_saves:3
rdb_last_cow_size:344064
该次 RDB 为 105 字节,redis-check-rdb 报告 1 个键、0 个带过期时间的键。此工具只校验,不修复损坏的 RDB;损坏时应使用可靠备份恢复或专门的数据抢救流程。
| 指标 | 正确解释 |
|---|---|
rdb_changes_since_last_save |
尚未由成功保存覆盖的修改计数;fork 后新变更仍需保留,不是 fork 当刻无条件清零 |
rdb_bgsave_in_progress |
是否有后台快照运行 |
rdb_last_save_time |
上次成功保存的 Unix 时间 |
rdb_last_bgsave_status |
上次后台保存结果 |
rdb_last_bgsave_time_sec |
上次后台保存的耗时,0 可表示不足一秒;不是距完成多久 |
rdb_current_bgsave_time_sec |
当前后台保存耗时,未运行时通常为 -1 |
rdb_last_cow_size |
上次后台保存的 COW 字节数,不能单独证明文件可恢复 |
Background saving started 仅表示任务受理,不能据此立即复制或认定快照成功。应等待任务结束、确认状态,并对备份文件校验和做恢复演练。
4.1.3 自动快照实验
原讲义先执行 FLUSHALL 和 BGSAVE,生成 88 字节的空快照,再写入测试数据。FLUSHALL 会清空所有逻辑库,这一步只属于专用空实验实例的重置记录。
# 原实验的批量写入,不能用于共享实例
for i in $(seq 1 10200); do
    redis-cli SET "high$i" "$i" >/dev/null
done
redis-cli CONFIG GET save
redis-cli INFO persistence
redis-check-rdb /data/redis/dump-6379.rdb
原规则为 3600 1 300 100 60 10000。自动快照校验显示 10006 个键、文件 128945 字节;随后的指标为:
rdb_changes_since_last_save:194
rdb_bgsave_in_progress:0
rdb_last_bgsave_status:ok
rdb_last_bgsave_time_sec:0
rdb_last_cow_size:434176
10200 − 10006 = 194,说明快照捕获的时刻早于全部写入结束,后续 194 次变更尚未进入该快照。随后手动 BGSAVE,待成功后校验得到 10200 个键。该数量是原实验观察值,不能据规则预测每次恰好保存 10006 个键。
原实验以 KEYS "high*" | wc -l 得到 10200。KEYS 扫描整个键空间,可能阻塞大型实例。下面完整保留“统计匹配键”的目的,改用游标和 JSON 解析,避免原脚本用换行拆分键名的错误。
#!/usr/bin/env bash
# get_key_count.sh:只读扫描,需支持 --json 的 redis-cli 和 Python 3
set -euo pipefail
pattern=${1:-high*}
host=${REDIS_HOST:-127.0.0.1}
port=${REDIS_PORT:-6379}
db=${REDIS_DB:-0}
REDIS_SCAN_PATTERN="$pattern" python3 - "$host" "$port" "$db" <<'PY'
import json
import os
import subprocess
import sys
host, port, db = sys.argv[1:]
base = ['redis-cli', '-e', '-h', host, '-p', port, '-n', db, '--json']
cursor = '0'
seen = set()
while True:
    raw = subprocess.check_output(
        base + ['SCAN', cursor, 'MATCH', os.environ['REDIS_SCAN_PATTERN'],
                'COUNT', '1000'], text=True)
    reply = json.loads(raw)
    if not isinstance(reply, list) or len(reply) != 2:
        raise SystemExit('SCAN 返回格式异常')
    cursor, keys = str(reply[0]), reply[1]
    if not isinstance(keys, list) or not all(isinstance(k, str) for k in keys):
        raise SystemExit('本脚本仅支持 redis-cli JSON 可无损表示的文本键名')
    seen.update(keys)
    if cursor == '0':
        break
print(len(seen))
PY
该脚本对文本键名去重,保存完整名称,因此空格和换行不再产生额外“键”。它消耗与匹配键数量相关的客户端内存;COUNT 是提示值,一次可能返回零个或超过 1000 个键。扫描不是时间点快照,遍历期间新增、删除的键会影响结果;任意二进制键应使用支持二进制协议的客户端处理。
原 test_rdb_save.sh 把 10 1 10 100 20 1000 同时配置后,分别写 1、100、1000 条并等待,均看到 dirty 为 0。由于规则是 OR,10 1 已能覆盖后三组,不能据此证明 100 和 1000 的阈值分别生效。以下改为逐条规则独立测试,保存并恢复实际原配置,不清空共享实例,也不恢复猜测的“默认值”。仍只用于明确指定的专用实验实例。
#!/usr/bin/env bash
# test_rdb_save.sh:会临时修改 save 规则并写入独立前缀测试键
set -euo pipefail
[[ ${REDIS_DEDICATED_LAB:-} == YES ]] || {
    echo '仅用于专用实验实例,需显式设置 REDIS_DEDICATED_LAB=YES' >&2
    exit 1
}
cli=(redis-cli -e -h "${REDIS_HOST:-127.0.0.1}" -p "${REDIS_PORT:-6379}" --raw)
original_save=$("${cli[@]}" CONFIG GET save | sed -n '2p')
prefix="rdb_rule_lab:$(date +%s):$$:"
get_field() {
    "${cli[@]}" INFO persistence | tr -d '\r' | awk -F: -v k="$1" '$1==k {print $2}'
}
wait_idle() {
    local i
    for ((i=0; i<120; i++)); do
        [[ $(get_field rdb_bgsave_in_progress) == 0 ]] && return 0
        sleep 1
    done
    echo '等待 BGSAVE 超时' >&2
    return 1
}
cleanup() {
    local rc=$?
    trap - EXIT
    "${cli[@]}" CONFIG SET save "$original_save" >/dev/null || rc=1
    # 保留带 TTL 的测试键及输出供复核,不调用 FLUSHALL。
    exit "$rc"
}
trap cleanup EXIT
wait_idle
for rule in '10 1' '10 100' '20 1000'; do
    read -r seconds changes <<< "$rule"
    "${cli[@]}" CONFIG SET save '' >/dev/null
    "${cli[@]}" BGSAVE | grep -q 'Background saving started'
    wait_idle
    [[ $(get_field rdb_last_bgsave_status) == ok ]] || exit 1
    baseline=$(get_field rdb_saves)
    "${cli[@]}" CONFIG SET save "$rule" >/dev/null
    for ((i=1; i<=changes; i++)); do
        "${cli[@]}" SET "${prefix}${changes}:$i" "$i" EX 3600 >/dev/null
    done
    completed=0
    for ((i=0; i<seconds+120; i++)); do
        saves=$(get_field rdb_saves)
        if [[ $saves =~ ^[0-9]+$ ]] && (( saves > baseline )) &&
           [[ $(get_field rdb_bgsave_in_progress) == 0 ]] &&
           [[ $(get_field rdb_last_bgsave_status) == ok ]]; then
            completed=1
            break
        fi
        sleep 1
    done
    (( completed == 1 )) || { echo "规则 $rule 未在期限内成功保存" >&2; exit 1; }
    printf 'rule=%s, dirty=%s, saves=%s\n' "$rule" \
        "$(get_field rdb_changes_since_last_save)" "$(get_field rdb_saves)"
done
即使隔离实验中测试结果符合预期,也只能说明该轮实例满足规则并完成保存;调度、其他写入和过期删除都会影响时间与 dirty。无需在生产实例用该实验验证基本机制。
4.1.4 RDB 运维要点
快照前检查磁盘空间、目录权限、fork 耗时、COW 与内存余量。讲义提出单实例 10–20 GB、预留 50% 内存等经验值,这些不是 Redis 的硬限制,应该按键值规模、写入率、后台任务和实测峰值决定分片与容量。THP、内核 overcommit 和磁盘性能影响 fork 与写盘;设置 vm.overcommit_memory=1 有助于避免严格的虚拟内存预检查拒绝 fork,但不会防止物理内存不足和 OOM。
低峰执行快照,监控失败状态、耗时趋势、频率和可用空间;30 秒只能作为示例告警阈值。将已完成的 RDB 加权限保护后备份到独立存储,保留周期按恢复需求决定。复制节点不是历史备份,错误删除也会复制。无磁盘复制减少某些复制路径的落盘,不会替代持久化和备份。新版 RDB 不能假定可由旧版 Redis 读取,迁移须实际验证兼容性。
4.2 AOF 持久化
4.2.1 写命令日志与恢复
AOF 将需要传播的状态变更编码追加到日志。只读 GET、HGET、INFO 不作为数据变更日志。命令可能经过重写,例如相对过期转换为绝对时间,过期删除也可能生成 DEL;并非逐字照抄全部客户端请求。重写后的文件只表达当前有效状态,不保留全部历史。
主要路径为 aof_buf(进程内)→ write()(内核页缓存)→ 按策略 fsync / fdatasync(请求持久化)。进程崩溃不等于页缓存丢失;断电或内核故障可能丢失未刷盘内容。磁盘、控制器、文件系统是否正确兑现刷盘同样影响可靠性。不能把每步都概括为“响应后才执行”或“fsync 后永久绝对不会丢”。
SET name wss 的 RESP 示意如下;实际协议行尾是 CRLF,长度以字节计算。
*3
$3
SET
$4
name
$3
wss
*3 是三元素数组,$3 是后续字符串长度为三字节。纯文本 AOF 可检查协议内容,但不能随意按文本行裁剪;混合基底含二进制数据。
恢复选择:启用 AOF 时按 AOF 持久化集加载;未启用 AOF 时按独立 RDB 加载。AOF 损坏不会自动降级读取独立 dump.rdb,否则会掩盖已确认写入的数据损失。空数据目录可初始化为空库;缺失清单引用的文件、格式损坏等不能当作“正常空库”。两种持久化都关闭时,普通重启没有磁盘数据可恢复。
AOF 格式与版本须区分:
| 类型 | 文件与恢复方式 |
|---|---|
| 较早的单文件纯 AOF | 一个文件中依序重放 RESP 命令 |
| 较早的单文件混合 AOF | 文件头为 RDB 基线,其后为增量命令 |
| Redis 7+ 多段 AOF | manifest 指定 base 与按序加载的一个或多个 incr 文件;基底可为 RDB 或 AOF |
本课 Redis 8.4 使用第三种。appenddirname 指定 AOF 子目录名,多段机制来自版本设计,不是仅配置了该参数才从旧机制切换。不要把旧版单文件的“重写缓冲区末尾合并”流程直接套到新版多段 AOF。
# 本章独立实验配置
 dir /data/redis
 appendonly no
 appendfilename "appendonly-6379.aof"
 appenddirname "appendonlydir"
 appendfsync everysec
 aof-load-truncated yes
 aof-use-rdb-preamble yes
 aof-timestamp-enabled no
 aof-rewrite-incremental-fsync yes
aof-timestamp-enabled 控制可用于按时间截断恢复的时间戳注释,不应理解为每条写命令必有一个时间戳;aof-rewrite-incremental-fsync 控制重写文件分段刷盘。
redis-cli CONFIG GET appendonly
redis-cli CONFIG SET appendonly yes
redis-cli CONFIG GET appendonly
redis-cli INFO persistence
ls -l /data/redis/appendonlydir/
原实验从 no 切换为 yes,随后文件结构如下。启用 AOF 会安排建立基底,必须检查重写、写入状态后再认为它可靠。不保留原讲义先 rm -rf appendonlydir 的做法:现有 AOF 可能是唯一可靠数据,开启功能并不要求先删除它。
/data/redis/
├── appendonlydir
│   ├── appendonly-6379.aof.2.base.rdb
│   ├── appendonly-6379.aof.2.incr.aof
│   └── appendonly-6379.aof.manifest
└── dump-6379.rdb
启动读 manifest,加载指定 base,再按清单顺序重放所有有效 incr,之后接受普通读写。不能只凭文件序号猜测有效文件,也不能只备份 base 或最新一个 incr。独立 dump-6379.rdb 可作为另外的备份来源,不是损坏 AOF 的自动回退文件。
动态配置仅影响运行态;长期启用可修改实际启动配置,或在确认允许重写时执行 CONFIG REWRITE 并验证配置文件。
appendonly yes
redis-cli CONFIG REWRITE
redis-cli CONFIG GET appendonly
原实例开启后的部分持久化指标:
aof_enabled:1
aof_rewrite_in_progress:0
aof_rewrite_scheduled:0
aof_last_rewrite_time_sec:-1
aof_current_rewrite_time_sec:-1
aof_last_bgrewrite_status:ok
aof_rewrites:0
aof_rewrites_consecutive_failures:0
aof_last_write_status:ok
aof_last_cow_size:0
aof_current_size:15058
aof_base_size:15058
aof_pending_rewrite:0
aof_buffer_length:0
aof_pending_bio_fsync:0
aof_delayed_fsync:0
字段是否存在取决于版本。aof_current_size 是当前持久化日志规模;aof_base_size 是用于计算增长比例的重写基准规模,不能永远解释为当前磁盘 .base.rdb 文件的字节数。aof_delayed_fsync 是延迟刷盘累计事件;不要依赖讲义中并非普遍提供的 aof_last_fsync 字段。
4.2.2 写入与重写实验
# redis-cli 中:该 Lua 会占用命令执行线程,只限隔离实验
EVAL "for i=1,5000 do redis.call('SET','demo_aof_'..i,math.random(1,9999)) end" 0
无显式返回值的 Lua 返回 (nil),不代表失败。原观察:
aof_current_size:228447

# 重写前文件大小
15058  appendonly-6379.aof.2.base.rdb
213389 appendonly-6379.aof.2.incr.aof
112    appendonly-6379.aof.manifest
redis-cli BGREWRITEAOF
redis-cli INFO persistence
ls -l /data/redis/appendonlydir/
原命令返回 Background append only file rewriting started,完成后:
103884 appendonly-6379.aof.3.base.rdb
0      appendonly-6379.aof.3.incr.aof
115    appendonly-6379.aof.manifest
重写根据内存有效状态生成新基底,不读取并逐行压缩旧日志。即使每个键只写一次,RDB 编码也可能使文件变小;原操作实际是写 5000 个不同键,不能全部归因于“同一键重复 SET 被合并”。如存在 SET num 1、SET num 2、DEL num、SET num 10,重写仅需表达最终的 num=10 状态;复杂集合可能需要多条命令分批表达,并非每个键恰好一条命令。
Redis 7+ 重写时切换新的增量文件接收后续写入,后台子进程生成新 base,完成后更新 manifest 并清理不再需要的历史文件。fork 和 COW 仍有代价。恢复由新 base 加清单所列 incr 组成,不要求 incr 为零,也不应手工删除旧文件来“帮助”重写。
4.2.3 AOF 截断故障与修复
原实验先 FLUSHALL、BGSAVE、BGREWRITEAOF 清空数据,得到 88 字节 base、0 字节 incr。这是破坏性专用实验,不属于生产修复步骤。BGSAVE 与重写还应等待和检查任务结果,不能假定连续调用必定立即同时受理。
设置 aof-load-truncated no 后,新写入:
SET test1 111
SET test2 222
SET test3 333
SET test4 444
SET test5 555
原新增日志 188 字节。讲义描述“截断 150 字节”、实际表达式减 100、随后显示 38、工具又显示 88 字节,这些记录互相矛盾。修复后剩哪些键依赖截断位置,不能从该矛盾记录确定。下面保留故障复现目的,改为离线副本,不在 Redis 正在写入的文件上 truncate。
# 已停服并完成一致性备份后,选择其中一个用于演示的增量文件副本。
# 不把下面的演示副本当作可直接启动的完整 AOF 集。
set -euo pipefail
source_incr=/offline-backup/appendonlydir/appendonly-6379.aof.4.incr.aof
lab_dir=$(mktemp -d /tmp/redis-aof-truncate.XXXXXX)
cp -- "$source_incr" "$lab_dir/demo.incr.aof"
size=$(stat -c %s "$lab_dir/demo.incr.aof")
(( size > 0 )) || { echo '增量文件为空,无法截断演示' >&2; exit 1; }
truncate -s "$((size - 1))" "$lab_dir/demo.incr.aof"
redis-check-aof "$lab_dir/demo.incr.aof"
检测失败是预期。对真实故障应先停止自动重启、保留原始文件与日志、备份整个 AOF 集,并使用与服务版本一致的工具。多段 AOF 应以 manifest 为入口检查整套文件;修复会删除不完整尾部及其后无法安全恢复的内容,不能找回它们。
# 仅对离线故障集的工作副本执行,交互确认工具报告的数据损失范围
redis-check-aof /offline-working-copy/appendonlydir/appendonly-6379.aof.manifest
redis-check-aof --fix /offline-working-copy/appendonlydir/appendonly-6379.aof.manifest
原失败日志包含:
DB loaded from base file appendonly-6379.aof.4.base.rdb: 0.001 seconds
Unexpected end of file reading the append only file appendonly-6379.aof.4.incr.aof.
Make a backup of your AOF file, then use ./redis-check-aof --fix <filename.manifest>.
Alternatively you can set the 'aof-load-truncated' configuration option to yes and restart the server.
aof-load-truncated yes 可接受最后增量文件末尾的截断,在允许的情况下忽略不完整尾部并记录告警;它不是任意中段损坏或损坏基底的通用自动修复。no 会在这类尾部不完整时拒绝启动,便于明确处理数据损失。更改运行态配置后若要重启生效,仍须同步实际配置文件。
修复后启动前检查工作副本、文件权限与清单完整性;启动后校验关键键、数量和应用行为,并重新建立可靠持久化和备份。正常关闭通常会尝试落盘;磁盘错误、关闭失败等情况下不能承诺一定无损。
4.2.4 appendfsync 三种策略
| 策略 | 行为 | 性能与损失边界 |
|---|---|---|
always |
每次写入批次同步请求刷盘,成功后再响应相关写请求 | 延迟较高;在存储正确兑现持久化的前提下提供最强本地保证,仍不保证异步复制故障切换零丢失 |
everysec |
通常由后台任务约每秒刷盘 | 常见故障窗口约一秒;慢盘、任务延迟和特殊配置可扩大窗口,也可能导致主线程写入停顿,不能承诺永不阻塞 |
no |
Redis 不主动按 AOF 策略 fsync,依赖操作系统调度 | 通常吞吐较好;掉电窗口取决于内核和存储,不能设为固定秒数 |
CONFIG GET appendfsync
CONFIG SET appendfsync always
CONFIG SET appendfsync everysec
CONFIG SET appendfsync no
INFO persistence
kill -9 杀进程不直接清空系统页缓存;掉电和内核崩溃的影响不同。everysec 的“一秒”是常规运行预期,不是所有故障情形的严格上限。金融业务的可靠账务需要适合其一致性、复制和持久化要求的完整设计,不能靠一句 always 配置承诺零丢失。
4.2.5 重写条件与混合持久化
auto-aof-rewrite-percentage 100
auto-aof-rewrite-min-size 64mb
aof-use-rdb-preamble yes
自动重写需要满足最小规模和相对重写基准的增长比例,并且后台任务调度允许。示例中基准为 80 MB、增长比例 100%,约增至 160 MB 且超过 64 MB 后具备触发条件,具体发生时刻由后台检查决定。比例为 0 可关闭自动比例重写,但不禁止手动重写。
混合 AOF 以 RDB 格式保存基底,再以 AOF 保存增量。旧版可在同一文件中放 RDB 前缀和命令;本课新版是 .base.rdb 与 .incr.aof 配合 manifest。它不依赖独立 dump.rdb 才能恢复,也不等于“先恢复任意 dump 再加载任意 AOF”。启用 aof-use-rdb-preamble 影响新生成基底的格式,不会就地把每条新命令都改成 RDB。
| 维度 | 独立 RDB | 纯命令 AOF | 混合多段 AOF |
|---|---|---|---|
| 恢复依据 | 最后成功快照 | 有效命令序列 | manifest 指向的 RDB 基底及有序增量 |
| 体积 | 通常紧凑 | 未重写时可能膨胀 | 基底通常较紧凑,增量仍需控制 |
| 启动时间 | 通常较快 | 与命令数量和复杂度有关 | 通常减少大段历史命令重放 |
| 数据损失窗口 | 最后快照以后的未持久化状态 | 受刷盘、故障和存储影响 | 同样受 AOF 刷盘、故障和存储影响 |
| 备份 | 复制已成功完成的快照 | 获得一致日志副本 | 获得清单和其引用文件的一致集合 |
同时启用独立 RDB 与 AOF 可兼顾历史快照备份和较小常规恢复窗口,但具体方案取决于数据是否可重建、恢复时间、磁盘与延迟预算。混合模式通常能改善 AOF 加载速度和体积,不能消除备份需求,也不能把所有故障的数据损失严格限制在一秒。
5. Redis 基础命令与性能测试
5.1 redis-cli 连接与输出
redis-cli [-h 主机] [-p 端口] [-a 密码] [-n 数据库] [命令 参数...]
默认主机127.0.0.1、端口6379,非Cluster实例常配置16个逻辑库(0–15),实际数量由配置决定;Cluster只支持DB0。requirepass不是唯一认证方式,ACL账号还要提供用户名。
redis-cli
redis-cli -h 192.168.1.100 -p 6379
redis-cli -h 192.168.1.100 -p 6379 -a '${REDIS_PASSWORD}56'
# 支持该选项的客户端可交互询问口令
redis-cli -h 192.168.1.100 -p 6379 --askpass
redis-cli -h 127.0.0.1 -p 6379 -n 3
redis-cli --raw
redis-cli -c -h 192.168.1.100 -p 7001
也可连接后执行 AUTH 密码 或 AUTH 用户名 密码,但交互AUTH并不自动消除终端、历史或明文传输风险。--raw取消格式化转义;-c处理Cluster重定向,不会让所有命令变成跨节点全局操作。
提示符出现只说明客户端进入交互,不证明已认证或具备业务权限。用PING/实际所需命令确认;WRONGPASS表示账号/口令或用户状态等问题,NOAUTH表示尚未认证,Connection refused/timeout排查地址、监听和网络。bind并不是来源防火墙,远程端点要限制访问并按需要使用TLS。
5.2 通用键与生命周期
| 命令 | 含义/返回 |
|---|---|
| SET key value [EX seconds] [NX|XX] | 写字符串;NX只在不存在时写,XX只在存在时写;成功OK,不满足条件通常nil |
| GET key | 获取字符串,不存在nil,错误类型WRONGTYPE |
| EXISTS key [key...] | 返回参数中存在键的计数;重复传入同一个存在键也会重复计数 |
| DEL key [key...] | 删除键,返回实际删除数;复杂对象同步回收可能耗时 |
| EXPIRE key seconds | 设置秒级有效期;成功1,不存在或附加条件不满足0 |
| TTL key | 剩余秒数,可能0;-1存在无有效期,-2不存在 |
| PERSIST key | 清除有效期;实际移除1,不存在或原无有效期0 |
原电话键完整实验:
SET phone 13800138000
EXISTS phone
GET phone
DEL phone
EXISTS phone
依次OK、1、"13800138000"、1、0。有效期实验:
SET verify_code 668899
EXPIRE verify_code 120
TTL verify_code
PERSIST verify_code
TTL verify_code
EXPIRE verify_code 60
TTL verify_code
DEL verify_code
TTL verify_code
原TTL先115,PERSIST后-1,再设60后观察48,删除后-2;剩余秒数随等待变化。EXPIRE的条件选项/返回要按版本核对;未带KEEPTTL等选项的普通SET覆盖通常清除旧TTL,原子 SET key value EX 120 可避免先写再设过期的故障窗口。
5.2.1 KEYS 与 SCAN
KEYS *
KEYS user*
KEYS user?
KEYS一次扫描并返回全部匹配结果,可能阻塞和产生大响应,以上仅供小规模隔离实验。*匹配任意长度,?匹配一个字符,另有字符集合等glob模式。在Shell中传模式要加引号,避免本地文件名展开。
SCAN 0 MATCH user* COUNT 100
SCAN 28 MATCH user* COUNT 100
28只是上一轮可能返回的游标,不能固定写入程序。首次游标0,持续传回新游标,直到服务端返回0;返回空数组但游标非0仍需继续。COUNT是正整数工作量提示,不限制返回条数,也不是Cluster的16384槽位数量。它与内部哈希表迭代相关,不应让业务依赖游标的二进制含义。
原数据和观测:
SET user_01 tom
SET user_02 jack
SET order_001 2026
SET order_002 888
KEYS *
KEYS user*
SCAN 0 MATCH user* COUNT 50
SCAN 0 COUNT 100
原库还已有test1,KEYS共5项;user*得到user_01/user_02。小库SCAN一次返回游标0和匹配结果。另一轮COUNT2:
| 输入游标 | 返回游标 | 原返回键 |
|---|---|---|
| 0 | 5 | order_001、test1 |
| 5 | 7 | user_01、order_002、user_02(三项,超过COUNT2) |
| 7 | 0 | 空数组,结束 |
SCAN不是固定页码或一致性快照,可能重复;完整迭代期间一直存在的键应能返回,期间变化的键是否返回没有相同保证。每次仍占用服务端工作,COUNT过大/频率过高也可影响业务,不能宣称绝不阻塞。Cluster需遍历每个实际主节点,迁槽和拓扑变化还要处理遗漏/重复。
5.2.2 SELECT、FLUSHDB 与 FLUSHALL
SELECT 1
FLUSHDB ASYNC
FLUSHALL ASYNC
SELECT1切DB1,提示符常变为[1];FLUSHDB只清当前逻辑库,FLUSHALL清当前实例全部逻辑库。Cluster不会因在一个节点执行就清掉全部分片。原不加参数的同步/异步行为还受版本与lazyfree-lazy-user-flush配置影响;支持时用SYNC明确同步,ASYNC把主要释放工作交后台,不保证所有业务绝无延迟,也不降低数据删除范围。
以下是有意清空的独立实验,不在业务实例执行:
SELECT 1
SET user_02 lisi
SET order_002 10002
KEYS *
SELECT 0
FLUSHDB ASYNC
KEYS *
SELECT 1
KEYS *
SELECT 0
SET nihao 111
SET nihao1 222
KEYS *
FLUSHALL ASYNC
KEYS *
SELECT 1
KEYS *
原DB1最初2键;FLUSHDB0后DB0空而DB1仍2键;FLUSHALL后两库均空。异步释放中的新写入不等于都被当前批次一起删除。普通业务账号不授予全库清空权限;SCAN+批量删除也有相同数据权限与误删问题,不能用来绕过授权。要按业务范围删除时使用受限键前缀、分批和明确的删除目标,而非把“无FLUSH权限”理解为随意清空的理由。
5.3 String 操作
5.3.1 批量写入与读取
MSET username jack age 22 address Beijing
MGET username age address
SET username jack
SET age 22
SET address Beijing
MSET在服务端作为单个命令处理,重复键以后面的值为准,覆盖旧值并清除其TTL;MGET按输入顺序返回,缺失或非String位置为nil。MSETNX仅在所有目标键都不存在时批量写入。Cluster多键命令通常要求同槽,不是任意键均可一条写入。
MSET id 1001 name Alice gender female score 95
MGET id name gender score
MGET name email score
原输出分别为1001/Alice/female/95,以及Alice/nil/95。命令批量减少往返,不表示任意大批都性能好;按实际字节量、延迟与内存控制,而非把100条当通用界限。
5.3.2 文本、字节与原子替换
| 命令 | 作用 |
|---|---|
| STRLEN key | value字节数,不存在0 |
| APPEND key text | 尾部追加,键不存在则创建String,返回新字节数 |
| GETSET key value | 返回旧String并设置新值,缺失返回nil;旧TTL被清除 |
| SET key value GET | 新版替代GETSET的入口,其他选项仍按语义组合 |
SET title Redis教程
STRLEN title
SET num 12345
STRLEN num
STRLEN test_key
SET msg Hello
APPEND msg " World"
STRLEN msg
GET msg
APPEND log "2026-06-16 操作日志"
GET log
SET count 10
GETSET count 0
GET count
GETSET nickname lily
GET nickname
UTF-8的“Redis教程”为5+3+3=11字节,;num长5、缺失test_key长0。msg追加后11字节,值Hello World;count的GETSET返回旧10,新值0;新nickname的GETSET返回nil,新值lily。单次原子替换不能直接当作完整分布式锁协议。
原中文实验:
SET content 基础文字
STRLEN content
APPEND content "--补充说明"
STRLEN content
GETSET content "全新文本内容"
GET content
前四步为OK、12、26、26;GETSET返回“基础文字--补充说明”,新GET为“全新文本内容”。普通CLI可能显示UTF-8字节转义,不代表数据损坏,可通过 redis-cli --raw 查看原文本。汉字常为3字节,但并非所有Unicode字符都3字节。APPEND保留已有TTL,不能用GETSET规则推断它也清除TTL;超大字符串增长仍需限制。
5.3.3 整数运算
INCR/DECR分别加/减1,INCRBY/DECRBY按有符号整数步长运算。不存在按0开始,值必须可表示为合法64位有符号整数;浮点/非整数或溢出报错,不能把任意“看起来是数字”的字符串当作有效整数。
SET order_num 100
INCR order_num
INCR order_num
INCRBY order_num 10
DECR order_num
DECRBY order_num 5
GET order_num
依次OK、101、102、112、111、106、"106"。INCRBY也允许负增量;原“只能支持正数”不准确。单命令原子不等于跨命令的业务订单流程原子。
5.4 List 操作
5.4.1 入队、范围与索引
| 命令 | 用法和返回 |
|---|---|
| LPUSH/RPUSH key value [value...] | 头部/尾部依次插入,返回新长度 |
| LRANGE key start stop | 含结束索引的范围查询;0为头部,-1为尾部 |
| LLEN key | 元素数,不存在0 |
| LINDEX key index | 单索引读取,越界nil |
| LSET key index value | 覆盖位置;越界报index out of range,不存在报no such key |
LPUSH list_head_demo a b c
RPUSH list_tail_demo x y z
RPUSH list_order order01 order02 order03
LRANGE list_order 0 -1
LPUSH list_order order00
LRANGE list_order 0 -1
LPUSH list_order A B
LRANGE list_order 0 -1
新建list_head_demo顺序c/b/a,list_tail_demo为x/y/z。list_order长度3→4→6,最终B/A/order00/order01/order02/order03。多值LPUSH最后一个值最靠左,RPUSH保留书写顺序。
以下假设list_demo最初不存在,不与其他小节同名历史数据混用:
RPUSH list_demo A B C D E
LLEN list_demo
LLEN no_list
LINDEX list_demo 0
LINDEX list_demo 2
LINDEX list_demo -1
LINDEX list_demo -2
LINDEX list_demo 99
LRANGE list_demo 0 -1
LRANGE list_demo 1 3
LRANGE list_demo 3 99
LSET list_demo 2 C_Update
LRANGE list_demo 0 -1
LSET list_demo 99 test
LSET empty_list 0 123
长度5/0;索引结果A/C/E/D/nil;区间分别ABCDE、BCD、DE;修改后A/B/C_Update/D/E;最后两条分别越界与无键错误。LRANGE越界截取已有范围,不会因上界99直接报错;全量读取大列表仍可能耗时。
5.4.2 弹出、按值删除与裁剪
LPOP key [count]
RPOP key [count]
LREM key count value
LTRIM key start stop
单个LPOP/RPOP返回头/尾元素并删除,不存在nil;count参数的支持和返回形态按版本。LREM的count>0从头删最多count个匹配值,<0从尾删最多绝对值个,=0删全部匹配值,返回删除数量。LTRIM仅保留含边界的区间,其他元素删除。
RPUSH list_del A B A C A D E
LRANGE list_del 0 -1
LPOP list_del
RPOP list_del
LPOP no_list
RPOP no_list
LREM list_del 2 A
LRANGE list_del 0 -1
原长度7;弹出A/E后B/A/C/A/D,no_list两次nil;LREM删2后B/C/D。
原接着“重新初始化”直接RPUSH会追加到B/C/D之后,无法得到声称的7项。为复现反向删除阶段,显式重置这个专用实验键:
DEL list_del
RPUSH list_del A B A C A D E
LREM list_del -2 A
LRANGE list_del 0 -1
LREM list_del 0 A
LRANGE list_del 0 -1
LTRIM list_del 1 2
LRANGE list_del 0 -1
反向删2后A/B/C/D/E,再删全部A返回1后B/C/D/E;LTRIM1–2后C/D。删除最后一个元素会移除整个List键。所有重置仅用于此隔离实验。
5.5 Set 操作
Set成员唯一、无业务排序。SADD返回实际新增数;SREM返回删除数,缺失成员忽略;SISMEMBER存在1否则0;SCARD返回数量;SMEMBERS返回全量成员,超大集合应按需用SSCAN等分批访问。
SADD user_set zhangsan lisi wangwu zhangsan
SMEMBERS user_set
SCARD user_set
SISMEMBER user_set lisi
SRANDMEMBER user_set 2
SREM user_set wangwu zhaoliu
SRANDMEMBER不删除;正count最多返回count个不同成员,负count允许重复抽取并返回绝对值个;不是每次随机抽取就能保证业务公平或不可预测。
SADD student_set tom jerry jack tom lucy
SMEMBERS student_set
SCARD student_set
SISMEMBER student_set jack
SISMEMBER student_set mike
SRANDMEMBER student_set 2
SREM student_set jack lucy
SMEMBERS student_set
原新增4、数量4,jack存在1/mike0,随机示例jerry/lucy,删2后只剩tom/jerry;显示顺序不固定。多个竞争消费者/抽奖需以实际原子取走或业务约束实现,随机读取后再删并非整体原子。
5.5.1 交集、并集与差集
SADD class1 tom jerry jack lucy
SADD class2 jack lucy mike lily
SUNION class1 class2
SINTER class1 class2
SDIFF class1 class2
SDIFF class2 class1
并集为tom/jerry/jack/lucy/mike/lily;交集jack/lucy;正向差集tom/jerry,反向mike/lily。SINTER/SUNION/SDIFF仅返回结果,SINTERSTORE/SUNIONSTORE/SDIFFSTORE把结果写入目标键并覆盖旧目标,后者是否持久化还取决于RDB/AOF,不是命令名含STORE就天然保证掉电保留。
单命令原子不保证大集合运算开销低;多键Cluster通常同槽。适用共同好友、标签与权限比较,仍需控制集合规模与响应体积。
5.6 Sorted Set / ZSet
5.6.1 新增、排序与计数
ZADD rank 95 Alice 88 Bob 92 Lily 76 Tom
ZADD score_rank 95 Alice 88 Bob 92 Lily 76 Tom 88 Bob
ZRANGE score_rank 0 -1
ZRANGE score_rank 0 -1 WITHSCORES
ZADD score_rank 98 Bob
ZRANGE score_rank 0 -1 WITHSCORES
初始score_rank新增4,升序Tom76/Bob88/Lily92/Alice95;更新Bob98返回0(未新增),新顺序Tom76/Lily92/Alice95/Bob98。默认ZADD只统计新增,CH等选项会改变计数含义。成员唯一、score可重复;同分按成员字节字典序排列,分数用浮点数表达,不适合直接当任意精度金额。
| 命令 | 含义 |
|---|---|
| ZRANGE key start stop [WITHSCORES] | 默认按升序索引含边界读取 |
| ZREVRANGE key start stop [WITHSCORES] | 旧式降序入口,新版可用ZRANGE ... REV |
| ZSCORE key member | 单个成员分数,缺失nil |
| ZRANK / ZREVRANK key member | 升/降序排名索引,从0开始,缺失nil |
| ZCARD key | 成员数量,缺失0 |
ZCARD score_rank
ZRANGE score_rank 0 -1
ZRANGE score_rank 0 -1 WITHSCORES
ZREVRANGE score_rank 0 2 WITHSCORES
ZRANGE score_rank 0 2 REV WITHSCORES
ZSCORE score_rank Lily
ZSCORE score_rank Mike
ZRANK score_rank Tom
ZREVRANK score_rank Bob
ZREVRANK score_rank Tom
沿用Bob98时,数量4;降序前三为Bob98/Alice95/Lily92,Lily分92、Mike nil;Tom升序0、Bob降序0、Tom降序3。业务展示名次通常+1;分页读取仍要考虑榜单同时更新,不是固定一致快照。新版ZRANGE还支持BYSCORE/BYLEX等选项,不能把所有WITHSCORES能力只限定为两个旧命令。
5.6.2 按成员、排名、分数删除
| 命令 | 范围与返回 |
|---|---|
| ZREM key member [member...] | 删指定成员,返回实际删除数 |
| ZREMRANGEBYRANK key start stop | 按升序索引范围删除,0 -1会删全体 |
| ZREMRANGEBYSCORE key min max | 按分数范围删除,默认包含边界;-inf/+inf无穷端点,(90等可排除端点 |
原多个“初始化”沿用同名集合会残留Bob98等旧状态,返回新增数也不再为5。下面显式重置隔离实验键,保留各阶段预期:
DEL score_rank
ZADD score_rank 76 Tom 88 Bob 92 Lily 95 Alice 98 Jack
ZREM score_rank Tom Jack
ZRANGE score_rank 0 -1 WITHSCORES
ZREMRANGEBYRANK score_rank 0 0
ZRANGE score_rank 0 -1 WITHSCORES
DEL score_rank
ZADD score_rank 76 Tom 88 Bob 92 Lily 95 Alice 98 Jack
ZREMRANGEBYSCORE score_rank -inf 90
ZRANGE score_rank 0 -1 WITHSCORES
首次新增5,删Tom/Jack返回2,剩Bob88/Lily92/Alice95;按索引0删Bob返回1。重置后再新增5,按分数≤90删2,剩Lily92/Alice95/Jack98。大量元素单次删除仍可能阻塞;“一条命令”不是无限规模低成本保证。
5.7 Hash 操作
5.7.1 字段写入与读取
HSET支持多个field/value,返回新字段数量,覆盖字段不计新增。HMSET是兼容旧入口,返回OK,与HSET返回值不同;Redis4后新代码优先多字段HSET。
HSET user:1001 name zhangsan age 20 gender male
HSET user:1001 age 21 address beijing
HGETALL user:1001
HMSET user:1001 name wangwu age 25
HGETALL user:1001
全新键时新增3,再新增1;第二步age21、address新增,HMSET后name wangwu/age25/gender male/address beijing。Hash字段没有业务顺序保证,不依赖HGETALL的特定排列。
| 命令 | 返回 |
|---|---|
| HGET key field | 单字段值,缺失nil |
| HMGET key field [field...] | 按请求顺序给各字段值,缺失位置nil |
| HGETALL key | 全字段和值;RESP2常显示交替数组,协议/客户端可能呈映射 |
| HKEYS / HVALS key | 全部字段名 / 值 |
| HLEN key | 字段数,键不存在0 |
下面重置本实验对象后读取,修正原连续操作却把覆盖结果称为新增4的返回值:
DEL user:1001
HSET user:1001 name zhangsan age 21 gender male address beijing
HLEN user:1001
HGET user:1001 name
HGET user:1001 phone
HMGET user:1001 name age phone
HKEYS user:1001
HVALS user:1001
HGETALL user:1001
新字段4、总数4;name zhangsan、phone nil,HMGET为zhangsan/21/nil;HKEYS字段集合name/age/gender/address,对应值zhangsan/21/male/beijing。HKEYS/HVALS/HGETALL全量访问大Hash仍有CPU、内存和网络开销;按需选字段或HSCAN,不能把1000字段当硬性正确性界限。
5.7.2 删除字段与整个对象
DEL user:1001
HSET user:1001 name zhangsan age 21 gender male address beijing phone 13800138000
HLEN user:1001
HDEL user:1001 age phone
HGETALL user:1001
HDEL user:1001 email
DEL user:1001
HGETALL user:1001
这里新增 5 组字段,结果为 5/5。HDEL age/phone删2,剩name/gender/address;删不存在email返回0;DEL整键返回1,HGETALL为空。
HDEL删除最后一个字段时会自动移除整个Hash键,不会保留空 Hash;List/Set/ZSet清到空也有相应自动删除行为。Hash支持的字段过期等新特性按版本另行核对,不和整键过期混淆。大对象整键删除考虑UNLINK等方式和数据生命周期,第7章有专门实验。
5.8 List 消息队列
图中“订阅者”在这个模型中应理解为竞争消费者,后面的Pub/Sub则是另一种广播机制。
RPUSH尾入、LPOP/BLPOP头出构成FIFO;List现代内部编码按版本/大小可能是listpack/quicklist等,不能简单说全部都是一个普通双向链表。
RPUSH msg_queue "用户下单:order_1001"
RPUSH msg_queue "用户下单:order_1002" "用户下单:order_1003" "支付完成:order_1001"
LRANGE msg_queue 0 -1
BLPOP msg_queue 0
LLEN msg_queue
BLPOP在没有元素时阻塞该连接的请求,不让Redis主线程停止处理所有客户端;timeout0无限等待,正值限制等待秒数,支持小数的版本按其规则使用。LPOP适合已经知道有工作等非阻塞场景,不是一概只能测试;无节制空轮询才会浪费资源。
完整独立实验,先确认msg_queue是本轮键并重置:
DEL msg_queue
RPUSH msg_queue order_1001_create order_1002_create order_1003_create order_1001_pay
LRANGE msg_queue 0 -1
BLPOP msg_queue 0
LLEN msg_queue
LRANGE msg_queue 0 -1
BLPOP msg_queue 0
BLPOP msg_queue 0
BLPOP msg_queue 0
新增4;首次BLPOP返回键msg_queue和消息order_1001_create,长度3;再依次取order_1002_create、order_1003_create、order_1001_pay。之后空队列再BLPOP0会等待,可在另端生产消息;CLI的Ctrl+C退出行为依交互状态,不保证总回到原连接。
BLPOP msg_queue 5
LLEN msg_queue
LRANGE msg_queue 0 -1
空队列原约5.09秒后nil、长度0、空数组;LLEN0仅证明当前待弹出消息为空,不证明业务处理完成。
List可以有多个竞争消费者,一条消息通常由其中一个取走;没有原生的多订阅消费组、ACK/重投/死信管理。弹出后处理前宕机会丢任务,RDB/AOF也不自动解决这个窗口;可使用可靠转移与恢复协议、Stream消费组或专用MQ。FIFO入队/取出顺序不等于并发任务完成顺序,也不是自动延时队列。
5.9 Pub/Sub 广播
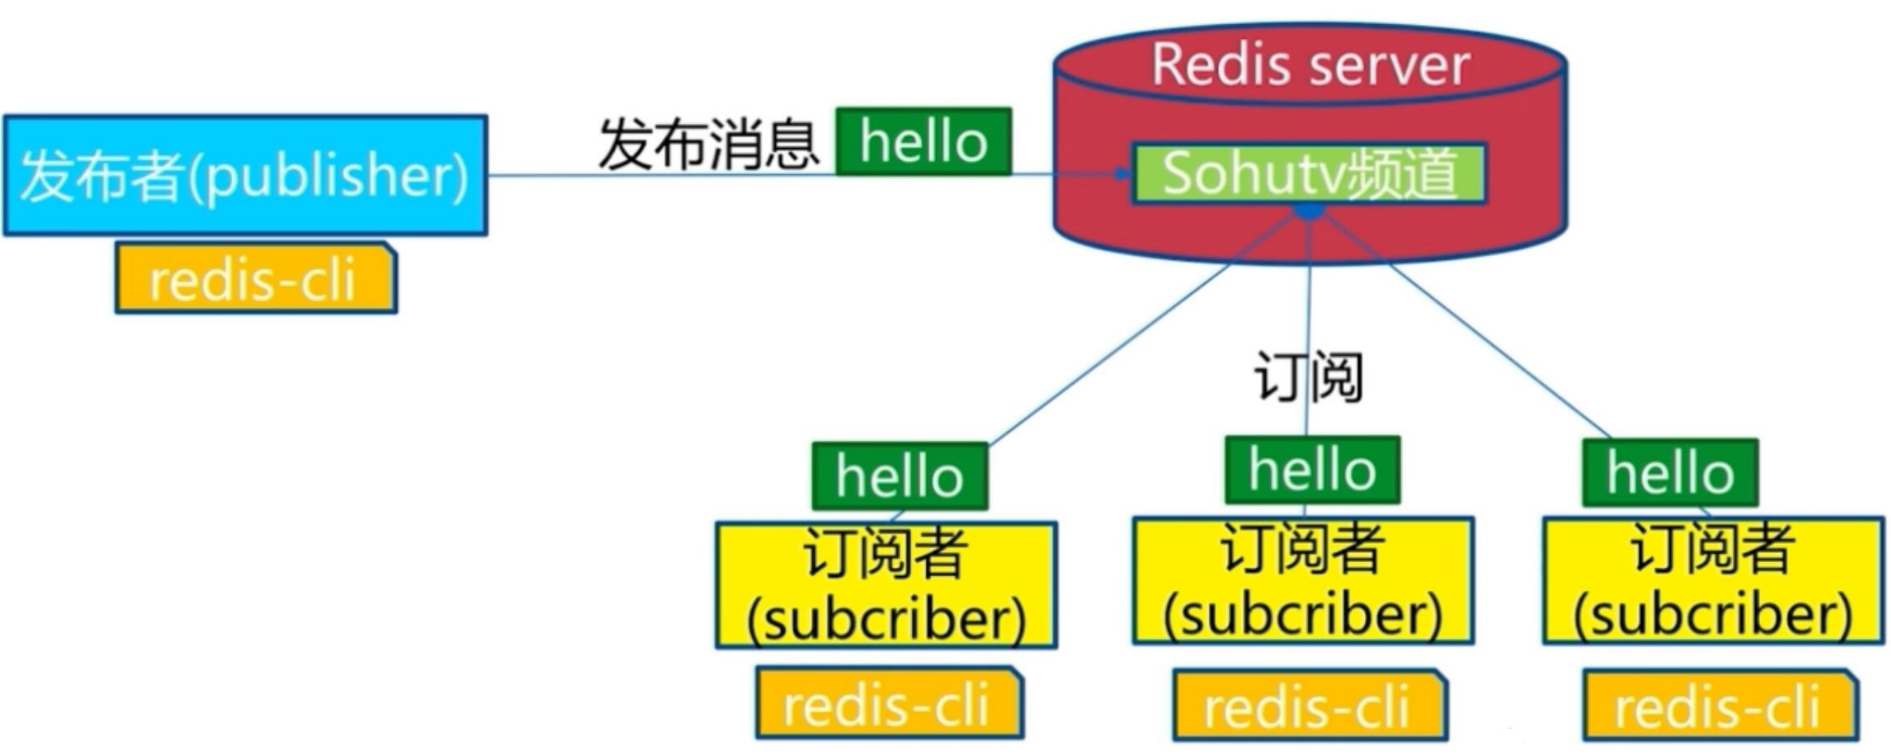
Pub/Sub向当前订阅者实时广播,没有历史存储、离线补发或应用ACK;即使Redis开AOF/RDB,也不会持久化Pub/Sub消息供重播。用于允许丢失的通知、在线广播和配置提示时,要另行提供状态拉取/恢复机制。
SUBSCRIBE channel [channel...]
PUBLISH channel message
UNSUBSCRIBE [channel...]
PSUBSCRIBE pattern [pattern...]
PUNSUBSCRIBE [pattern...]
精准频道与模式订阅分别管理,UNSUBSCRIBE不取消PSUBSCRIBE。RESP2订阅态只允许规定的一组命令,并非任何命令都可用;RESP3等协议/客户端行为有所不同,不能泛化为服务端永久“只能收消息”。
5.9.1 两个/三个客户端
A订阅:
SUBSCRIBE msg_channel
响应 subscribe/msg_channel/1。B发布:
PUBLISH msg_channel user_login_success
PUBLISH msg_channel server_status_online
只有A订阅时两次返回1,A收到 message/msg_channel/消息内容。C另开连接同样SUBSCRIBE msg_channel,B再发:
PUBLISH msg_channel task_execute_finish
原返回2,A/C各收到一条消息。PUBLISH计数不能证明客户端程序成功处理、写库或展示;模式重复匹配及Cluster传播等情形也需按协议理解,不能把计数当应用ACK。
A/C分别取消:
UNSUBSCRIBE msg_channel
确认当前订阅计数变为0,是否回到普通CLI提示/是否退出取决于客户端交互方式。原“先Enter再输入,Ctrl+C回普通提示”是现场操作记录,不是跨客户端保证。
5.9.2 多频道和模式
订阅端:
SUBSCRIBE user_channel order_channel system_channel
依次subscribe应答计数1、2、3。发布端:
PUBLISH user_channel user_login_ok
PUBLISH order_channel order_pay_success
原各返回1,订阅端对应收到两个message。模式订阅示例:
PSUBSCRIBE user_*
PSUBSCRIBE *_channel
PSUBSCRIBE order_?
最后一个仅匹配order_后一个字符,不是任意长度。另一个独立模式实验订阅端:
PSUBSCRIBE order_*
发布端:
PUBLISH order_create order_1001_create
PUBLISH order_pay order_1001_pay
原各返回1;订阅端收到 pmessage/order_*/order_create/order_1001_create 和 pmessage/order_*/order_pay/order_1001_pay。取消:
PUNSUBSCRIBE order_*
全局模式仅在权限允许且确有必要的小范围调试使用,会带来额外处理、流量和数据暴露:
PSUBSCRIBE *
另一端分别 PUBLISH a_channel test_a、PUBLISH b_channel test_b,原单个模式订阅者均收到;无参数PUNSUBSCRIBE取消全部模式。精准和多个模式同时匹配同一消息时同一客户端可收到重复消息,业务要按订阅结构处理。
5.10 redis-benchmark 参数
| 参数 | 含义和常见默认 |
|---|---|
| -h / -p | 目标主机/端口,默认127.0.0.1:6379 |
| -a / --user | 认证口令/支持版本的ACL用户;命令行口令有暴露风险 |
| -c | 并发连接数,常见默认50 |
| -n | 每个测试项目的请求数,常见默认100000,原表10000有误 |
| -d | 测试数据载荷字节数,常见默认3;不是响应总包长 |
| -t | 选择测试项目,如set,get会分别跑SET和GET |
| -P | 每连接pipeline深度,默认1 |
| -q | 简洁输出,省略详细延迟分布 |
| -r | 为测试命令支持的随机占位生成指定范围随机数,不保证生成同样多的互异key |
| -k | 1长连接(常见默认),0反复建立连接 |
| -l | 循环,需主动结束 |
| --threads | 发压工具线程数,常见默认1,与服务端I/O线程配置不同 |
redis-benchmark --help
redis-benchmark -c 100 -n 200000 -d 64 -t set,get -r 100000 -P 20 -q
这里通常每个项目20万请求,SET+GET两项约40万,不是两项合计20万;并发连接按工具调度提交请求,不保证机械平均分配或严格同时开始。随机范围10万不保证真的创建10万个不同key,存在重复与读取未命中。
压测需隔离目标实例、数据库和资源,先规划数据空间、认证、连接及清理范围;不能结束后默认FLUSHDB清空共享业务。并发不能脱离maxclients、文件描述符和系统资源,参数越大也不保证QPS越高。请求数是否充分看持续时间、稳定性与置信范围,没有普适“≥50000即有效”的保证。
5.11 非 Pipeline 基准与原始数据
原环境声明:VMware虚机,2 vCPU、4GB内存(空闲约3.3GB)、196GB磁盘/占用5%,宿主CPU型号i7-14700/显示2.1GHz;Redis8.4.0,开启AOF、自动RDB及口令。vCPU不等于独占两个物理核,磁盘空闲不证明无I/O瓶颈,原文“无抢占/性能达标”没有随附充分测量,不能作为已证事实。
redis-benchmark -a 'Redis@2026' -c 100 -n 200000 -d 64 -t set,get -r 100000
原SET20万请求约2.12秒、GET20万约2.16秒;100 parallel clients,64 bytes payload,keep alive1;save=3600 1 300 100 60 10000、appendonly=yes、multi-thread=no。后者表示工具本轮未多线程发压,不证明服务端只有一个操作系统线程。GET响应大小/命中率还受随机测试键实际是否存在影响,不能仅凭-d64断言每次都读到64字节。
核心汇总保留:
| 项目 | SET | GET |
|---|---|---|
| 请求数 | 200000 | 200000 |
| 显示完成时间(s,舍入) | 2.12 | 2.16 |
| throughput(req/s) | 94428.70 | 92635.48 |
| avg(ms) | 0.761 | 0.776 |
| min(ms) | 0.104 | 0.080 |
| p50(ms) | 0.687 | 0.743 |
| p95(ms) | 1.503 | 1.399 |
| p99(ms) | 2.959 | 2.655 |
| max(ms) | 17.135 | 7.751 |
下表逐项保留原分位分布,单元格式为 延迟ms / 累计数;显示百分比为工具舍入,不把99.999%称为P99.99。重复打印的100%末行合并一次:
| 百分位 | SET ms/累计 | GET ms/累计 |
|---|---|---|
| 0.000% | 0.111 / 3 | 0.087 / 1 |
| 50.000% | 0.687 / 100443 | 0.743 / 100302 |
| 75.000% | 0.983 / 150977 | 0.935 / 150489 |
| 87.500% | 1.135 / 175825 | 1.047 / 175540 |
| 93.750% | 1.391 / 187591 | 1.303 / 187502 |
| 96.875% | 1.735 / 193827 | 1.599 / 193797 |
| 98.438% | 2.295 / 196895 | 2.143 / 196879 |
| 99.219% | 3.271 / 198443 | 2.935 / 198450 |
| 99.609% | 5.095 / 199221 | 4.063 / 199221 |
| 99.805% | 7.775 / 199610 | 5.215 / 199613 |
| 99.902% | 11.615 / 199805 | 5.543 / 199805 |
| 99.951% | 15.383 / 199903 | 6.959 / 199903 |
| 99.976% | 15.855 / 199952 | 7.263 / 199953 |
| 99.988% | 16.111 / 199976 | 7.519 / 199976 |
| 99.994% | 16.607 / 199990 | 7.639 / 199988 |
| 99.997% | 16.799 / 199994 | 7.703 / 199994 |
| 99.998% | 16.847 / 199997 | 7.727 / 199997 |
| 99.999% | 16.879 / 199999 | 7.743 / 199999 |
| 100.000% | 17.135 / 200000 | 7.751 / 200000 |
累计区间分布也保留。以下每个格子为原 累计百分比 / 累计数,破折号表示原输出无该行;区间上端是直方图桶边界,不等同于最大实测请求延迟:
| ≤ms | SET %/累计 | GET %/累计 |
|---|---|---|
| 0.103 | 0.000 / 0 | 0.001 / 1 |
| 0.207 | 5.043 / 10086 | 3.431 / 6861 |
| 0.303 | 8.963 / 17926 | 6.609 / 13218 |
| 0.407 | 34.453 / 68906 | 19.050 / 38101 |
| 0.503 | 41.204 / 82408 | 22.728 / 45456 |
| 0.607 | 44.695 / 89391 | 33.452 / 66904 |
| 0.703 | 51.577 / 103153 | 45.081 / 90161 |
| 0.807 | 60.398 / 120795 | 58.651 / 117302 |
| 0.903 | 68.670 / 137340 | 71.128 / 142257 |
| 1.007 | 77.532 / 155065 | 84.354 / 168708 |
| 1.103 | 85.591 / 171183 | 90.055 / 180110 |
| 1.207 | 90.842 / 181684 | 92.290 / 184579 |
| 1.303 | 92.644 / 185289 | 93.751 / 187502 |
| 1.407 | 93.986 / 187972 | 95.169 / 190338 |
| 1.503 | 95.061 / 190122 | 96.221 / 192442 |
| 1.607 | 96.105 / 192210 | 96.939 / 193877 |
| 1.703 | 96.760 / 193520 | 97.351 / 194702 |
| 1.807 | 97.195 / 194391 | 97.737 / 195473 |
| 1.903 | 97.537 / 195073 | 97.966 / 195933 |
| 2.007 | 97.847 / 195694 | 98.198 / 196396 |
| 2.103 | 98.080 / 196160 | 98.373 / 196746 |
| 3.103 | 99.115 / 198229 | 99.359 / 198718 |
| 4.103 | 99.404 / 198809 | 99.623 / 199246 |
| 5.103 | 99.612 / 199225 | 99.784 / 199568 |
| 6.103 | 99.723 / 199446 | 99.950 / 199900 |
| 7.103 | 99.770 / 199540 | 99.965 / 199929 |
| 8.103 | 99.806 / 199612 | 100.000 / 200000 |
| 9.103 | 99.850 / 199700 | — |
| 11.103 | 99.886 / 199772 | — |
| 12.103 | 99.930 / 199859 | — |
| 13.103 | 99.950 / 199900 | — |
| 16.103 | 99.987 / 199975 | — |
| 17.103 | 99.999 / 199999 | — |
| 18.111 | 100.000 / 200000 | — |
5.11.1 指标含义和结论边界
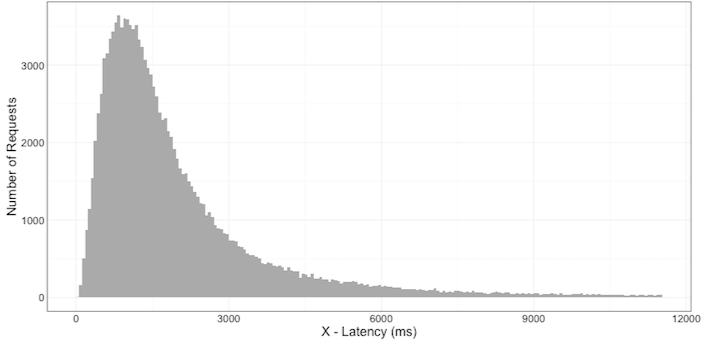
吞吐是该项目完成请求数/测量时间,延迟由工具在客户端计时,包括相关网络与调度开销。avg平均,min最小,p50中位数,p95/p99分别描述相应比例请求的延迟上界,max是本轮最大值;这些采样/直方图估计与显示精度不能当作精确的服务端命令执行时间。
原SET吞吐略高于GET,但GET的p95、p99、max较低;单轮不足以推导任意负载下读写必然关系。原分位表与Summary部分最小值/累计数据存在显示口径或现场差异,本稿如实保留,未凭空改成一份新测量。
SET最大17.135ms、GET7.751ms反映本轮尾部差异,不能仅据开启AOF就断言由刷盘阻塞导致。需同步观察appendfsync策略、fsync延迟、RDB/AOF重写fork、COW、CPU调度/虚拟化争用、大键、过期淘汰、内存与网络。SET不是每次都做RDB快照或等待一次磁盘fsync;GET也可能受同实例的持久化和系统资源争用影响。
P99较低也不等于最慢0.1%没有超时,是否超时取决于应用总链路与预算;17ms不自动等于超时。原“5万合格/8万优秀”“普通互联网50/100ms”“2核4G可支撑某规模”均缺少通用基准依据,不作为性能验收标准。要按真实命令分布、数据大小、命中率、连接/网络、持久性要求和业务SLO多轮测试。
长尾是分布尾部较慢请求,不必先有一个固定10ms阈值。平均值掩盖尾部,p95/p99/p99.9与最大值一起观察;p99低也不能保证绝无卡顿。调优everysec涉及可丢失窗口,不能只追吞吐;多实例也需要真实CPU/内存/IO余量,不因2vCPU就证明只有“单核”是瓶颈。
5.12 Pipeline 原理与对比实验
普通单连接逐条“发送→等响应→下一条”受RTT影响;Pipeline允许连续发送多条,不必逐条等待应答,减少等待和系统调用摊销。它不保证单个TCP包发送、不保证服务端等全部命令执行完才一起返回,也不提供事务隔离/回滚;其他客户端可能穿插执行,不能把整批视为原子块。
P20表示每连接最多按该深度发压,100并发连接下排队模式与P1不同。所谓20万请求从20万RTT降至1万RTT仅是单连接分批的粗略说明,不等于全局实际往返严格等数或CPU从此无等待。
redis-benchmark -a 'Redis@2026' -c 100 -n 200000 -d 64 -t set,get -r 100000 -P 20
原SET20万约0.41秒、GET20万约0.17秒,其他声明配置同上一轮。核心输出:
| 项目 | SET P20 | GET P20 |
|---|---|---|
| 请求数 | 200000 | 200000 |
| throughput(req/s) | 484261.53 | 1197604.88 |
| avg(ms) | 3.779 | 1.390 |
| min(ms) | 0.400 | 0.184 |
| p50(ms) | 3.223 | 1.479 |
| p95(ms) | 6.567 | 2.383 |
| p99(ms) | 19.343 | 3.007 |
| max(ms) | 33.023 | 3.311 |
原逐项分位分布,ms / 累计数:
| 百分位 | SET P20 | GET P20 |
|---|---|---|
| 0.000% | 0.407 / 20 | 0.191 / 20 |
| 50.000% | 3.223 / 100800 | 1.479 / 100840 |
| 75.000% | 3.967 / 150160 | 1.839 / 150680 |
| 87.500% | 5.527 / 175020 | 2.039 / 175660 |
| 93.750% | 6.295 / 187540 | 2.247 / 187620 |
| 96.875% | 7.383 / 193780 | 2.599 / 193800 |
| 98.438% | 18.847 / 196920 | 2.911 / 196980 |
| 99.219% | 28.143 / 198440 | 3.071 / 198520 |
| 99.609% | 32.495 / 199240 | 3.151 / 199280 |
| 99.805% | 32.703 / 199620 | 3.199 / 199660 |
| 99.902% | 32.895 / 199860 | 3.247 / 199820 |
| 99.951% | 32.959 / 199940 | 3.279 / 199920 |
| 99.976% | 32.991 / 199980 | 3.295 / 199960 |
| 99.988% | — | 3.303 / 199980 |
| 99.994% | 33.023 / 200000 | 3.311 / 200000 |
| 100.000% | 33.023 / 200000 | 3.311 / 200000 |
原累计区间:
| ≤ms | SET P20 %/累计 | GET P20 %/累计 |
|---|---|---|
| 0.103 | 0.000 / 0 | 0.000 / 0 |
| 0.207 | — | 0.030 / 60 |
| 0.303 | — | 0.700 / 1400 |
| 0.407 | 0.010 / 20 | 1.370 / 2740 |
| 0.503 | 0.140 / 280 | 2.530 / 5060 |
| 0.607 | 0.280 / 560 | 9.190 / 18380 |
| 0.703 | 0.650 / 1300 | 18.860 / 37720 |
| 0.807 | 1.120 / 2240 | 28.440 / 56880 |
| 0.903 | 1.570 / 3140 | 33.600 / 67200 |
| 1.007 | 1.850 / 3700 | 36.040 / 72080 |
| 1.103 | 2.340 / 4680 | 36.960 / 73920 |
| 1.207 | 3.710 / 7420 | 38.030 / 76060 |
| 1.303 | 6.130 / 12260 | 39.530 / 79060 |
| 1.407 | 10.000 / 20000 | 45.600 / 91200 |
| 1.503 | 12.820 / 25640 | 52.150 / 104300 |
| 1.607 | 14.510 / 29020 | 59.830 / 119660 |
| 1.703 | 15.520 / 31040 | 66.430 / 132860 |
| 1.807 | 16.580 / 33160 | 73.230 / 146460 |
| 1.903 | 17.470 / 34940 | 79.430 / 158860 |
| 2.007 | 18.610 / 37220 | 85.820 / 171640 |
| 2.103 | 20.300 / 40600 | 90.730 / 181460 |
| 3.103 | 44.450 / 88900 | 99.380 / 198760 |
| 4.103 | 76.940 / 153880 | 100.000 / 200000 |
| 5.103 | 84.620 / 169240 | — |
| 6.103 | 92.820 / 185640 | — |
| 7.103 | 96.170 / 192340 | — |
| 8.103 | 97.460 / 194920 | — |
| 10.103 | 97.540 / 195080 | — |
| 11.103 | 97.790 / 195580 | — |
| 12.103 | 97.900 / 195800 | — |
| 19.103 | 98.780 / 197560 | — |
| 20.111 | 99.110 / 198220 | — |
| 28.111 | 99.210 / 198420 | — |
| 29.103 | 99.530 / 199060 | — |
| 33.119 | 100.000 / 200000 | — |
按Summary吞吐计算,SET提升约5.13倍,GET约12.93倍;不是普遍2–10倍上限,更不证明这是服务端极限。SET p99从2.959升至19.343ms、max从17.135到33.023ms,GET p99从2.655升至3.007ms而max从7.751降至3.311ms,故不能概括为“所有最大延迟均上升”或把明显尾部增长一律称为小幅。
Pipeline适合独立批量读写,但批量字节/深度过大可增加排队、缓冲内存和尾延迟;需要先读取结果才能决定下一条的逻辑也不能无条件提前发送。结合MGET/HMGET等命令、合理管道深度与端到端SLO选择,不保证总是最佳。最终命令执行、持久化、CPU、网络及发压端都可能限制吞吐,不能仅凭GET提升更大就证明SET一定卡在AOF磁盘。
6. Redis 应用架构部署与原理
6.1 主从复制架构基础
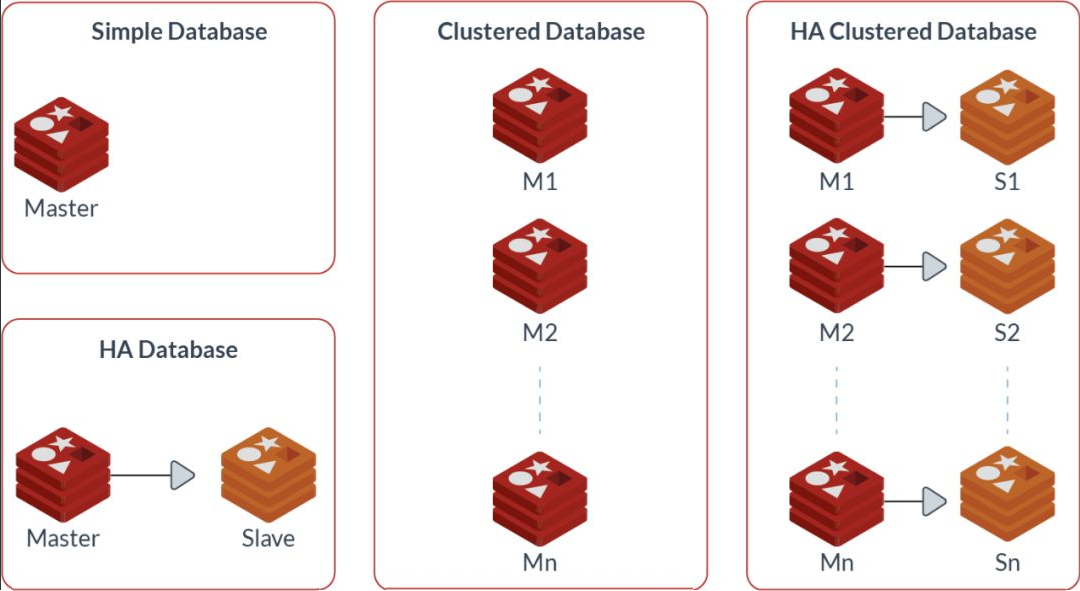
主节点负责写入,副本异步复制其数据,默认只读。读流量可按业务要求分配给副本,离线导出、校验和备份也可隔离到副本;这些任务仍会争用副本资源并增加延迟,不是无限扩展、互不干扰。主节点也可服务读取。副本有助于容忍单机故障,不能阻止误删和错误写入传播,不能代替历史备份。
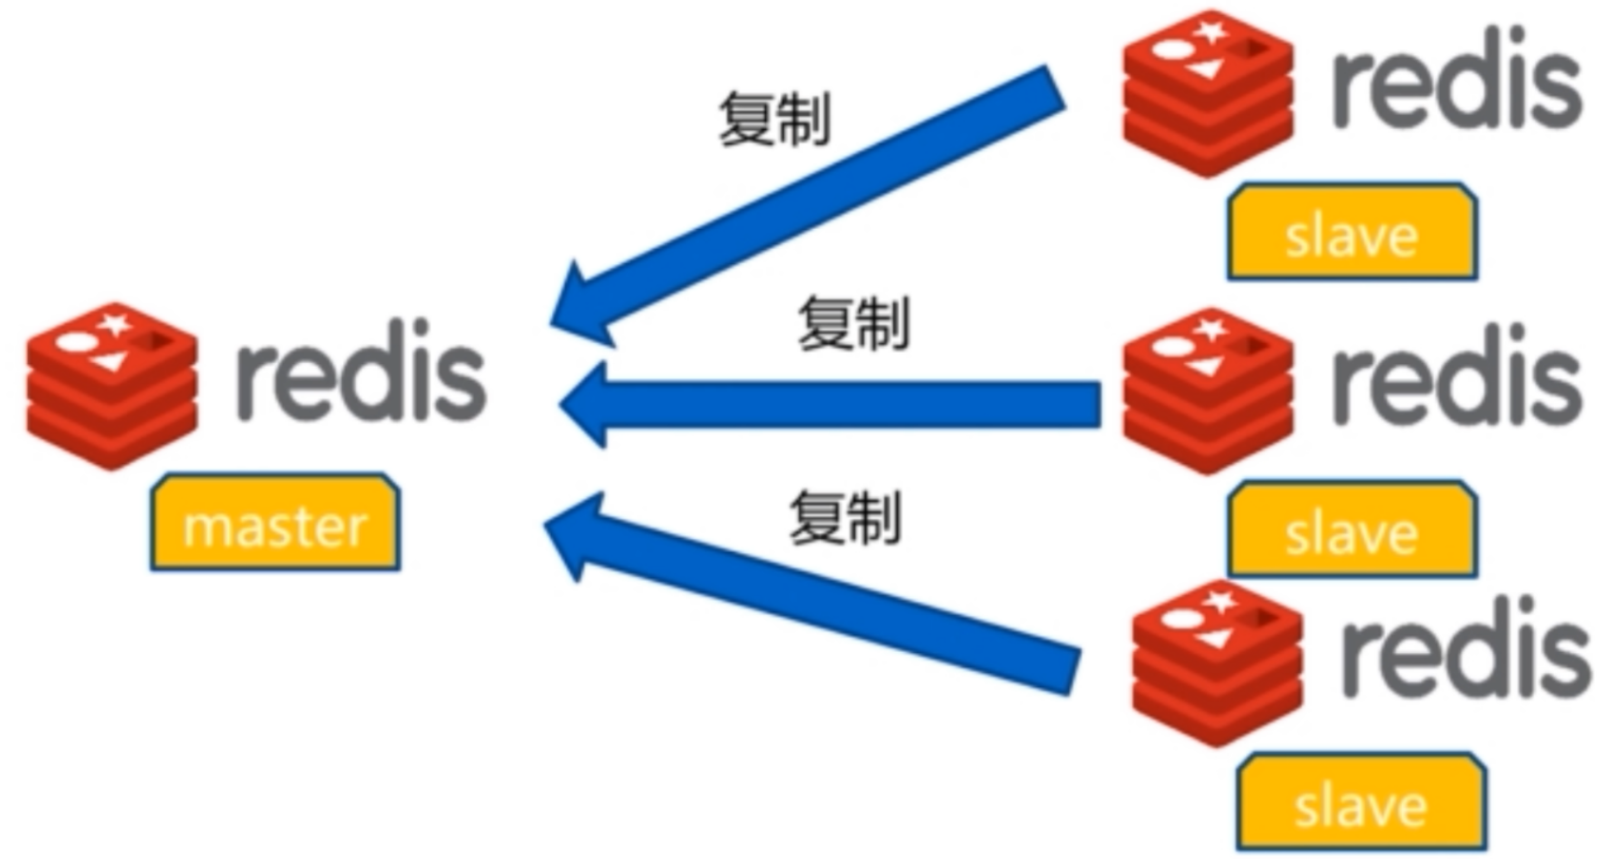
Redis 5 起推荐 REPLICAOF / replicaof,仍兼容 SLAVEOF 等旧称;部分 INFO/ROLE 输出继续使用 slave。裸主从没有自动故障转移,Sentinel 或 Cluster 才提供相应编排。异步复制可能丢失主节点已确认但尚未到达晋升副本的写入;副本读不提供普遍的强一致读保证。
# 从节点配置
replicaof 10.0.0.13 6379
masterauth Redis@2026
replica-read-only yes
replica-priority 100

# 若使用指定 ACL 复制账户,还需要匹配该账户的权限和 masteruser
# masteruser repl-user
masterauth 是向上游认证的凭证,requirepass 则控制客户端访问当前节点,两者用途不同。replica-priority 越小,Sentinel 筛选时优先级越高,0 表示不用于晋升;仍须通过健康度等前置筛选。关闭只读后本地写入不会反向复制,且可能被后续同步覆盖。
REPLICAOF 10.0.0.13 6379
REPLICAOF NO ONE
CONFIG REWRITE
前两条动态改变当前复制关系;NO ONE 晋升为独立主节点并保留当前内存数据。重启后的角色取决于实际配置文件、是否重写和编排系统,不能断言所有动态设置重启后都变成主节点。
6.1.1 全量同步、增量流与部分重同步
- 副本建立连接,进行 PING、认证、REPLCONF 和 PSYNC 协商,携带复制历史 ID 与偏移量。
- 首次同步或历史无法衔接时进行 FULLRESYNC。主节点生成 RDB 数据,可能落盘后传送,也可能无磁盘流式传送;fork 会短暂暂停主线程。
- 快照期间的后续写入继续进入复制流及相关缓冲。副本接收并加载快照,再应用尚未覆盖的增量,最终追赶主节点。
- 正常连接下持续传送复制流。短暂断连后,若请求的历史 ID 被认可、缺失范围仍保留在 backlog,则可 PSYNC 部分重同步;否则重新全量同步。
全量加载会替换副本原有数据。各版本的磁盘/无磁盘加载和读请求行为不同,不能一概认为过程中永远可读或必须始终先写磁盘。全量同步期间用于待发送复制流的缓冲与供断连恢复的 backlog 有联系,但不能简单当作同一个无限缓冲。
repl-backlog-size 常见默认 1 MB。历史窗口有限,旧数据会随新复制流被覆盖。backlog 的分配与释放还受角色、是否曾有副本以及 repl-backlog-ttl 等影响;所有副本断开不代表 repl_backlog_active 立即变 0。较新版本内部可能采用共享复制缓冲区,不能把逻辑环形窗口等同于所有版本的物理实现。
偏移量按复制流字节推进,不按命令数推进;PING 等复制流也会推进。应同时比较复制历史 ID、采样时点、连接状态和偏移量。相同历史下副本到达某个主偏移,表示对应流已处理,不等于任意时刻全部键值、过期状态与磁盘持久化均已证明相同。复制确认也不是已 fsync 的承诺。
6.1.2 INFO replication 与 ROLE
redis-cli INFO replication
redis-cli ROLE
# 原主节点示意(字段名称随版本可能仍为 connected_slaves)
role:master
connected_slaves:1
slave0:ip=10.0.0.16,port=6379,state=online,offset=98,lag=1
master_repl_offset:98
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:98

# 原副本示意
role:slave
master_host:10.0.0.13
master_port:6379
master_link_status:up
master_last_io_seconds_ago:3
master_sync_in_progress:0
slave_repl_offset:42
slave_read_only:1
master_link_status 为 down 表示连接异常;master_sync_in_progress 标识全量同步阶段。master_last_io_seconds_ago 要结合复制心跳周期与超时,不能硬定大于 5 秒就一定故障。主节点 slaveN 中 lag 是距副本最近 ACK 的秒数,不是精确业务复制延迟。
# ROLE 主节点示例
1) "master"
2) (integer) 15690123
3) 1) 1) "127.0.0.1"
      2) "6380"
      3) "15690123"

# ROLE 副本示例
1) "slave"
2) "127.0.0.1"
3) (integer) 6379
4) "connected"
5) (integer) 15690123
排查复制延迟时,先确认网络、认证、历史 ID 和同步阶段,再检查主副本 CPU、慢命令、大键、fork/COW、磁盘及输出缓冲。backlog 应按“复制流每秒字节 × 希望覆盖的断连秒数 × 余量”估算,而非统一定为 8–32 MB。调整持久化不能牺牲已明确的数据可靠性需求;不要为排错直接关闭防火墙或主副本持久化。
6.2 主从部署、验证与排障
6.2.1 Ubuntu 主从实验
本节配置两台机器:主 10.0.0.13:6379、副本 10.0.0.16:6379。后续 Sentinel 实验才加入第三台。编译、源码校验、账户和 systemd 基础安装使用 3.3 完整源码部署脚本 中的 deploy_redis.sh。
# 主节点:按实际本机地址配置,保留认证与保护模式
bind 127.0.0.1 10.0.0.13 -::1
protected-mode yes
port 6379
dir /var/lib/redis/6379
logfile /var/log/redis/redis-6379.log
requirepass Redis@2026
masterauth Redis@2026
repl-backlog-size 16mb
save 3600 1 300 100 60 10000
appendonly yes
appendfsync everysec

# 副本:相同基础选项,bind 使用 10.0.0.16,并增加
replicaof 10.0.0.13 6379
replica-read-only yes
replica-priority 100
masterauth 在当前主节点也预置,是为以后该节点降为副本使用。持久化应考虑每个节点可能被晋升以及恢复需求;“副本 AOF 没价值、升主以后再开”会留下故障窗口。仅注释 save 行也不等价于显式关闭所有默认自动规则,需用 save "" 并核对运行态。此文采用所有候选节点持久化,不把它当作所有业务的唯一方案。
read -rsp 'Redis password: ' REDISCLI_AUTH; echo
export REDISCLI_AUTH
redis-cli -h 10.0.0.13 INFO replication
redis-cli -h 10.0.0.16 CONFIG SET masterauth "$REDISCLI_AUTH"
redis-cli -h 10.0.0.16 REPLICAOF 10.0.0.13 6379
redis-cli -h 10.0.0.16 INFO replication
原副本状态有 master_link_status:up、slave_repl_offset:42;主节点 connected_slaves:1、在线副本地址 .16,随后偏移为 98。不同时间采样偏移不同是正常现象。
原文演示 REPLICAOF NO ONE 后副本成为 master,新复制 ID 1fb27ec0e40fdbf5f0e79679fed827d3e83ba46e,同时记录前一个 ID。恢复复制后,两端采样到偏移 266。为保留角色,应修改对应配置或确认 CONFIG REWRITE 成功,不能只追加重复指令后不核对最终值。
# 主节点写入;副本读取
redis-cli -h 10.0.0.13 SET test:num 100
redis-cli -h 10.0.0.13 MSET k1 v1 k2 v2 k3 v3
redis-cli -h 10.0.0.16 MGET test:num k1 k2 k3
预期依次读取 100、v1、v2、v3,有异步延迟时需有限重试。这只能证明样本同步,不能证明执行的是首次全量同步;要在新副本建立复制关系时结合 FULLRESYNC/RDB 加载日志和 sync_full 变化判断。
原文解除复制后再写 test1:num=100、k11=v1、k12=v2、k13=v3,重新绑定后看到 8 个键和偏移 937。保留为“重建复制关系后数据追赶”的现象,不凭键存在就宣布部分重同步成功。NO ONE 是角色变更,不是纯网络中断;PSYNC2 在一定历史条件下仍可能部分同步,因而“必定全量”也不成立。
6.2.2 backlog 实验的正确判据
# 原 1 MB backlog 采样
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:10023
histlen 是当前保留的历史长度,不是待同步积压长度。一个健康稳定实例运行足够久后 backlog 留满很正常,不能用 histlen >= 70% 判定危险或自动扩容。实际需要比较断连副本请求范围与保留范围,监控实际缺失量、写入速率、断连时间和 full/partial resync 计数。
原 1 MB 实验写入 test_1 至 test_20000,日志记录:
Trying a partial resynchronization (request 5a271c88281ed183dfb690c8884e85e09c22594f:10402).
PSYNC is not possible, initialize RDB channel.
Starting to receive RDB and replication stream in parallel.
MASTER <-> REPLICA sync: Flushing old data
RDB memory usage when created 2.55 Mb
Done loading RDB, keys loaded: 20008, keys expired: 0.
MASTER <-> REPLICA sync: Successfully streamed replication buffer into the db (0 bytes in total)
MASTER <-> REPLICA sync: Finished with success
这说明本次未采用部分重同步,但仅凭该段副本日志不能唯一断言 backlog 太小;需在主节点核对请求 ID、offset 与当时窗口。20000 个键也不保证复制协议超过 1 MB,应测实际复制偏移增量。
CONFIG SET repl-backlog-size 16777216
CONFIG GET repl-backlog-size
INFO replication

# 持久配置示例为 64 MiB;原文称 32M 而配置实际为 64mb,按实际修正
repl-backlog-size 64mb
调整 backlog 大小不应被解释为必定重新生成复制 ID,更不存在 INFO 要等重启才显示新 ID 的普遍机制。重启主节点会改变复制上下文,不能用它替代纯网络故障实验。RESET 重置的是当前客户端连接状态,并不清空服务端复制历史;也不应清空日志来准备实验。
正确的隔离实验流程是:先建立健康复制并记录两端 ID、offset、INFO stats 的 full/partial 计数及日志时间点;保持主节点持续运行,仅在实验网络设施中临时阻断副本到主节点的复制连接;主节点写入已知数量和长度的实验键;在覆盖窗口内恢复连接,核对日志 Successful partial resynchronization / Master accepted a Partial Resynchronization 与计数变化。随后用超过窗口的流量重复,观察全量恢复。网络阻断需有带外恢复能力,本文不提供会意外断开管理链路的通用防火墙脚本。
原 64 MB 记录:
Error condition on socket for SYNC: Connection refused
Trying a partial resynchronization (request b810f1920f6000d743c052b9679fae9adc9c56e7:9471781).
Successful partial resynchronization with master.
Master replication ID changed to 36d4b257a48036c25e88d022960f40612628a5c3
MASTER <-> REPLICA sync: Master accepted a Partial Resynchronization.
原步骤却在 systemctl stop redis 后向同一主节点写入 20000 条,服务已停止时这些写入无法成功;边界实验的 200000 次写入也有同样问题。以上日志作为原观察保留,不能视为该错误步骤验证了 64 MB 覆盖能力。50 MB 也不能只凭“200000 个键”得出,应比较实际复制流偏移差。
6.2.3 数据一致性与手动故障切换
# 主节点样本写入
redis-cli -h 10.0.0.13 SET biz_test_no 2026061801
redis-cli -h 10.0.0.13 SET biz_name redis_sync_check
redis-cli -h 10.0.0.13 HSET user:1001 id 1001 name test age 24
redis-cli -h 10.0.0.13 RPUSH order:list 10001 10002 10003
# 副本读取
redis-cli -h 10.0.0.16 MGET biz_test_no biz_name
redis-cli -h 10.0.0.16 HGETALL user:1001
redis-cli -h 10.0.0.16 LRANGE order:list 0 -1
redis-cli -h 10.0.0.13 DBSIZE
redis-cli -h 10.0.0.16 DBSIZE
原两端 DBSIZE 均为 20012,只证明该库采样时键数量相同,不证明值、类型或 TTL 相同。原先后采样偏移为主 9477216、副本 9477230,副本数值较大可由采样时点差解释,不是副本超过同一时点主历史。即使两端逻辑数据一致,独立生成的 RDB 文件仍可能因辅助元数据、时间或编码不同而有不同 MD5;不能因此清空副本。需在可控一致性时点比较类型、内容和 TTL,必要时使用专业校验工具及恢复演练。
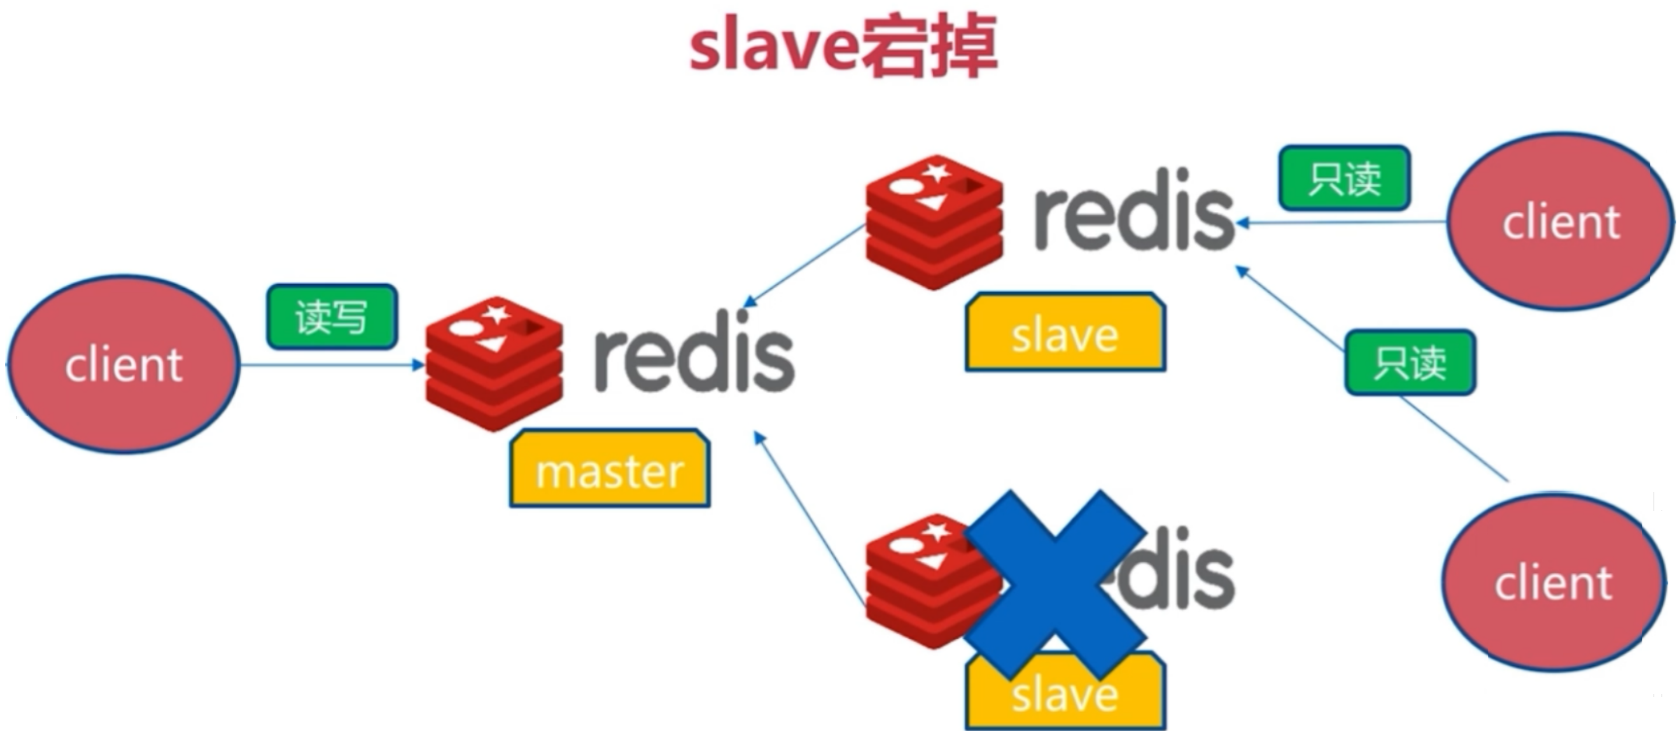
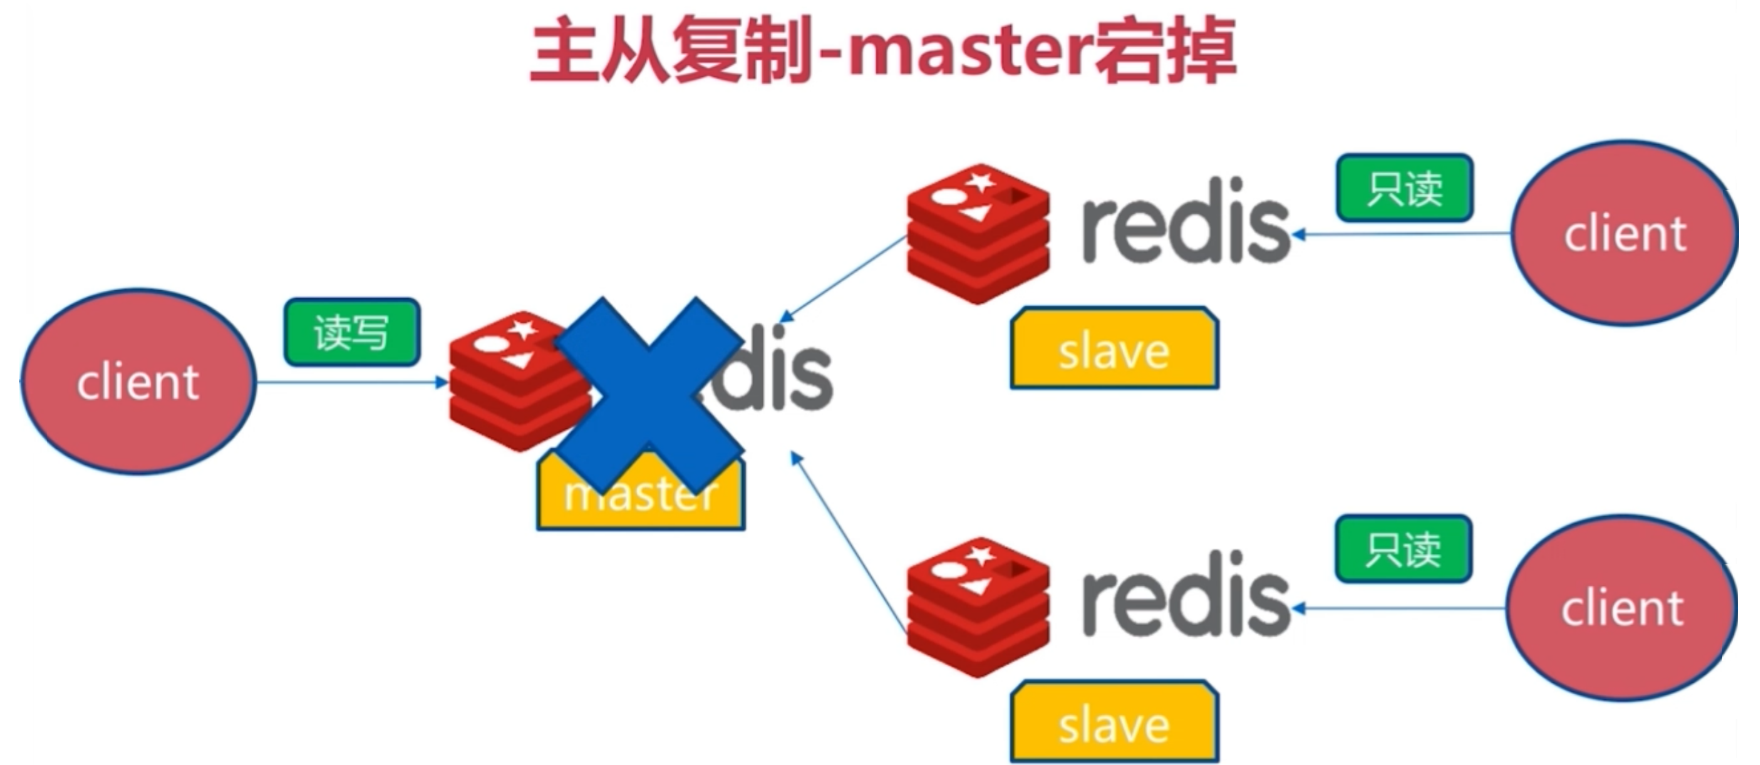
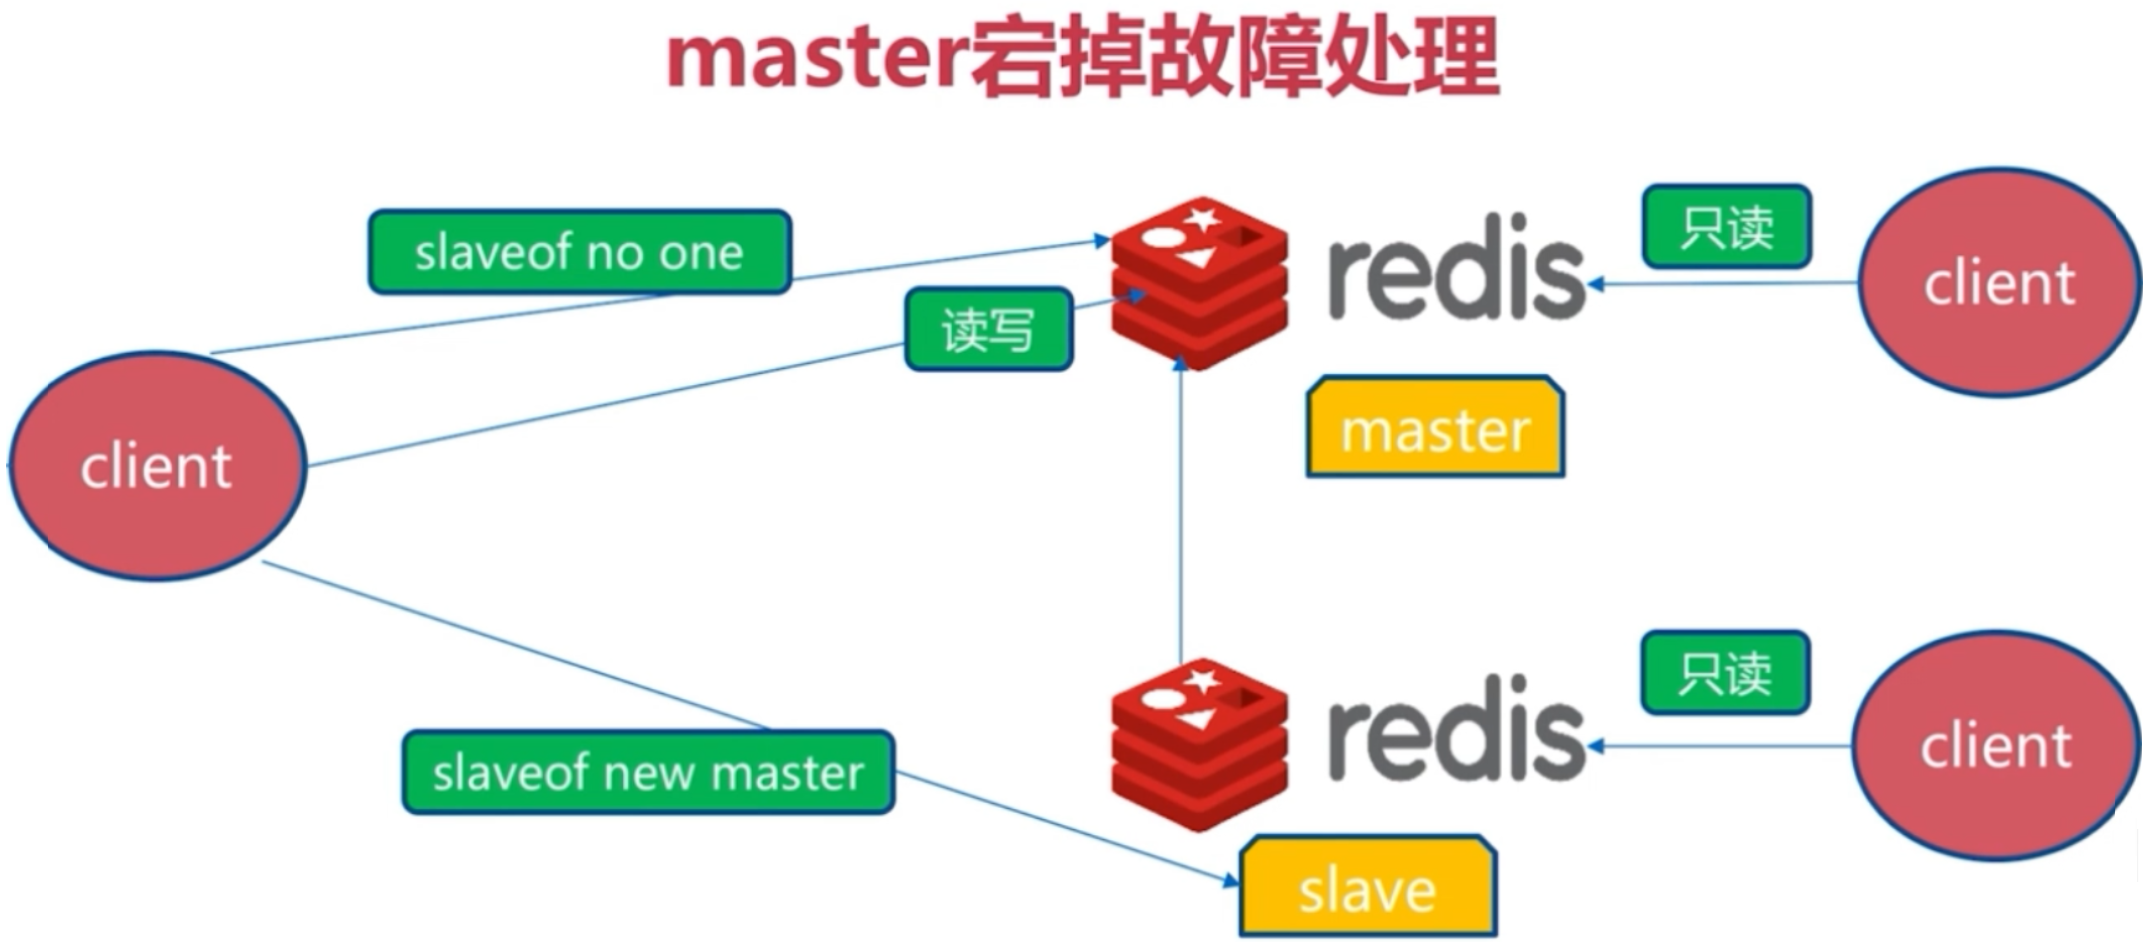
手动故障切换必须先确认并隔离原主写入口,防止网络分区下两个主同时接收业务写入。选择数据最新且可用的副本后,晋升、更新应用入口,再将其他副本重配到新主。原主恢复后要先隔离并核对分叉写入,决定恢复策略,再降为副本;同步可能替换旧主数据,不会自动合并冲突,也不能承诺所有节点必定全量或必定增量。
# 以下为裸主从实验步骤,原主必须已停止或被隔离
# 在 .16 晋升前核对最后复制状态及可接受的数据损失
redis-cli -h 10.0.0.16 REPLICAOF NO ONE
redis-cli -h 10.0.0.16 ROLE
redis-cli -h 10.0.0.16 SET failover_status success
# 业务入口切换到 .16 后,在已隔离且已检查的旧主 .13 上
redis-cli -h 10.0.0.13 CONFIG SET masterauth "$REDISCLI_AUTH"
redis-cli -h 10.0.0.13 REPLICAOF 10.0.0.16 6379
redis-cli -h 10.0.0.13 INFO replication
redis-cli -h 10.0.0.16 INFO replication
原演示新主 role:master、写入 OK,但旧主随后 master_link_status:down、master_last_io_seconds_ago:-1、连续同步重试 1574 次,且新主仍 connected_slaves:0。该记录说明复制尚未恢复,不能称“自动归位成功”。排查新主 bind、网络、认证及日志,直至旧主链路 up、新主识别在线副本且样本追平,再保存双方正确配置。不要通过关闭保护模式代替正确认证。
6.2.4 主从部署脚本
源码下载、校验、编译、安装及基础 unit 与 3.3 完整源码部署脚本 相同,直接复用 deploy_redis.sh。原 deploy_redis_ms.sh 删除已有源码、覆盖配置、全网放行端口、关闭保护模式及创建可读明文密码等问题,改为以下专用新环境包装器;它只在基础部署前接受 master/slave 参数,并在第一次启动后补齐复制配置。基础脚本的校验值、实验开关等前置要求仍生效。
#!/usr/bin/env bash
# deploy_redis_ms.sh:新实验环境,复用第 3 章的完整基础安装器
set -euo pipefail
[[ $EUID -eq 0 ]] || { echo '需要 root' >&2; exit 1; }
[[ ${REDIS_NEW_LAB:-} == YES ]] || { echo '需 REDIS_NEW_LAB=YES' >&2; exit 1; }
node_type=${1:-}
node_ip=${2:-}
case "$node_type:$node_ip" in
    master:10.0.0.13|slave:10.0.0.16|slave:10.0.0.19) ;;
    *) echo '用法:deploy_redis_ms.sh master 10.0.0.13 | slave 10.0.0.16 | slave 10.0.0.19' >&2; exit 1 ;;
esac
conf=/etc/redis/redis-6379.conf
[[ ! -e $conf ]] || { echo '已有配置,拒绝覆盖' >&2; exit 1; }
[[ -f ./deploy_redis.sh ]] || { echo '缺少第 3 章基础脚本' >&2; exit 1; }
: "${REDIS_PASSWORD:?通过专用终端设置本章实例的认证值}"
[[ $REDIS_PASSWORD =~ ^[A-Za-z0-9_@%+=:,./-]+$ ]] || {
    echo '实验包装器密码仅接受指定可安全写入配置的字符' >&2; exit 1;
}
# 基础脚本使用其文中规定的参数、校验值与环境设置;不要绕过新环境检查。
bash ./deploy_redis.sh
systemctl stop redis.service
# 在基础配置后写入本章的明确覆盖项;完成后检查运行态。
{
    printf '\nbind 127.0.0.1 %s -::1\n' "$node_ip"
    printf 'protected-mode yes\nrepl-backlog-size 16mb\n'
    printf 'requirepass %s\nmasterauth %s\n' "$REDIS_PASSWORD" "$REDIS_PASSWORD"
    printf 'appendonly yes\nappendfsync everysec\n'
    printf 'save 3600 1 300 100 60 10000\n'
    if [[ $node_type == slave ]]; then
        printf 'replicaof 10.0.0.13 6379\nreplica-read-only yes\nreplica-priority 100\n'
    fi
} >> "$conf"
chown root:redis "$conf"
chmod 640 "$conf"
systemctl start redis.service
REDISCLI_AUTH=$REDIS_PASSWORD redis-cli --raw PING
REDISCLI_AUTH=$REDIS_PASSWORD redis-cli INFO replication
基础脚本先建立仅回环监听的无密码实例;包装器停止它,增加 requirepass 与供未来降为副本使用的 masterauth,再开放指定本机内网地址。防火墙按真实主副本和客户端网段分别放行,以上脚本不全网开放端口。两个新环境开关分别由包装器和基础脚本检查,源码散列仍须先从可信发布渠道核对:
export REDIS_NEW_LAB=YES
export REDIS_SOURCE_FRESH_LAB=YES
read -rp 'Verified Redis 8.4.0 SHA256: ' REDIS_SOURCE_SHA256
export REDIS_SOURCE_SHA256
read -rsp 'New Redis password: ' REDIS_PASSWORD; echo
export REDIS_PASSWORD
bash deploy_redis_ms.sh master 10.0.0.13
# .16 / .19 各在自己的新实验主机使用 slave 和对应本机地址。
原安装效果为两端服务 active,主节点写 test_key=2026redis_master,副本返回同值,副本尝试 SET 返回 READONLY You can't write against a read only replica.。原来绑定 0.0.0.0 和 [::] 的输出说明监听所有接口,不能当成受限内网绑定的效果。
6.2.5 主从专项验证脚本
非交互 Bash 默认不展开 alias;函数和数组更适合封装带参数命令。--no-auth-warning 仅隐藏提示,不能保护 -a 参数中的密码。以下使用环境认证、数组、有限重试、唯一前缀与 TTL,不执行原脚本的 FLUSHDB,也不把“某键存在”误当作已证明 PSYNC。
#!/usr/bin/env bash
# redis_repl_test.sh:专用实验中的轻量写入与只读保护验证
set -euo pipefail
[[ ${REDIS_DEDICATED_LAB:-} == YES ]] || { echo '需专用实验实例' >&2; exit 1; }
: "${REDISCLI_AUTH:?在当前终端输入认证值}"
master_ip=${MASTER_IP:-10.0.0.13}
replica_ip=${REPLICA_IP:-10.0.0.16}
port=${REDIS_PORT:-6379}
m=(redis-cli -e -h "$master_ip" -p "$port" --raw)
r=(redis-cli -e -h "$replica_ip" -p "$port" --raw)
field() { tr -d '\r' | awk -F: -v k="$1" '$1==k {print $2}'; }
[[ $("${m[@]}" PING) == PONG ]]
[[ $("${r[@]}" PING) == PONG ]]
mi=$("${m[@]}" INFO replication)
ri=$("${r[@]}" INFO replication)
[[ $(field role <<< "$mi") == master ]]
[[ $(field role <<< "$ri") == slave ]]
[[ $(field master_link_status <<< "$ri") == up ]]
key="repl_lab:$(date +%s):$$"
value="replication_ok_2026"
[[ $("${m[@]}" SET "$key" "$value" EX 300 NX) == OK ]]
matched=0
for ((i=0; i<100; i++)); do
    if [[ $("${r[@]}" GET "$key") == "$value" ]]; then matched=1; break; fi
    sleep 0.1
done
(( matched == 1 )) || { echo '样本未在期限内追平' >&2; exit 1; }
write_reply=$("${r[@]}" SET "$key:readonly" 1 EX 300 2>&1 || true)
[[ $write_reply == *READONLY* ]] || { echo "副本写入未被预期拒绝:$write_reply" >&2; exit 1; }
# 记录主历史的目标偏移,再等待副本达到它;不要求两次瞬时采样永远相等。
mi=$("${m[@]}" INFO replication)
id=$(field master_replid <<< "$mi")
target=$(field master_repl_offset <<< "$mi")
[[ $target =~ ^[0-9]+$ && -n $id ]]
caught_up=0
for ((i=0; i<100; i++)); do
    ri=$("${r[@]}" INFO replication)
    rid=$(field master_replid <<< "$ri")
    offset=$(field slave_repl_offset <<< "$ri")
    if [[ $rid == "$id" && $offset =~ ^[0-9]+$ ]] && (( offset >= target )); then
        caught_up=1
        break
    fi
    sleep 0.1
done
(( caught_up == 1 )) || { echo '副本未到达本轮目标历史与偏移' >&2; exit 1; }
printf 'PASS: 连接、角色、样本、只读保护;目标 offset=%s\n' "$target"
echo '未进行网络故障或部分重同步证明;测试键 300 秒后自然过期。'
原脚本输出两端 PONG、角色正确、偏移 23526 相等以及重绑后 30510 相等;这些仅保留为原轮次采样。没有中断复制链路的日志/计数证据,就不应将 PASS 标签解释为验证了部分重同步。异步 ACK 及本脚本都不能证明磁盘持久化或故障切换零丢失。
6.3 Redis Sentinel 哨兵高可用
6.3.1 职责、部署数量和故障边界
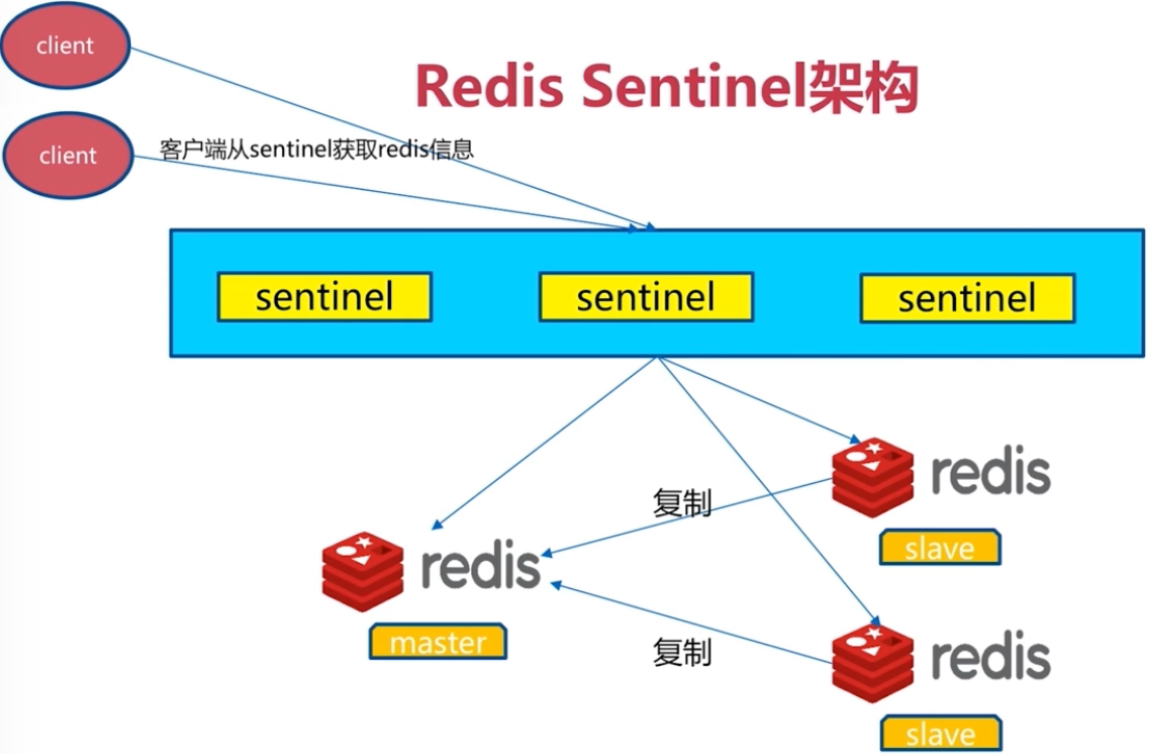
Sentinel是独立进程,常用26379,监控Redis主/副本、发现拓扑、判定故障、协调升主与重新配置,并提供当前主节点地址给客户端。它不代理普通GET/SET流量,不自动把空白机器配置成正确复制环境;需先搭好前节主从。独立业务端口不表示没有CPU/内存/网络争用。
Sentinel2自Redis2.8起是成熟实现,原“2.8以上即可用于生产”只是历史背景;实际选仍受支持并验证兼容的版本。本章延续8.4.0源码教学环境。
三个Sentinel分散在三个故障域是常见部署,单机三进程仅适合学习;同机宕机会同时失去仲裁能力。Sentinel也可和Redis同机,但主机/机架/网络故障域需评估,不能只数进程。
偶数数量不被协议禁止:4个也可以运行,其多数派为3;奇数通常以更少节点取得相同故障容忍度。3个节点也可能分成1/1/1而没有多数派,并非网络分区必然留出可切换分区。
| 条件 | 作用 |
|---|---|
| quorum | 足够Sentinel同意主节点不可达时,当前Sentinel可作ODOWN判断 |
| 多数派授权 | 发起切换者还需在该轮获得足够票数,通常至少已知Sentinel总数的严格多数,且满足所需quorum |
| 可用副本 | 需有通过筛选、允许升主的候选,否则即使选出执行者也无法完成升主 |
quorum不必始终等于半数+1,但改变它不会取消多数派授权。本例3个、quorum2,是常见组合。
Sentinel减少错误/冲突切换,但不对数据写入提供共识复制或强制旧主隔离。网络分区时旧主可能仍被部分客户端写入,恢复后降为副本会丢弃其分叉写入;异步复制也可能丢失已确认但未复制的写。min-replicas-to-write/min-replicas-max-lag等可缩小部分风险,不能变成严格零丢失或完整fencing。也不能把“借鉴多数派选举”直接说成业务数据使用Raft强一致。
6.3.2 周期任务、SDOWN 与 ODOWN
常见实现周期:约10秒向Redis发INFO刷新角色和副本;约2秒在Redis的 __sentinel__:hello 频道发布自身/主配置等信息互相发现;约1秒PING相关Redis和Sentinel。实际调度和故障过程可调整/加速,不是精确实时任务,也不是所有故障报告都通过hello广播。
sentinel monitor <主组名> <初始主IP> <端口> <quorum>
sentinel down-after-milliseconds <主组名> <毫秒>
sentinel parallel-syncs <主组名> <数量>
sentinel failover-timeout <主组名> <毫秒>
同一主组名需在相关Sentinel/客户端保持一致,未要求全世界所有实例名称唯一。
- SDOWN:一个Sentinel按本地连接/有效回复及阈值判断某对象疑似下线,不证明机器物理宕机;不能断言“大概率只是网络抖动”。
- ODOWN:针对主节点,本地SDOWN并结合足够同伴意见达到quorum,不代表全体获得一份强一致故障事实。
- 后续按epoch进行故障转移执行者选举和授权,只有取得必要票数者执行相应切换。已知Sentinel集合、各自观测和消息传播仍需时间。
原一般说明用30000ms,后续实验配置3000ms,两者不可混用;本实验3秒是本地故障判定相关阈值,不是总切换完成时间保证。
6.3.3 副本选择和客户端
先排除不可达、断链过久、状态不适合等候选,然后通常依次比较:
- replica-priority,较小非零值优先;0表示不参与升主,常见默认100。
- 复制offset较大优先。
- 相同条件下按run ID字典序等确定选择。
优先级先于offset,不能宣称一定选数据最新或完整的一台。Sentinel执行升主、确认promotion、让其他副本改跟新主;旧主可达并可管理后改为副本。必要的权限、masterauth、配置重写和数据同步失败均可影响恢复。
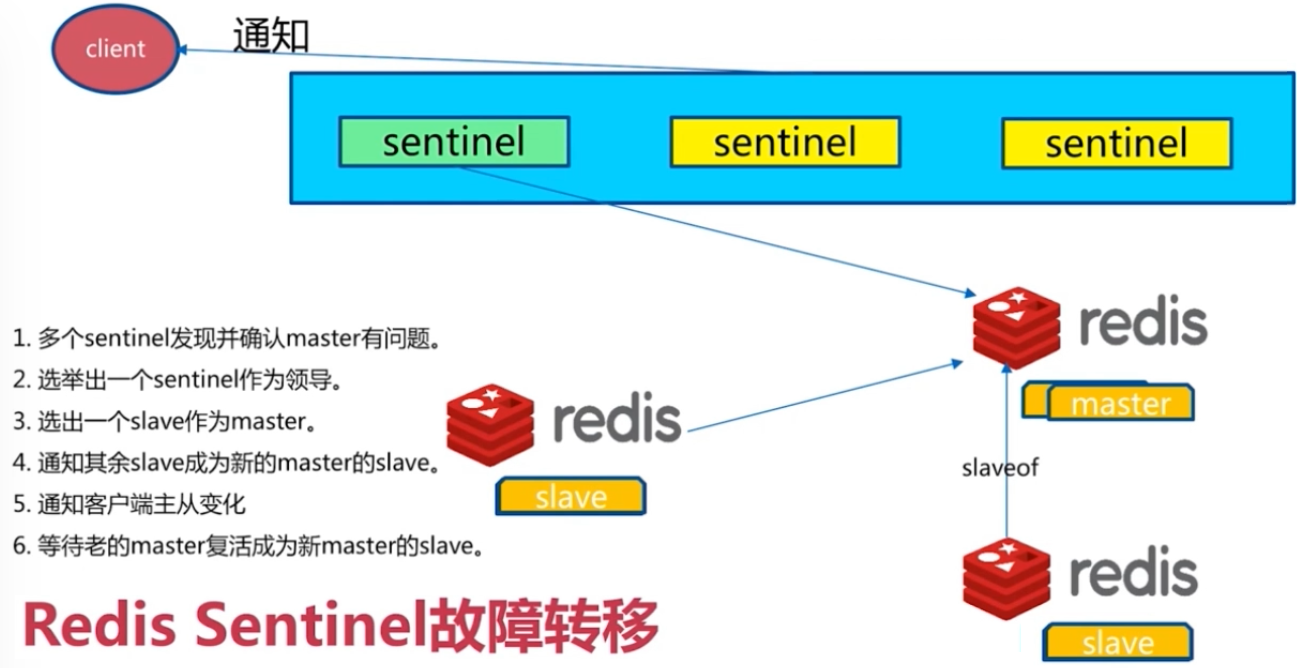
客户端需使用支持Sentinel的连接实现,按主组名向多个Sentinel查询,连接新地址并处理断线、写入未知结果、重试和幂等。可结合订阅 +switch-master 等事件,但Pub/Sub会丢通知,不能只订阅一次就保证永远知道当前主;普通固定地址客户端不会自动获得这些能力。故障转移期间已有请求/连接仍可能失败,不能称绝对无感。
6.3.4 三节点前提和认证
| 节点 | 初始Redis6379角色 | Sentinel |
|---|---|---|
| 10.0.0.13 | master | 26379 |
| 10.0.0.16 | replica,跟随13 | 26379 |
| 10.0.0.19 | replica,跟随13 | 26379 |
先按6.2的deploy_redis_ms.sh准备并验收。原入口为13执行master、16/19执行slave;不要为本节重跑部署覆盖已有数据。原复制观察:
role:master
connected_slaves:2
slave0:ip=10.0.0.16,port=6379,state=online,offset=3794,lag=1
slave1:ip=10.0.0.19,port=6379,state=online,offset=3794,lag=1
地址、顺序和offset以当前INFO为准。所有可能升主/降为副本的节点都要具备对应认证能力;初始主也配置masterauth,不能等其降级才发现缺凭据。
各节点实际IP分别替换,示例 .13:
bind 127.0.0.1 10.0.0.13 -::1
protected-mode yes
requirepass "Redis@2026"
masterauth "Redis@2026"
编辑已有准确配置项,避免反复append重复定义。在简单requirepass方案中同一主组统一口令便于复制和Sentinel管理;ACL可以用独立应用/复制/监控身份,不是技术上所有用途必须永远共用一个密码。需要时同时配置masteruser和Sentinel auth-user,权限按官方最小要求核对。
systemctl restart redis.service
redis-cli --askpass INFO replication
滚动重启时先查看当前角色与复制恢复,不能同时停掉所有节点。原把明文REDISCLI_AUTH写入/etc/profile.d向所有用户传播的做法不保留;后面CLI使用--askpass,Sentinel端和Redis端认证是不同连接。
6.3.5 Sentinel 配置与专用服务
原使用/apps/redis目录和forking服务。下面保留目录/参数含义,采用systemd管理前台进程,避免原双requirepass、共享root PID文件、命令行停机密码及未经支持的USR2 reload。
每台新实验Sentinel节点准备已有redis身份可写的配置和状态目录;先确认不覆盖现有Sentinel:
id redis
install -d -o redis -g redis -m 0750 /apps/redis/etc /apps/redis/log /apps/redis/data
/apps/redis/etc/redis-sentinel.conf,以下是.13版本;.16/.19仅把bind的本机私网地址分别改成实际地址,monitor初始均指13:
bind 127.0.0.1 10.0.0.13
protected-mode yes
port 26379
requirepass "Redis@2026"
daemonize no
loglevel notice
logfile "/apps/redis/log/sentinel.log"
dir /apps/redis/data
sentinel monitor mymaster 10.0.0.13 6379 2
sentinel auth-pass mymaster Redis@2026
sentinel sentinel-user default
sentinel sentinel-pass Redis@2026
sentinel down-after-milliseconds mymaster 3000
sentinel parallel-syncs mymaster 1
sentinel failover-timeout mymaster 180000
sentinel deny-scripts-reconfig yes
sentinel resolve-hostnames no
sentinel announce-hostnames no
sentinel master-reboot-down-after-period mymaster 0
auth-pass是Sentinel连接Redis的凭据;requirepass保护连入Sentinel的客户端;sentinel-user/pass供Sentinel之间认证,本例使用默认用户的密码方案,三台保持匹配。不要照抄原一个位置的auth-pass123456而Redis实际为Redis@2026。
chown redis:redis /apps/redis/etc/redis-sentinel.conf
chmod 0640 /apps/redis/etc/redis-sentinel.conf
Sentinel会持久重写配置、记录ID/epoch/已知节点,文件及所在目录须符合重写权限。不能把正常自动写出的当前主地址再用模板强制覆盖回13。
/etc/systemd/system/redis-sentinel.service:
[Unit]
Description=Redis Sentinel teaching service
Wants=network-online.target
After=network-online.target

[Service]
Type=simple
User=redis
Group=redis
WorkingDirectory=/apps/redis/data
ExecStart=/usr/local/bin/redis-sentinel /apps/redis/etc/redis-sentinel.conf
Restart=on-failure
RestartSec=3
KillSignal=SIGTERM
TimeoutStopSec=90
PrivateTmp=yes
NoNewPrivileges=yes
LimitNOFILE=65535
UMask=0077

[Install]
WantedBy=multi-user.target
原源码src/redis-sentinel路径也可运行,但应核对部署二进制与配置兼容;本例使用前文make install结果。若保留forking,必须匹配daemonize yes、受限运行目录和正确PIDFile,不能混用上述simple配置。Sentinel没有一个通用SIGUSR2重载配置合同,故不照抄ExecReload;身份/端口等变更按支持命令及滚动重启处理。
防火墙仅对三节点及实际管理/应用来源开放必要6379/26379,不用全网ALLOW。以Ubuntu .13 接受两个同伴为例:
ufw allow from 10.0.0.16 to any port 6379 proto tcp
ufw allow from 10.0.0.19 to any port 6379 proto tcp
ufw allow from 10.0.0.16 to any port 26379 proto tcp
ufw allow from 10.0.0.19 to any port 26379 proto tcp
其他节点按自身角色和已核对的管理通路设置,不在远程会话中盲目启用/重置防火墙。Sentinel发现/公布的地址必须对节点和客户端实际可达,NAT/容器环境可能需要额外announce配置。
systemctl daemon-reload
systemctl enable --now redis-sentinel.service
systemctl status redis-sentinel.service
tail -n 50 /apps/redis/log/sentinel.log
三台通过Redis的hello频道发现同伴,同时还需彼此Sentinel端口通信;不是只放行Redis端口即可。
6.3.6 状态查询和初次切换
redis-cli -p 26379 --askpass
SENTINEL MASTERS
SENTINEL MASTER mymaster
SENTINEL REPLICAS mymaster
SENTINEL SENTINELS mymaster
SENTINEL GET-MASTER-ADDR-BY-NAME mymaster
SENTINEL CKQUORUM mymaster
INFO sentinel
旧别名 SENTINEL SLAVES mymaster 在相应版本仍可用。原MASTERS字段:name mymaster、ip13、port6379、num-slaves2、num-other-sentinels2、quorum2。REPLICAS列16/19,master-link-status ok、master-host13、master-port6379、slave-priority100。
SENTINEL SENTINELS返回其他Sentinel,不包含当前查询者,本例正常应两条,而不是三条:
| 原同伴地址 | Sentinel ID | last-ok-ping-reply(ms,现场) |
|---|---|---|
| 10.0.0.16 | 35fac27e0c4e9ef98879d6e76b7d175e33aff7b9 | 72 |
| 10.0.0.19 | c6a51a698d1dfc641b572c477d6fe1f6c3897d1e | 1062 |
voted-leader显示?是原观测,不能靠一个历史字段保证从未切换。ping回复年龄应结合阈值与后续趋势判断,不把某个值独立宣称永远正常。
原连续停主实验只在专用环境执行,先确认当前主地址:
# .13初始确为主时
redis-cli --askpass SHUTDOWN
原随后在16的Sentinel看到主16,再在16关闭当前主:
# .16,确认它已是主,再模拟第二次关闭
redis-cli --askpass SHUTDOWN
原再由19成为主。Redis进程停机不等于同机Sentinel停机,三台Sentinel仍在所以可能继续仲裁;若是整机连同Sentinel一起丢失两台,则不能照此推断仍能授权切换。180秒相关失败重试时间和检测状态也影响连续实验,不保证每次固定几秒。
# .13和.16各自恢复自己的服务
systemctl start redis.service
grep -E '^[[:space:]]*replicaof[[:space:]]' /etc/redis/redis-6379.conf
原两者配置改为replicaof10.0.0.19 6379;需同时核对INFO role/link/同步进度,文件出现这一行不代表数据已经追平。恢复前如果旧主还有未复制数据,应先隔离业务、保留现场并明确数据取舍。
原INFO sentinel样本:
sentinel_masters:1
sentinel_tilt:0
sentinel_tilt_since_seconds:-1
sentinel_total_tilt:0
sentinel_running_scripts:0
sentinel_scripts_queue_length:0
sentinel_simulate_failure_flags:0
master0:name=mymaster,status=ok,address=10.0.0.19:6379,slaves=2,sentinels=3
tilt反映Sentinel的异常时间推进/事件循环保护状态,可能由时钟跳变或进程长时间未被调度触发;0不证明系统时钟完全准确。since_seconds/total_tilt等字段支持依版本。脚本数/队列0说明相应当前状态,simulate_failure_flags0不是完整故障历史。
master0中的sentinels3通常包含自身,与SENTINELS命令列两台同伴一致。原另写recent_failures/config_epoch/leader_epoch为固定INFO行,并非可假定所有版本都有的字段;按实际SENTINEL MASTER输出、配置和日志核对epoch。epoch用于选举/配置版本,较大不意味着某个节点拥有永久更高投票优先级,也不是业务事务提交序号。
6.3.7 三种故障实验及原始事件
先在19跟踪日志:
tail -f /apps/redis/log/sentinel.log
A. SHUTDOWN:19 → 16
原当时主为19,正常关闭:
# .19,先查询确认当前主
redis-cli --askpass SHUTDOWN
SHUTDOWN按持久化配置/选项执行有序退出,不保证每种模式都新写一份RDB,也不是kill/crash的等价模拟。原19日志的关键事件顺序和时间:
20:44:53.282 +sdown master mymaster 10.0.0.19 6379
20:44:53.285 Sentinel new configuration saved on disk
20:44:53.285 +new-epoch 3
20:44:53.287 +vote-for-leader 35fac27e0c4e9ef98879d6e76b7d175e33aff7b9 3
20:44:53.391 +odown master mymaster 10.0.0.19 6379 #quorum 3/2
20:44:53.391 Next failover delay: ... 20:50:53
20:44:54.410 +config-update-from sentinel ... 10.0.0.16 26379 @ mymaster 10.0.0.19 6379
20:44:54.410 +switch-master mymaster 10.0.0.19 6379 10.0.0.16 6379
20:44:54.411 +slave slave 10.0.0.13:6379 ... @ mymaster 10.0.0.16 6379
20:44:54.411 +slave slave 10.0.0.19:6379 ... @ mymaster 10.0.0.16 6379
20:44:54.415 Sentinel new configuration saved on disk
20:44:57.425 +sdown slave 10.0.0.19:6379 ... @ mymaster 10.0.0.16 6379
quorum3/2表示观察到3个同意下线、门槛2,不是只2个赞成。Next failover delay是该Sentinel再次发起相关尝试的时间约束,不是整个系统6分钟内不得再次切换的锁。180000ms可能产生2倍超时相关重试延迟,原不能一处称180秒一处称360秒且都说全局冷却。
恢复19:
systemctl start redis.service
redis-cli --askpass INFO replication
原20:51:50.637 -sdown slave19,20:52:00.613 +convert-to-slave slave19 ... master16。旧主可达后被改为16的副本;主从链路、数据和业务还需实际验收。
B. SIGKILL:16 → 13
原16主进程PID18747;每次必须从当前服务核对PID和角色,不能照抄这个数字:
systemctl show -p MainPID --value redis.service
ps -ef | grep '[r]edis-server'
# 仅专用实验,确认目标、故障持续方式与当前主后
kill -9 当前已核对的Redis主进程PID
SIGKILL不让Redis执行正常退出逻辑,但内核仍回收进程资源,不是“无资源回收”;它不模拟整机断电、磁盘缓存丢失、网络分区或进程卡住的全部语义。
原日志:
20:55:17.593 +sdown master mymaster 10.0.0.16 6379
20:55:17.708 Sentinel new configuration saved on disk
20:55:17.708 +new-epoch 4
20:55:17.709 +vote-for-leader 35fac27e0c4e9ef98879d6e76b7d175e33aff7b9 4
20:55:18.664 +odown master mymaster 10.0.0.16 6379 #quorum 3/2
20:55:18.664 Next failover delay: ... 21:01:18
20:55:18.810 +config-update-from sentinel ... 10.0.0.16 26379 @ mymaster 10.0.0.16 6379
20:55:18.810 +switch-master mymaster 10.0.0.16 6379 10.0.0.13 6379
20:55:18.810 +slave slave 10.0.0.19:6379 ... @ mymaster 10.0.0.13 6379
20:55:18.810 +slave slave 10.0.0.16:6379 ... @ mymaster 10.0.0.13 6379
20:55:18.817 Sentinel new configuration saved on disk
20:55:21.850 +sdown slave 10.0.0.16:6379 ... @ mymaster 10.0.0.13 6379
16的Sentinel还能当执行者不矛盾:被kill的是Redis进程,Sentinel进程仍活着。日志里的相对时序本身不证明是连续30秒无回复,本例配置下线阈值是3000ms。
C. DEBUG SEGFAULT:13 → 19
CONFIG GET enable-debug-command
CONFIG SET enable-debug-command yes
原返回no,再报 can't set immutable config。此类DEBUG只用于专用崩溃实验,不作为业务排障常规设置。若确要复现,只对本轮目标实验实例在受控配置中临时启用、重启,并核对其他节点健康;不必给所有业务节点永久开放:
enable-debug-command yes
systemctl restart redis.service
redis-cli -p 26379 --askpass SENTINEL GET-MASTER-ADDR-BY-NAME mymaster
原按13/16/19顺序重启后看到主13仅是现场结果,Sentinel不提供“照此重启必回13”的自动故障回切保证。确认当前主确为13后,原崩溃命令:
DEBUG SEGFAULT
原CLI Error: Server closed the connection,原日志2026-06-23:
| 时间 | 原事件及目标 |
|---|---|
| 21:07:41.854 | +sdown master13 |
| 21:07:41.919 | +odown master13,quorum2/2;+new-epoch5;+try-failover |
| 21:07:41.923 | 配置保存;投票给c6a51a698d1dfc641b572c477d6fe1f6c3897d1e,epoch5 |
| 21:07:41.937 | 35fac27e0c4e9ef98879d6e76b7d175e33aff7b9投票给该候选 |
| 21:07:41.938 | 53c9a081e927e68690aa08e0896c3bf40bb01db1投票给该候选 |
| 21:07:42.028 | +elected-leader;+failover-state-select-slave |
| 21:07:42.108 | +selected-slave19;+failover-state-send-slaveof-noone |
| 21:07:42.218 | +failover-state-wait-promotion |
| 21:07:42.753 | 配置保存;+promoted-slave19;+failover-state-reconf-slaves |
| 21:07:42.847 | +slave-reconf-sent16 |
| 21:07:43.050 | -odown master13 |
| 21:07:43.707 | +slave-reconf-inprog16;+slave-reconf-done16 |
| 21:07:43.768 | +failover-end;+switch-master mymaster13:6379 → 19:6379 |
| 21:07:43.768 | 新配置记录副本16及旧主13 |
| 21:07:43.770 | 配置保存 |
| 21:07:46.772 | +sdown slave13(仍未恢复) |
“发送升主命令→观察到晋升→其他副本改配置”是多阶段过程,switch-master是当前Sentinel更新主地址的重要事件,不代表所有业务连接都成功切换。原日志可支持该轮自动切换,不能证明零数据损失/业务零错误。
实验后在目标配置恢复enable-debug-command no,按角色和维护窗口重启,恢复此前调整的自动重启策略并核对完整一主两从。
6.3.8 日志解读与退役
三台日志不是逐字同步:各自观测、投票与执行角色不同,应结合多节点日志。+try-failover、+elected-leader、+selected-slave、+promoted-slave、+slave-reconf-*、+switch-master等应按实际版本分析;原列出的+failover-triggered、+replicate-slave、+slave-reconf-inbound不是可假定每版都有的标准事件,不据“没这行”断言失败。
| 现象 | 应核对 |
|---|---|
| 有SDOWN无ODOWN | 本地可达性、同伴意见、quorum、认证与通信,不一定只是网络故障 |
| 有ODOWN不开始/不完成切换 | 多数派授权、TILT、epoch/重试约束、候选副本资格、命令权限与配置 |
| 无switch-master | 阶段停在哪、晋升确认/重新配置、日志位置与当前主状态,不只检查密码 |
| 发现副本数不足 | 实际复制关系、INFO、认证、宣布地址与网络 |
| 同伴数不足 | 发现频道、Sentinel互联/认证、节点故障及配置 |
退役本轮各自Sentinel服务:
systemctl disable --now redis-sentinel.service
这会停止相应监控/自动切换能力,不删除Redis数据、不会让旧主自动恢复原角色,也不清除已持久化Sentinel拓扑。先停止依赖并规划替代,不删除共享用户或整个/apps/redis。原始数据和配置按恢复需要保留。
6.4 Redis Cluster分片与高可用
6.4.1 架构、槽和客户端路由
Sentinel在一套主从数据集内完成监控和故障转移,不负责把写入数据拆成多个主分片。Cluster提供原生分片,结合每个分片的复制和故障转移,可扩展总数据容量和部分负载的吞吐;单个热点键仍由一个槽的主节点处理,不能因此自动横向扩展。
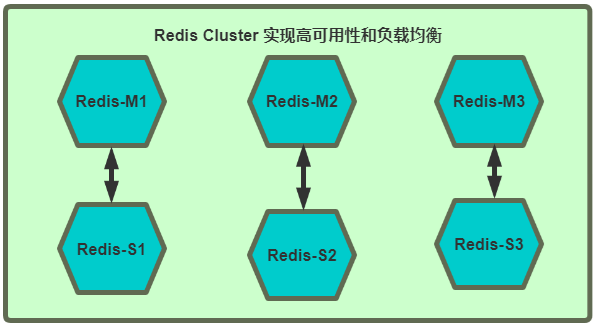
原稿采用3主3从作为完整教学拓扑。集群创建通常要求至少3个主节点;每主一个副本是常见高可用配置,但“Cluster技术上至少要6个进程”并不准确。生产还要分散故障域;本章所有实例位于一台机器,只能模拟进程故障,不能抵抗整机宕机。
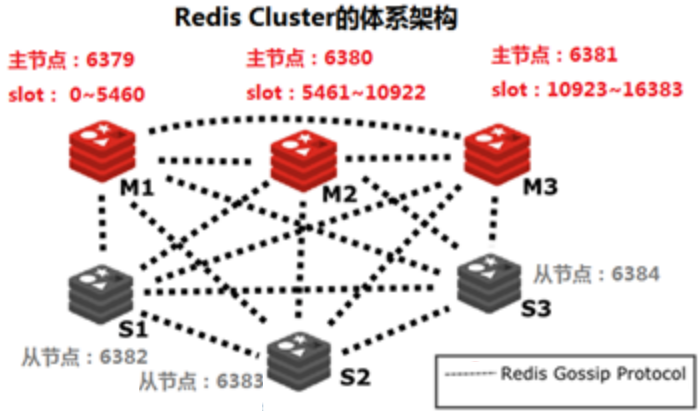
Cluster节点交换拓扑和故障信息,客户端按槽路由,不要求中心代理。Redis数据复制通常是异步的,元数据传播与复制数据一致性是两件事;发生故障和网络分区时,不能据Gossip或多数投票承诺零数据丢失。
槽计算。 总槽数固定为16,384,编号0~16,383。常规客户端公式为:
slot = CRC16(key_bytes) % 16384
这里使用Redis指定的CRC16/XMODEM计算方式;CRC是一种校验算法,在这里用于确定性分片,不提供密码学安全。键按字节计算,不是先按语言字符数运算。槽归属主节点,副本复制对应主节点数据,本身通常不独立承载已分配的主槽。
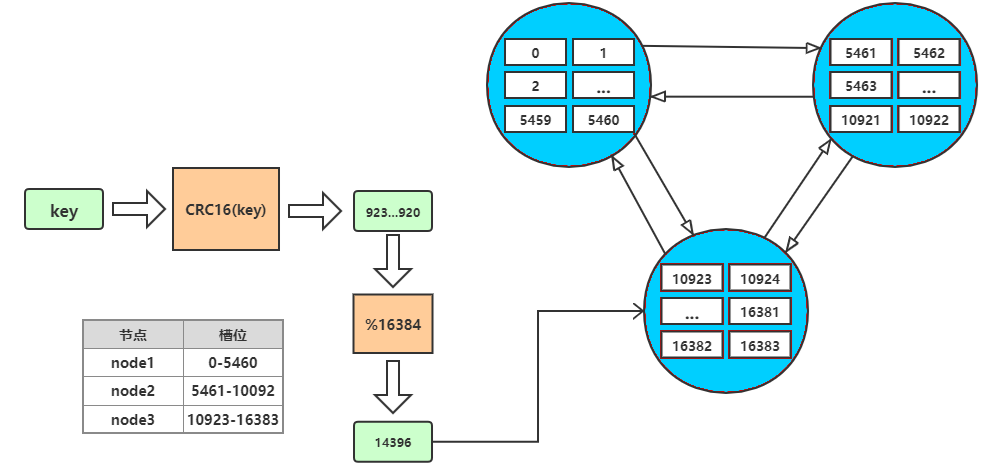
原图示例键映射到槽14396,再路由到持有10923~16383的主节点。稳定拓扑下,连接错误节点会收到正确目标的重定向;迁移、故障和陈旧路由可能带来多次重试,不保证所有情形“最多两次一定命中”。
Hash Tag。 键包含第一处{以及其后第一处},且中间至少有一个字节时,仅对这段内容计算槽;否则对完整键计算。例如{order}:100与{order}:pay同槽。{a}goods{c}:price使用a,空标签{}不会起到固定槽的作用,不能简单说任何第一对大括号都有效。
同槽键可用于支持的多键命令、事务和Lua;同一主节点上的两个不同槽,也不等于可以直接跨槽执行原子多键命令。把全业务键都写成{all}:...会挤到一个槽,失去分片作用;应按用户、商品、订单等需要共同操作的主体设计标签。
槽数量的取舍。 16,384位为2,048字节即2KiB,65,536位为8KiB。这是槽位位图部分的大小,不是完整心跳报文,也不是每个节点全部拓扑元数据只用2KiB。节点表、连接、状态和映射还占其他空间;现代协议/消息类型也不能一律概括为每个包固定携带相同位图。
| 总槽数 | 单个位图大小 |
|---|---|
| 16,384 | 2KiB |
| 65,536 | 8KiB |
固定16,384槽在分片粒度与元数据传播成本之间取舍,常规部署/客户端不能通过配置自由改槽总数。原关于约1,000主节点的描述属于设计规模/工程建议,不是Redis仅能存在1,000节点的硬限制,也不是超过这个数就应不经评估改Proxy。若要求每主至少一个槽,最多只能有16,384个持槽主节点,但还可以存在无槽节点;不应把它等同所有成员的总上限。
大量键通常可分散到各槽,但键数均衡不代表字节量或访问量均衡,哈希标签、大Key和热点仍会倾斜。一个槽不能同时作为两个主节点各自独立拥有的分片;传统迁移会逐键搬运槽内数据,不是一次原子搬完全部对象。
6.4.2 Gossip、故障判定与MOVED/ASK
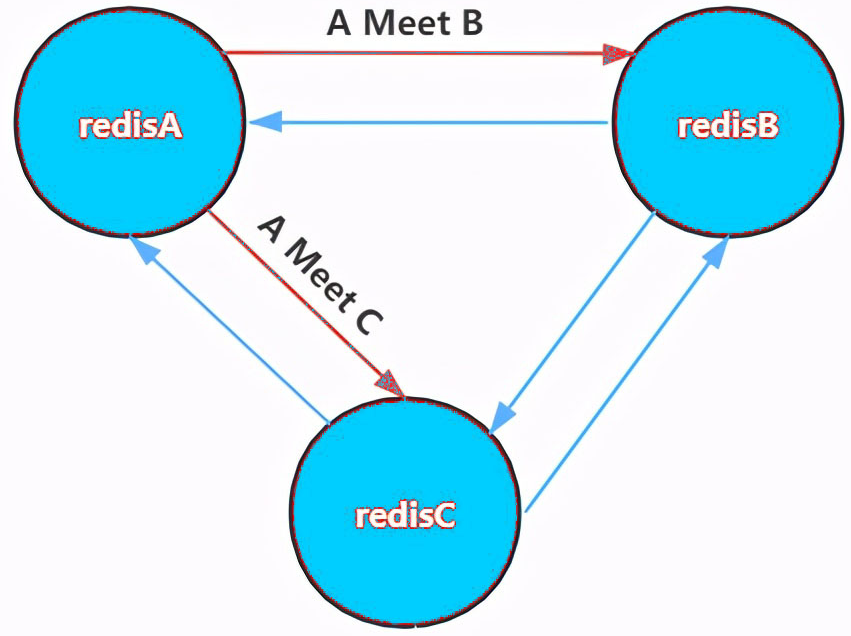
节点使用Cluster总线进行PING/PONG、发现、故障消息和配置传播。默认总线端口为业务端口+10,000,例如6379与16379;目标版本支持显式配置总线端口时不必固定如此。业务客户端使用业务端口,节点间还需要总线连通,复制也使用相应业务连接。并非业务客户端要把所有请求发到总线。
Gossip通过节点间消息逐步传播信息,发送频率和超时探测有具体实现规则,不是每秒向所有节点完整广播。原将Raft、Elasticsearch等直接列为“Gossip协议组件”过于笼统,Raft的共识机制不能与Gossip互换。
- PFAIL(疑似故障)。 某节点按超时等规则认为另一节点不可达,是局部观察,不是固定前15秒必然显示
fail?。 - FAIL。 需要结合有效主节点的故障报告和相应多数规则进行确认/传播,不是判定对方永久不能恢复。
- 故障转移。 合格副本在满足条件时请求持槽主节点投票并尝试提升。需要足够可通信的主节点、可用副本和相应配置;不是任意主节点一停机就必定成功。
默认cluster-require-full-coverage yes下,持槽主节点故障且未被接管时,可能使整个集群拒绝服务;即使关闭全槽覆盖要求,还受多数可达性等条件制约。因此不能笼统说“单分片故障只影响该分片,其他分片始终正常”。
客户端路由存在两类常见重定向:
| 响应 | 典型含义 | 客户端动作 |
|---|---|---|
MOVED slot ip:port |
接收节点认为该槽由目标负责,普通连错节点也会发生 | 重试并更新/刷新对应路由 |
ASK slot ip:port |
迁移中的键需要暂时到导入节点处理 | 对目标连接先发ASKING,再执行相应命令,不把临时目标当永久槽映射 |
ASK并非迁移中每个请求都会收到;源节点是否仍有键、命令是否多键等会影响响应,可能还有TRYAGAIN等情况。在线迁移借助这些机制支持服务继续处理,但不是所有业务完全无延迟、无错误。客户端必须能访问通告的真实地址,具备认证和合适的超时/重试。
Jedis、Redisson、go-redis等Cluster客户端通常维护槽映射;redis-cli -c主要是跟随重定向,不应描述成所有客户端都以相同方式提前计算/缓存整套路由。Cluster不支持多个逻辑数据库,应用也需核对命令兼容性。
Cluster与Sentinel对比:
| 维度 | Sentinel管理主从 | Cluster |
|---|---|---|
| 数据布局 | 一套全量主从,不原生分片 | 16,384槽分散到多个主分片 |
| 写入 | 该数据集的主节点 | 按键槽路由到对应主节点 |
| 读副本 | 客户端选择并承担延迟 | 需支持相应只读副本路由及其陈旧边界 |
| 故障转移 | 独立Sentinel协调 | Cluster节点内部机制 |
| 扩展容量 | 增副本不增加该数据集的唯一数据容量 | 新主接收槽可扩容,总体能力取决于负载与资源 |
| 多键操作 | 同一实例支持相应多键语义 | 原子多键操作通常要求同槽 |
| 故障影响 | 当前主的数据集可能暂时不可用 | 取决于副本、多数、全槽覆盖和客户端,不是绝对仅单分片 |
吞吐并非保证近似线性,适用范围也不由“百万键以内/以上”直接划线。Cluster已有自身故障管理,不应让Sentinel再管理同一套Cluster节点的主从切换;这与在不同数据集分别使用两种部署模式是两回事。
Pipeline本身不提供跨命令原子性。支持Cluster的客户端可以按目标节点分组/并行发送独立命令,不要求整批键全在同一槽;但一个MSET/MGET等多键命令的跨槽限制仍在,不能用Pipeline绕过。同节点不同槽的独立命令可以按节点分组,不能把“槽分组”与“节点分组”混为一谈。
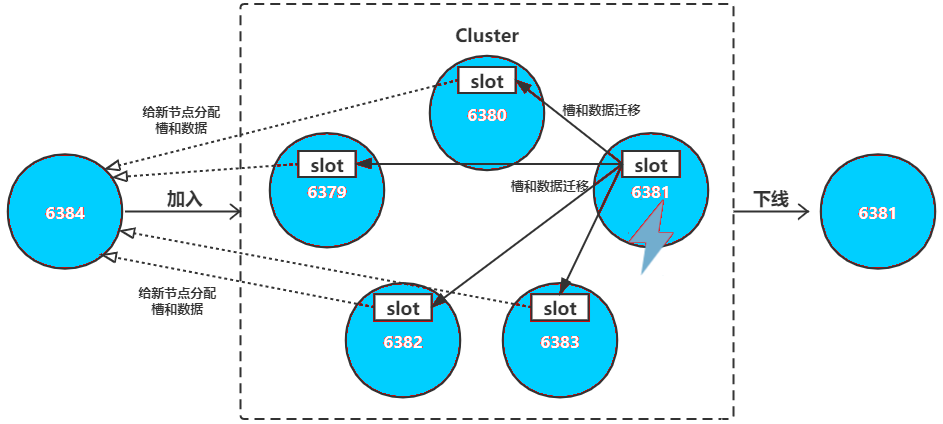
6.4.3 单机六实例准备
原实验环境:Ubuntu24.04,/usr/local/bin/redis-server,配置目录/etc/redis,数据按/var/lib/redis/<port>/隔离,使用redis@.service模板。六个进程是同机模拟,不具备主机级高可用。
初始计划把6379/6380/6381作为主、6382/6383/6384作为副本;实际--cluster create会分配副本,后面的真实输出为6379→6383、6380→6384、6381→6382,应以实际拓扑为准,不能沿用计划表误判。
若原独立Redis/Sentinel正占用这些端口,要先完成该实验的退出并按真实服务名停止;Cluster创建不要求先手工建立主从或启动Sentinel。原停用入口:
systemctl disable --now redis
systemctl disable --now redis-sentinel
这会影响原有服务,不是部署Cluster时可以随意对任何机器执行的前置。原直接rm -rf重建所有数据目录会销毁旧数据;下面新建流程遇到已有目录停止,不自动清除未知数据。
# 独立实验环境,redis用户/组及源码安装的可执行文件应已准备好。
for port in 6379 6380 6381 6382 6383 6384; do
  [[ ! -e /var/lib/redis/$port ]] || {
    printf '数据目录已存在,先核对:%s\n' "/var/lib/redis/$port" >&2
    exit 1
  }
done
install -d -m 0755 /etc/redis
install -d -m 0750 -o redis -g redis /var/log/redis
for port in 6379 6380 6381 6382 6383 6384; do
  install -d -m 0700 -o redis -g redis "/var/lib/redis/$port"
done
不把chown -R、chmod -R 700扩散到所有其他Redis实例目录。新目录拥有者需与模板服务运行用户一致;父路径也必须可穿越。
配置模板/etc/redis/redis-cluster-template.conf:
port ${PORT}
bind 127.0.0.1 10.0.0.13
protected-mode yes
daemonize no
pidfile /var/lib/redis/${PORT}/redis_${PORT}.pid
logfile /var/log/redis/redis-${PORT}.log

dir /var/lib/redis/${PORT}/
dbfilename dump.rdb
appendonly yes
appendfilename appendonly-${PORT}.aof
aof-use-rdb-preamble yes

cluster-enabled yes
cluster-config-file nodes-${PORT}.conf
cluster-node-timeout 15000
cluster-announce-ip 10.0.0.13

maxclients 10000
requirepass Redis@2026
masterauth Redis@2026
maxmemory 2gb
maxmemory-policy allkeys-lru
模板中的${PORT}是后面sed替换的标记,Redis不会自行按Shell环境展开它。这里将原bind 0.0.0.0与protected-mode no改为明确的实验地址和保留保护模式;公告地址必须是所有目标节点及客户端可达的地址,不能在其他机器照搬.13。
原称aof-use-rdb-preamble no能消除“Can't open the AOF manifest file”,这是错误归因;该选项控制AOF重写的RDB前导格式,不能修复不存在/不可读的manifest。上面保留常见的yes,出现manifest错误应检查实际多文件AOF目录、权限、磁盘及持久化状态,不通过关闭前导掩盖问题。
maxclients是客户端连接上限,不是最大文件句柄数;服务的LimitNOFILE还需留内部文件/连接空间。原每实例2GiB、六实例合计12GiB、八实例合计16GiB的maxmemory只是上限规划,不是内存不足的单机可以直接使用的推荐值;未计入其他开销、COW和系统资源,须先按实际主机重算。allkeys-lru还意味着任何缓存键都可能被淘汰。
本章用统一实验密码演示;requirepass/masterauth不等于TLS或细粒度ACL方案。配置文件应由管理员维护、服务用户可读,勿让普通用户读取所有实例凭据。
生成六份配置,已有文件则停止:
for port in 6379 6380 6381 6382 6383 6384; do
  [[ ! -e /etc/redis/redis-$port.conf ]] || exit 1
done
for port in 6379 6380 6381 6382 6383 6384; do
  sed "s/\${PORT}/${port}/g" /etc/redis/redis-cluster-template.conf \
    > "/etc/redis/redis-$port.conf"
  chown root:redis "/etc/redis/redis-$port.conf"
  chmod 0640 "/etc/redis/redis-$port.conf"
done
服务模板/etc/systemd/system/redis@.service:
[Unit]
Description=Redis Cluster Instance %I
Documentation=https://redis.io/documentation
Wants=network-online.target
After=network-online.target

[Service]
Type=simple
User=redis
Group=redis
ExecStart=/usr/local/bin/redis-server /etc/redis/redis-%I.conf
LimitNOFILE=65535
NoNewPrivileges=yes
PrivateTmp=yes
TimeoutStartSec=30
TimeoutStopSec=30
UMask=0077

[Install]
WantedBy=multi-user.target
前台daemonize no与Type=simple对应;simple启动返回并不代表Redis已可连接。原PrivateTmp=no与本例位于/var/lib/redis/<port>/的pid路径冲突没有因果关系,这里保留独立临时目录。OOMScoreAdjust=-900只是调整系统OOM选择倾向,不能解决资源不足或保证实例安全,本模板不据此把Redis一概设成几乎不被选中的进程。
停止时systemd默认发送SIGTERM给对应服务进程,不需要在命令行拼接明文密码来SHUTDOWN;应根据持久化耗时评估TimeoutStopSec,不能让短超时把慢退出变成强杀。
systemctl daemon-reload
for port in 6379 6380 6381 6382 6383 6384; do
  systemctl enable "redis@$port.service"
  systemctl start "redis@$port.service"
done
systemctl list-units 'redis@*.service'
原六节点状态:
redis@6379.service loaded active running Redis Cluster Instance 6379
redis@6380.service loaded active running Redis Cluster Instance 6380
redis@6381.service loaded active running Redis Cluster Instance 6381
redis@6382.service loaded active running Redis Cluster Instance 6382
redis@6383.service loaded active running Redis Cluster Instance 6383
redis@6384.service loaded active running Redis Cluster Instance 6384
6 loaded units listed.
网络访问只按来源开放。原ufw allow 6379:6384/tcp及ufw allow 16379:16384/tcp是全来源规则,不应直接作为生产配置。单机实例之间可经本机连接;若确需从实验内网访问,可按真实来源限定,例如:
ufw allow from 10.0.0.0/24 to any port 6379:6384 proto tcp
ufw allow from 10.0.0.13 to any port 16379:16384 proto tcp
ufw reload
多机时总线允许集群节点来源,业务端口按客户端/复制等所需来源规划;上述网段也不是对任意网络都最小的授权。
6.4.4 创建Cluster并校验拓扑
现代redis-cli的--cluster管理功能不依赖Python的redis-py。原在创建前要求pip3 install redis --break-system-packages没有必要,也不应为此绕过Ubuntu24.04的系统Python保护。只有另写Python客户端时才需要对应库,可使用独立venv或发行版的python3-redis;本节创建不执行这些安装。
客户端认证以当前终端交互输入,替代重复在-a参数中暴露实验密码:
read -r -s -p 'Cluster实验密码:' REDISCLI_AUTH
printf '\n'
export REDISCLI_AUTH
redis-cli --cluster create \
  10.0.0.13:6379 10.0.0.13:6380 10.0.0.13:6381 \
  10.0.0.13:6382 10.0.0.13:6383 10.0.0.13:6384 \
  --cluster-replicas 1
REDISCLI_AUTH仍属于进程环境中的凭据,不是绝对不可见。新节点应为空且没有旧的Cluster拓扑/未完成状态,不能把带业务数据的实例直接套入创建流程。
原分配、反亲和提示和创建过程:
>>> Performing hash slots allocation on 6 nodes...
Master[0] -> Slots 0 - 5460
Master[1] -> Slots 5461 - 10922
Master[2] -> Slots 10923 - 16383
Adding replica 10.0.0.13:6383 to 10.0.0.13:6379
Adding replica 10.0.0.13:6384 to 10.0.0.13:6380
Adding replica 10.0.0.13:6382 to 10.0.0.13:6381
>>> Trying to optimize slaves allocation for anti-affinity
[WARNING] Some slaves are in the same host as their master
Can I set the above configuration? (type 'yes' to accept): yes
>>> Nodes configuration updated
>>> Assign a different config epoch to each node
>>> Sending CLUSTER MEET messages to join the cluster
Waiting for the cluster to join
.
原节点身份与初始布局如下。所有ID都是原样本,新建集群必须从真实输出获取,不能复制旧ID到新环境:
| 地址 | 原节点ID | 初始角色/槽 |
|---|---|---|
.13:6379 |
ba1812aa6aa8efd7d0f43751ce01dbb5de8be2e9 |
主,0–5460,共5461槽 |
.13:6380 |
5e132dff69fbbfad1b33ad48077d8d6c291d9da5 |
主,5461–10922,共5462槽 |
.13:6381 |
cc0b5e74e5fb1861e8ac4678ce6d0da3f5636d2b |
主,10923–16383,共5461槽 |
.13:6382 |
6856d1a45769d9ba67cd57ce61b720589ef319e4 |
6381的副本 |
.13:6383 |
5c8bbf42957847aa2b54939f882eb53e388b96e9 |
6379的副本 |
.13:6384 |
f964150063b674381906bafb5eba3a436f04ecfc |
6380的副本 |
反亲和警告不妨碍观察单个进程故障切换,但也明确表示整机故障会同时失去所有主副本,不能称为生产高可用。
redis-cli -c -h 10.0.0.13 -p 6379
交互命令:
CLUSTER NODES
CLUSTER INFO
原CLUSTER NODES完整六成员记录:
5c8bbf42957847aa2b54939f882eb53e388b96e9 10.0.0.13:6383@16383 slave ba1812aa6aa8efd7d0f43751ce01dbb5de8be2e9 0 1782527660944 1 connected
f964150063b674381906bafb5eba3a436f04ecfc 10.0.0.13:6384@16384 slave 5e132dff69fbbfad1b33ad48077d8d6c291d9da5 0 1782527662037 2 connected
6856d1a45769d9ba67cd57ce61b720589ef319e4 10.0.0.13:6382@16382 slave cc0b5e74e5fb1861e8ac4678ce6d0da3f5636d2b 0 1782527661000 3 connected
ba1812aa6aa8efd7d0f43751ce01dbb5de8be2e9 10.0.0.13:6379@16379 myself,master - 0 0 1 connected 0-5460
5e132dff69fbbfad1b33ad48077d8d6c291d9da5 10.0.0.13:6380@16380 master - 0 1782527661000 2 connected 5461-10922
cc0b5e74e5fb1861e8ac4678ce6d0da3f5636d2b 10.0.0.13:6381@16381 master - 0 1782527659000 3 connected 10923-16383
@后是总线端口,myself表示当前连接节点;后面的slave、master等保留原协议输出名称。connected与主从数据是否完全同步不是同一判断。
原CLUSTER INFO:
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_pfail:0
cluster_slots_fail:0
cluster_known_nodes:6
cluster_size:3
cluster_current_epoch:6
cluster_my_epoch:1
cluster_stats_messages_ping_sent:292
cluster_stats_messages_pong_sent:286
cluster_stats_messages_sent:578
cluster_stats_messages_ping_received:281
cluster_stats_messages_pong_received:292
cluster_stats_messages_meet_received:5
cluster_stats_messages_received:578
total_cluster_links_buffer_limit_exceeded:0
cluster_slot_migration_active_tasks:0
cluster_slot_migration_active_trim_running:0
cluster_slot_migration_active_trim_current_job_keys:0
cluster_slot_migration_active_trim_current_job_trimmed:0
cluster_slot_migration_stats_active_trim_started:0
cluster_slot_migration_stats_active_trim_completed:0
cluster_slot_migration_stats_active_trim_cancelled:0
字段集合随版本变化;cluster_size:3表示持槽主节点数量,不是进程数6。epoch用于配置/选举相关版本管理,不是数据提交条数。
外部工具校验:
redis-cli --cluster check 10.0.0.13:6379
原创建时零数据摘要:
10.0.0.13:6379 (ba1812aa...) -> 0 keys | 5461 slots | 1 slaves.
10.0.0.13:6380 (5e132dff...) -> 0 keys | 5462 slots | 1 slaves.
10.0.0.13:6381 (cc0b5e74...) -> 0 keys | 5461 slots | 1 slaves.
[OK] 0 keys in 3 masters.
0.00 keys per slot on average.
>>> Performing Cluster Check (using node 10.0.0.13:6379)
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
工具还会列出上表相同的三主三副本及槽段,此处不重复整套身份。open slots主要涉及未完成的迁入/迁出状态,不能简单等同“没有数据的空槽”。覆盖完整、当时拓扑一致和键数统计通过,不足以验证未来故障切换、复制无丢失和所有业务读写语义。
6.4.5 路由、同槽多键与数据统计
带-c连接可跟随MOVED/ASK相应重定向;不带时仍能执行当前节点负责的命令,只是不自动跳到目标。
原交互写读:
10.0.0.13:6379> SET name sample
-> Redirected to slot [5798] located at 10.0.0.13:6380
OK
10.0.0.13:6380> SET age 40
-> Redirected to slot [741] located at 10.0.0.13:6379
OK
10.0.0.13:6379> SET job ops
OK
10.0.0.13:6379> GET name
-> Redirected to slot [5798] located at 10.0.0.13:6380
"sample"
10.0.0.13:6380> GET age
-> Redirected to slot [741] located at 10.0.0.13:6379
"40"
name=5798、age=741、job=2906是对应键的槽号;按当时初始布局分别由6380、6379、6379持有。数值40在String中以字符串形式返回。这里的“先连入口再跳转”不意味着成熟Cluster客户端每次都额外走一次中转。
跨槽MSET示例:
10.0.0.13:6379> MSET k1 v1 k2 v2 k3 v3 k4 v4 k5 v5
(error) CROSSSLOT Keys in request don't hash to the same slot
CLUSTER KEYSLOT k1
CLUSTER KEYSLOT k2
CLUSTER KEYSLOT k3
CLUSTER KEYSLOT k4
CLUSTER KEYSLOT k5
原返回分别为12706、449、4576、8455、12582。即使k2/k3落在同一主节点,仍是不同槽,不能直接放进该原子多键请求。不同标签也可能因CRC碰撞偶然同槽,不能说不同标签百分百不同槽。
同主体的哈希标签用法:
SET {user:100}:name zhangsan
SET {user:100}:phone 13800138000
MSET {user:100}:addr beijing {user:100}:email test@163.com
MSET {goods:100}:k1 v1 {goods:100}:k2 v2 {goods:100}:k3 v3
MGET {goods:100}:k1 {goods:100}:k2 {goods:100}:k3
最后返回"v1"、"v2"、"v3"。{user:100}这组槽号9308,{goods:100}这组槽号3067;会按实际当前主节点路由。
标签可含字母、数字、冒号、下划线等,例如{user1}、{order:20260627}、{shop_001}、{log-ops}。同用户可用{user:1000}:nick/:phone,同订单可用{order:888}:amount/:status;无标签的单键命令本来就合法,多对标签也不是语法禁止,只需理解仅第一处有效非空标签按前述规则参与计算。
若只是独立测试写入,可拆成多个单键命令:
SET k1 v1
SET k2 v2
SET k3 v3
SET k4 v4
SET k5 v5
-c可分别重定向,但这不是一个原子MSET,可能部分成功。应用批量API是否自行拆分、返回顺序及重试语义需要核对客户端实现。
不带-c的原演示:
redis-cli -h 10.0.0.13 -p 6379
10.0.0.13:6379> SET name sample1
(error) MOVED 5798 10.0.0.13:6380
改连真实目标:
redis-cli -h 10.0.0.13 -p 6380
10.0.0.13:6380> SET name sample1
OK
原另一次集群统计:
redis-cli --cluster check 10.0.0.13:6379
10.0.0.13:6379 (ba1812aa...) -> 5 keys | 5461 slots | 1 slaves.
10.0.0.13:6380 (5e132dff...) -> 1 keys | 5462 slots | 1 slaves.
10.0.0.13:6381 (cc0b5e74...) -> 0 keys | 5461 slots | 1 slaves.
[OK] 6 keys in 3 masters.
0.00 keys per slot on average.
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
它是原当时数据集快照,并不与本节把所有可选SET/MSET依次执行后的键数必然一致;不能把6写成上述全部命令必定产出的总数。0.00是少量数据下的格式化平均数,不是没有键。统计主节点避免副本重复计数,也不是跨持续写入集群的事务一致快照。
6.4.6 故障转移实验
初始映射为6379→6383、6380→6384、6381→6382。原通过systemd停止6379:
systemctl stop redis@6379.service
redis-cli -c -h 10.0.0.13 -p 6380 CLUSTER NODES
这是受控停止进程,不等同突然断电、强杀或网络分区的全部故障场景。cluster-node-timeout 15000单位为毫秒,影响失联探测,实际FAIL确认、选举、复制与客户端恢复还有其他耗时,不能保证正好15秒完成。
原故障后关键节点记录:
5e132dff69fbbfad1b33ad48077d8d6c291d9da5 10.0.0.13:6380@16380 myself,master - 0 0 2 connected 5461-10922
5c8bbf42957847aa2b54939f882eb53e388b96e9 10.0.0.13:6383@16383 master - 0 1782529865000 7 connected 0-5460
ba1812aa6aa8efd7d0f43751ce01dbb5de8be2e9 10.0.0.13:6379@16379 master,fail - 1782529845337 1782529843000 1 disconnected
6383已成为新主并持有0~5460;旧6379记录显示失联。后一次写读:
redis-cli -c -h 10.0.0.13 -p 6380
10.0.0.13:6380> SET test_failover2 123456
-> Redirected to slot [5120] located at 10.0.0.13:6383
OK
10.0.0.13:6383> GET test_failover2
"123456"
槽5120属于被接管区间,这说明完成切换后的这次操作成功,不证明故障前后全部请求无报错、无中断。检测/选举时可能发生超时、连接失败或CLUSTERDOWN;客户端重试还需要考虑写命令是否已成功等不确定性。
恢复6379:
systemctl start redis@6379.service
redis-cli -c -h 10.0.0.13 -p 6380 CLUSTER NODES
原恢复后记录:
5c8bbf42957847aa2b54939f882eb53e388b96e9 10.0.0.13:6383@16383 master - 0 1782530437627 7 connected 0-5460
ba1812aa6aa8efd7d0f43751ce01dbb5de8be2e9 10.0.0.13:6379@16379 slave 5c8bbf42957847aa2b54939f882eb53e388b96e9 0 1782530436544 7 connected
旧主在接纳新拓扑后成为6383的副本,不会因为端口较小或“原来是主”就自动抢回角色。6383也不是从此永久固定为主,后续故障或人工操作仍可改变角色。恢复复制可能部分同步也可能全量同步,取决于复制历史等条件,不能一律断言读取nodes文件后必定全量同步。
redis-cli --cluster check 10.0.0.13:6383
原某次恢复检查的摘要和角色关系:
10.0.0.13:6383 (5c8bbf42...) -> 6 keys | 5461 slots | 1 slaves.
10.0.0.13:6381 (cc0b5e74...) -> 1 keys | 5461 slots | 1 slaves.
10.0.0.13:6380 (5e132dff...) -> 2 keys | 5462 slots | 1 slaves.
[OK] 9 keys in 3 masters.
0.00 keys per slot on average.
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
此时主6383的副本是6379,主6380的副本是6384,主6381的副本是6382。原9键也是快照,不把未列出的写入步骤补造为自动产生。该实验演示了满足条件时自动接管及旧主回归;单机反亲和警告仍然存在,不能因此验证整机高可用或零丢数。
6.4.7 扩容到四主四副本
接续故障实验,此时6383/6380/6381为主,6379/6384/6382为副本。新增6385为主、6386为其副本。只加入一个空主节点并不会自动重新分配已有槽,还需要迁移。
新节点独立数据目录、配置和服务:
for port in 6385 6386; do
  [[ ! -e /var/lib/redis/$port && ! -e /etc/redis/redis-$port.conf ]] || exit 1
done
for port in 6385 6386; do
  install -d -m 0700 -o redis -g redis "/var/lib/redis/$port"
  sed "s/\${PORT}/${port}/g" /etc/redis/redis-cluster-template.conf \
    > "/etc/redis/redis-$port.conf"
  chown root:redis "/etc/redis/redis-$port.conf"
  chmod 0640 "/etc/redis/redis-$port.conf"
done
systemctl start redis@6385.service redis@6386.service
systemctl enable redis@6385.service redis@6386.service
原先的六端口防火墙规则不包括新端口,若该实验确有相应限制,需要将业务6385/6386和总线16385/16386按同样的真实来源规划加入。两个新实例也要纳入整机内存预算,不能继续无上限叠加原2GiB配置。
加入空主6385:
redis-cli --cluster add-node 10.0.0.13:6385 10.0.0.13:6383
原版本的独有加入过程:
>>> Adding node 10.0.0.13:6385 to cluster 10.0.0.13:6383
>>> Performing Cluster Check (using node 10.0.0.13:6383)
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
>>> Getting functions from cluster
>>> Send FUNCTION LIST to 10.0.0.13:6385 to verify there is no functions in it
>>> Send FUNCTION RESTORE to 10.0.0.13:6385
>>> Send CLUSTER MEET to node 10.0.0.13:6385 to make it join the cluster.
[OK] New node added correctly.
FUNCTION相关行来自原工具/服务版本,不等于每个旧版redis-cli都会打印。新主原ID为0b573e86546cd18a0a5212b187cd1525f7ee40bd,刚加入时0槽。
迁入4096槽:
redis-cli --cluster reshard 10.0.0.13:6385
原交互:
How many slots do you want to move (from 1 to 16384)? 4096
What is the receiving node ID? 0b573e86546cd18a0a5212b187cd1525f7ee40bd
Please enter all the source node IDs.
  Type 'all' to use all the nodes as source nodes for the hash slots.
  Type 'done' once you entered all the source nodes IDs.
Source node #1: all
Ready to move 4096 slots.
Do you want to proceed with the proposed reshard plan (yes/no)? yes
reshard入口地址只是用来发现集群,真正目标由receiving node ID指定;all让工具从合适的其他主节点规划迁出,不是根据CPU、内存或键热度做全局负载均衡。在原三主槽数几乎相等的条件下,抽取后可以达到各4096槽;其他起点不保证全体精确平均。
原计划中展示了从6380移动槽5461、从6383移动到槽1364等条目,完整4096条逐槽列表原文没有展开。本次新主接收的完整槽段:
0-1364       1365 slots
5461-6826    1366 slots
10923-12287  1365 slots
total        4096 slots
对应旧三主剩余:
| 主节点 | 剩余槽 | 数量 |
|---|---|---|
| 6383 | 1365–5460 | 4096 |
| 6380 | 6827–10922 | 4096 |
| 6381 | 12288–16383 | 4096 |
| 6385 | 0–1364、5461–6826、10923–12287 | 4096 |
迁移包含导入/迁出状态、数据搬运和槽归属更新,客户端可能遇到ASK/MOVED、额外延迟及重试;不能把工具支持在线迁移说成全程无报错或所有业务无感。仅槽数相等也不等于内存/读写负载相等。
给6385添加6386副本:
redis-cli --cluster add-node 10.0.0.13:6386 10.0.0.13:6385 \
  --cluster-slave \
  --cluster-master-id 0b573e86546cd18a0a5212b187cd1525f7ee40bd
原输出:
>>> Adding node 10.0.0.13:6386 to cluster 10.0.0.13:6385
>>> Performing Cluster Check (using node 10.0.0.13:6385)
M: 0b573e86546cd18a0a5212b187cd1525f7ee40bd 10.0.0.13:6385
   slots:[0-1364],[5461-6826],[10923-12287] (4096 slots) master
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
>>> Send CLUSTER MEET to node 10.0.0.13:6386 to make it join the cluster.
Waiting for the cluster to join
>>> Configure node as replica of 10.0.0.13:6385.
[OK] New node added correctly.
原6386节点ID:9e656c74a29e91d37fa3f561a5387bd11dd80b55。原流程先迁入槽再加副本,在这段时间新主持槽但没有副本保护;不把它描述成全流程始终已有四主四副本保护。实际变更顺序应结合风险和同步状态安排。
扩容校验:
redis-cli --cluster check 10.0.0.13:6383
10.0.0.13:6383 (5c8bbf42...) -> 5 keys | 4096 slots | 1 slaves.
10.0.0.13:6385 (0b573e86...) -> 2 keys | 4096 slots | 1 slaves.
10.0.0.13:6381 (cc0b5e74...) -> 1 keys | 4096 slots | 1 slaves.
10.0.0.13:6380 (5e132dff...) -> 1 keys | 4096 slots | 1 slaves.
[OK] 9 keys in 4 masters.
0.00 keys per slot on average.
S: 9e656c74a29e91d37fa3f561a5387bd11dd80b55 10.0.0.13:6386
   slots: (0 slots) slave
   replicates 0b573e86546cd18a0a5212b187cd1525f7ee40bd
M: 0b573e86546cd18a0a5212b187cd1525f7ee40bd 10.0.0.13:6385
   slots:[0-1364],[5461-6826],[10923-12287] (4096 slots) master
   1 additional replica(s)
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
在原这次快照中,键总数9与扩容前一致,分片数和成员关系符合计划;副本复制进度、内存、应用行为等仍需分别验证。
6.4.8 缩容回三主三副本
原目标是移除6385主及6386副本,保留其余六节点。必须先确保待移除节点不再拥有要保留的槽/数据,并检查剩余拓扑及容量;直接关闭持槽主可能造成不可用,是否永久丢数取决于副本和持久化等,不能把所有关机都一概写成永久丢失。
原示范先移除6386,再迁出6385所有槽,最后移除6385。这是该次操作顺序,不是任何生产变更都必须先拿掉副本保护;先删副本会让6385在余下迁移期间失去这一副本,需要明确风险。
先查询真实身份:
redis-cli -c -h 10.0.0.13 -p 6383 CLUSTER NODES
原6386记录:
9e656c74a29e91d37fa3f561a5387bd11dd80b55 10.0.0.13:6386@16386 slave 0b573e86546cd18a0a5212b187cd1525f7ee40bd 0 1782531948000 8 connected
移除并停止原副本:
redis-cli --cluster del-node 10.0.0.13:6386 \
  9e656c74a29e91d37fa3f561a5387bd11dd80b55
systemctl stop redis@6386.service
systemctl disable redis@6386.service
原输出:
>>> Removing node 9e656c74a29e91d37fa3f561a5387bd11dd80b55 from cluster 10.0.0.13:6386
>>> Sending CLUSTER FORGET messages to the cluster...
>>> Sending CLUSTER RESET SOFT to the deleted node.
此处保留/var/lib/redis/6386、/etc/redis/redis-6386.conf及日志用于核对和恢复,不以删除文件代替从集群移除。原文随后用rm -rf清理该节点数据/配置,那属于销毁已退役数据的额外动作,不是缩容必须步骤。
迁出6385的4096槽。 扩容完成时6385持有0~1364、5461~6826、10923~12287,分别1365、1366、1365,共4096槽。原计划分三轮,仅以6385为source:
| 轮次 | 接收节点及原ID | 数量 | 唯一source |
|---|---|---|---|
| 1 | 6383,5c8bbf42957847aa2b54939f882eb53e388b96e9 |
1366 | 6385,0b573e86546cd18a0a5212b187cd1525f7ee40bd |
| 2 | 6380,5e132dff69fbbfad1b33ad48077d8d6c291d9da5 |
1365 | 同上 |
| 3 | 6381,cc0b5e74e5fb1861e8ac4678ce6d0da3f5636d2b |
1365 | 同上 |
原文字提示有一处把receiving node和source写反;receiving必须填保留节点,source必须填待移除6385。不要填all,否则会把其他保留主节点也纳入迁出来源。
三轮都从同一入口发现集群,接收者由交互ID决定,不由命令入口端口决定:
# 第一轮
redis-cli --cluster reshard 10.0.0.13:6383
How many slots do you want to move (from 1 to 16384)? 1366
What is the receiving node ID? 5c8bbf42957847aa2b54939f882eb53e388b96e9
Source node #1: 0b573e86546cd18a0a5212b187cd1525f7ee40bd
Source node #2: done
Do you want to proceed with the proposed reshard plan (yes/no)? yes
# 第二轮
redis-cli --cluster reshard 10.0.0.13:6383
How many slots do you want to move (from 1 to 16384)? 1365
What is the receiving node ID? 5e132dff69fbbfad1b33ad48077d8d6c291d9da5
Source node #1: 0b573e86546cd18a0a5212b187cd1525f7ee40bd
Source node #2: done
Do you want to proceed with the proposed reshard plan (yes/no)? yes
# 第三轮
redis-cli --cluster reshard 10.0.0.13:6383
How many slots do you want to move (from 1 to 16384)? 1365
What is the receiving node ID? cc0b5e74e5fb1861e8ac4678ce6d0da3f5636d2b
Source node #1: 0b573e86546cd18a0a5212b187cd1525f7ee40bd
Source node #2: done
Do you want to proceed with the proposed reshard plan (yes/no)? yes
done仅结束源节点列表。每次必须阅读实际迁移计划再确认,不能把旧ID或旧槽数盲目输入当前环境。若确实从四主各4096槽的起点按本表执行,最终槽数应为6383=5462、6380=5461、6381=5461、6385=0;槽段由实际计划/执行结果核对,不保证恢复最初完全相同的边界。
原记录的矛盾。 原第一次/第二次/第三次reshard附近还出现以下状态,保留以免把原输出删成“全部符合预期”:
M: 5c8bbf42957847aa2b54939f882eb53e388b96e9 10.0.0.13:6383
   slots:[0-5461],[6827-8191],[12288-13652] (8192 slots) master
   1 additional replica(s)
M: 0b573e86546cd18a0a5212b187cd1525f7ee40bd 10.0.0.13:6385
   slots:[5462-6826],[10923-12287] (2730 slots) master
M: 5e132dff69fbbfad1b33ad48077d8d6c291d9da5 10.0.0.13:6380
   slots:[8192-10922] (2731 slots) master
   1 additional replica(s)
M: cc0b5e74e5fb1861e8ac4678ce6d0da3f5636d2b 10.0.0.13:6381
   slots:[13653-16383] (2731 slots) master
   1 additional replica(s)
这些各阶段片段中的6383已是8192槽,而另外两个原主各2731,不是“从各4096起点只把6385迁出1366给6383”能得到的状态;原文未提供足以解释差异的完整操作记录。不能把它们当作上述三轮计划连续执行的正确预期。当前环境若也已变成这种布局,需先重新核对实际槽分配和目标容量,再决定迁移,不能继续机械照抄三轮数量。
原迁出后另一次检查摘要:
10.0.0.13:6383 (5c8bbf42...) -> 7 keys | ... slots | 1 slaves.
10.0.0.13:6381 (cc0b5e74...) -> 1 keys | ... slots | 2 slaves.
10.0.0.13:6380 (5e132dff...) -> 1 keys | ... slots | 1 slaves.
[OK] 9 keys in 3 masters.
0.00 keys per slot on average.
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
原摘要中槽数本来就以省略号展示,并声称6385已成为6381副本。空主在特定拓扑/版本条件下可能转为副本,但不能把“迁出最后一个槽”无条件等同自动变成最后接收者的副本;应查询真实CLUSTER NODES、角色和键数。若已是副本,后面是移除这个空副本;若仍是无槽主,则是移除空主,不能把身份写死。
移除6385并完成校验:
redis-cli --cluster check 10.0.0.13:6383
redis-cli -h 10.0.0.13 -p 6385 CLUSTER NODES
确认待删ID、0持有槽、无未迁出数据/迁移状态以及剩余副本关系后:
redis-cli --cluster del-node 10.0.0.13:6383 \
  0b573e86546cd18a0a5212b187cd1525f7ee40bd
systemctl stop redis@6385.service
systemctl disable redis@6385.service
原删除输出:
>>> Removing node 0b573e86546cd18a0a5212b187cd1525f7ee40bd from cluster 10.0.0.13:6383
>>> Sending CLUSTER FORGET messages to the cluster...
>>> Sending CLUSTER RESET SOFT to the deleted node.
随后保留6385的数据、配置和日志,检查剩余集群:
redis-cli --cluster check 10.0.0.13:6383
redis-cli -h 10.0.0.13 -p 6383 CLUSTER NODES
6.4.9 整套实验退役与原销毁操作辨析
正常缩容需要前面的迁出与成员移除;整套停止后不再提供服务,是另一种退役场景,不是扩缩容步骤。本节仅保留教材内容,未在工作区执行。
原使用pkill -9 -f redis-server会强杀所有匹配实例,可能误伤独立Redis、其他端口和业务数据;rm -rf /var/lib/redis/*、删除/etc/redis/redis-6*.conf、删除/var/log/redis/redis-*.log等也超出已确认对象。这些原命令表达的是全机范围的破坏性销毁,不能作为本套实验的常规退役方式。
退役时只停止本套已核实的模板实例及其开机自启,保留数据、配置和日志。以下是本章六节点的明确入口;如果6385/6386仍在运行,按其实际身份另行停用,不重新创建已退役节点:
systemctl disable --now redis@6379.service redis@6380.service redis@6381.service \
  redis@6382.service redis@6383.service redis@6384.service
systemctl list-units --all 'redis@*.service'
如退出/持久化失败,应查对应服务和进程,不用全局SIGKILL代替排查;也要确认没有手工以同一数据目录启动的进程。整套退役会停止服务,但RDB、多文件AOF及自动生成的nodes配置继续保存在对应数据目录,不能把它说成已经销毁或可直接当空节点创建。
如果目的确实是丢弃整套实验数据、从空节点重建,应另行确认数据保留决定、备份及每个实例实际持久化位置,再针对那些已确认对象处理;本节不把原通配删除扩成通用可执行销毁脚本。共享redis@.service与Cluster配置模板也不在停止服务时无条件删除。
原最后的systemctl daemon-reload只让systemd重读单元定义,不会清空Redis内存、重置槽、删除拓扑或删除持久化文件。原“重置集群残留缓存,所有槽和主从关系清零”的说明应删除;只有明确处理完各实例实际状态后,才可按对应流程恢复或重建,不能声称一次daemon-reload就全机无任何残留。
7. Redis 常见问题管理
本章接续大Key、缓存和MySQL联动实验。原环境先将10.0.0.13恢复为独立Redis实例;仅启动一个服务并看到role:master,不足以证明它已经脱离Sentinel/Cluster或清除了旧复制配置,应结合前章实际部署核对。以下是教材内容,没有执行清库、写入、服务变更或数据库命令。
7.1 大Key的判定、扫描与风险
7.1.1 用容量、元素数和访问方式共同判定
大Key没有适合所有业务的统一生产红线。原稿使用下列告警起点,需结合延迟目标、单元素大小、命令复杂度、网络和实例规模调整:
| 类型 | 原稿排查阈值 | 关注点 |
|---|---|---|
| String | 单键约100KiB及以上 | 读取/写入的字节量、带宽和缓冲区 |
| List/Set | 10,000个元素及以上 | 全量读取、集合运算、删除成本 |
| Hash/ZSet | 5,000个字段/成员及以上 | 全量遍历、范围结果量、编码与维护成本 |
| 任意类型 | MEMORY USAGE超过512KiB |
对元素数阈值的补充 |
“100KB”和“512KB”不是相互独立的String兜底边界:达到512KiB自然也超过100KiB。Hash的字段名、值、对象和分配器都有成本,不能用“6,000×10字节”直接当Redis总内存;这个元素数也已经超过表中的5,000阈值。
Hash/List/Set/ZSet不是到了某个成员数就突然变慢,关键还包括所调用的命令。HLEN、LLEN、SCARD、ZCARD通常是常数复杂度;HGETALL、SMEMBERS需要遍历和返回全部内容;ZRANGE常见为O(log N+M),ZRANK常见为O(log N),不能统称所有ZSet查询都为前者。大结果量本身还会占用网络及客户端资源。
MEMORY USAGE big:string:profile
HLEN big:hash:order
LLEN big:list:msg
SCARD big:set:members
ZCARD big:zset:hotrank
MEMORY USAGE返回字节数,包括相关内存开销;复合类型默认会采样内部元素,SAMPLES 0检查全部元素时成本可能更高。它与String的有效载荷长度不是同一口径。
7.1.2 生成四类测试数据
在原稿独立实验实例使用密码Redis@2026。下面用客户端交互读取密码,避免把-a Redis@2026反复写进命令行;REDISCLI_AUTH也仍属于客户端进程环境中的凭据。
read -r -s -p 'Redis实验密码:' REDISCLI_AUTH
printf '\n'
export REDISCLI_AUTH
redis-cli -h 10.0.0.13 -p 6379 INFO replication
原服务启动与角色记录:
systemctl start redis
role:master
原稿后续使用本机默认连接,需确认本机就是该实验节点。生成命令会占用主线程和内存,尤其EVAL中的循环,不能当作线上无成本检查。
# Bash生成204800个ASCII字节,即200KiB;管道通过-x把标准输入作为最后一个参数。
printf 'a%.0s' {1..204800} | redis-cli -x SET big:string:userprofile
redis-cli EXPIRE big:string:userprofile 86400
redis-cli EVAL "for i=1,6000 do redis.call('HSET',KEYS[1],'field_'..i,'value_data') end" 1 big:hash:orderlist
redis-cli EVAL "for i=1,12000 do redis.call('LPUSH',KEYS[1],'msg_'..i) end" 1 big:list:message
redis-cli EVAL "for i=1,8000 do redis.call('ZADD',KEYS[1],i,'rank_'..i) end" 1 big:zset:hotrank
原String写入返回OK,设置过期返回1。三个Lua脚本没有return,客户端显示(nil)正常,不表示没有写入;仍应检查实际结果。
redis-cli STRLEN big:string:userprofile
redis-cli HLEN big:hash:orderlist
redis-cli LLEN big:list:message
redis-cli ZCARD big:zset:hotrank
原独立初始数据的结果依次为204800、6000、12000、8000。重复运行会再次增加List元素,已有同名错误类型键也会使脚本失败;不能无条件承诺每次都是这些结果。
7.1.3 --bigkeys扫描
redis-cli -h 10.0.0.13 -p 6379 --bigkeys
redis-cli -h 10.0.0.13 -p 6379 --bigkeys -i 0.1
--bigkeys基于SCAN逐步遍历当前逻辑数据库。它对String统计长度,对集合统计元素/字段/成员数,并不按每个键实际内存排序。需要内存口径时结合当前客户端支持的--memkeys或定点MEMORY USAGE,不能把--bigkeys中的“biggest list”说成内存最大的List。
原客户端提示-i 0.1为每100次SCAN命令休眠0.1秒,不是每100个键;一次SCAN返回多少键只是增量扫描的行为,COUNT也不是硬性上限。
原四个键的摘要:
100.00% ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
Keys sampled: 4
-------- summary -------
Total key length in bytes is 72 (avg len 18.00)
Biggest list found "big:list:message" has 12000 items
Biggest hash found "big:hash:orderlist" has 6000 fields
Biggest string found "big:string:userprofile" has 204800 bytes
Biggest zset found "big:zset:hotrank" has 8000 members
1 lists with 12000 items (25.00% of keys, avg size 12000.00)
1 hashs with 6000 fields (25.00% of keys, avg size 6000.00)
0 streams with 0 entries (00.00% of keys, avg size 0.00)
1 strings with 204800 bytes (25.00% of keys, avg size 204800.00)
0 sets with 0 members (00.00% of keys, avg size 0.00)
1 zsets with 8000 members (25.00% of keys, avg size 8000.00)
Total key length是键名字节数,不是数据总内存。扫描中的百分比和统计是工具当时观察到的样本,不是持续变更数据的事务一致快照;SCAN可能重复返回,扫描中新增/删除键也会影响结果。没有Set/Stream只说明这个库这次没观察到,不能推广为全实例没有风险。
SCAN避免KEYS *一次性全库遍历,但每次命令仍会执行,整个扫描也会消耗CPU和网络。原建议在00:00–04:00低峰、每日一次、分节点分批扫描,这些是排期示例,应以业务负载和监控确定频率。Cluster要逐主分片排查,单次连接一个节点不代表扫描了整个集群;其他逻辑DB也要分别考虑。
7.1.4 大Key的风险
- 持久化和COW。
fork()通常不立即复制全部数据页,但复制页表也可能带来可观察的主线程停顿,时间并非始终极短。后台持久化期间,父进程修改的内存页可能触发写时复制;复制单位是页,不是“修改一个大Key就完整复制整个Key”。频繁大范围改写会放大额外内存和带宽开销,程度取决于实际写入和页布局。 - 网络和缓冲。 全量读取大对象会增大编码、响应和传输成本。是否因
client-output-buffer-limit断连,取决于客户端类型和实际配置;普通客户端的默认限制与副本、Pub/Sub不同,不能声称读大Key必定触发断连。 - 分片失衡和迁移。 Cluster一个键属于一个槽,通常完整落在一个主分片。大键可能集中内存/访问压力,迁移对应对象也有成本。MIGRATE等同步操作可能阻塞相关实例一段时间,但不能说迁移期间整个槽全部数据必然一直不可访问。
- 同步释放。 默认DEL释放复杂大集合可能造成明显延迟。String单块对象通常释放成本较低,也不等于任何超大String都完全无延迟;配置、分配器、编码和相关清理都会影响实际行为。
7.2 大Key的拆分、压缩和删除
7.2.1 String按业务维度拆分
原稿给出String50KiB、Hash1,000字段、List/Set5,000元素、ZSet3,000成员的拆分目标。它们是示例工程目标,并非Redis官方强制标准;还需测量每个元素/字段的字节量以及访问成本。
用户档案按基础信息、扩展信息和订单拆分:
| 原键/分键 | 内容 | 访问方式 |
|---|---|---|
user:info:1001 |
原完整JSON | 原来一次读取全部 |
user:info:1001:base |
uid、姓名、手机、性别 | 列表页高频读取 |
user:info:1001:extend |
地址、银行卡、信用分 | 详情按需读取 |
user:info:1001:order |
订单数组 | 单独加载,必要时进一步分页/拆分 |
原稿称原对象224KB,但下面示例并未实际填充到该大小,其MEMORY USAGE历史输出是425字节。把文字“扩充至220KB”写入JSON不会真的生成220KB数据。
redis-cli SET user:info:1001 '{"uid":1001,"name":"张三","phone":"13800138000","gender":"男","address":"北京市朝阳区XX街道XX小区10号楼1单元501室长文本长文本长文本长文本长文本长文本长文本长文本长文本长文本","bankInfo":"6222021102012345678","creditScore":920,"historyOrder":["order1","order2","大量订单文本扩充至220KB"]}' EX 86400
redis-cli MEMORY USAGE user:info:1001
redis-cli SET user:info:1001:base '{"uid":1001,"name":"张三","phone":"13800138000","gender":"男"}' EX 86400
redis-cli SET user:info:1001:extend '{"address":"北京市朝阳区...","bankInfo":"6222021102012345678","creditScore":920}' EX 86400
redis-cli SET user:info:1001:order '["大量订单文本"]' EX 86400
redis-cli --raw GET user:info:1001:base
redis-cli --raw GET user:info:1001:extend
redis-cli --raw GET user:info:1001:order
原三个GET分别返回上述基础JSON、扩展JSON、订单数组。确认应用已完成写入/读取切换并处理并发、TTL和回退后,才可清理原键:
redis-cli UNLINK user:info:1001
原返回1,键已从逻辑键空间移除;这不能作为后台内存已经全部释放的证明。分成三个SET也不是跨键原子更新,不能把拆分自动视为数据一致性改进。
7.2.2 Hash按订单号取模拆分
原订单Hash有6,200个字段,按订单号%8分为8个Hash。本例订单号1~6,200均匀分布,每片775字段;一般业务分布不保证均匀,“固定8片”也不能无条件保证每片不超过1,000。
redis-cli EVAL "for i=1,6200 do redis.call('HSET',KEYS[1],'order_'..i,'order_detail_json_data_1001') end" 1 'user:order:{1001}'
redis-cli HLEN 'user:order:{1001}'
原HLEN返回6200。下面完整迁移示例修正原perSliceLimit定义后未检查、动态拼接未声明目标键等问题,所有目标键显式列入KEYS。只用于本例已停写的独立实验数据,目标键必须为空缺。 Lua脚本内部HGETALL及全部写入仍是一次同步执行;分片不是让这个迁移脚本后台运行。
redis-cli --raw EVAL "
local source = KEYS[1]
local sliceCount = 8
local perSliceLimit = 1000
if #KEYS ~= sliceCount + 1 then
return redis.error_reply('need source and eight target keys')
end
if redis.call('EXISTS', source) == 0 then
return redis.error_reply('source does not exist')
end
for i=2,#KEYS do
if redis.call('EXISTS', KEYS[i]) ~= 0 then
return redis.error_reply('target already exists')
end
end
local fields = redis.call('HGETALL', source)
local slices = {}
for i=0,sliceCount-1 do slices[i] = {} end
for i=1,#fields,2 do
local field = fields[i]
local idText = string.match(field, '^order_(%d+)$')
if not idText then return redis.error_reply('invalid order field') end
local orderNo = tonumber(idText)
local index = orderNo % sliceCount
table.insert(slices[index], field)
table.insert(slices[index], fields[i+1])
if #slices[index] / 2 > perSliceLimit then
return redis.error_reply('slice exceeds demo field limit')
end
end
for i=0,sliceCount-1 do
if #slices[i] > 0 then
redis.call('HSET', KEYS[i+2], unpack(slices[i]))
end
end
return 'split complete: 8 targets'
" 9 'user:order:{1001}' \
'user:order:{1001}_0' 'user:order:{1001}_1' \
'user:order:{1001}_2' 'user:order:{1001}_3' \
'user:order:{1001}_4' 'user:order:{1001}_5' \
'user:order:{1001}_6' 'user:order:{1001}_7'
原脚本使用HMSET,这里用支持多字段写入的HSET。脚本中途运行错误不保证回滚已经完成的写入,预检查也不能把任意资源不足都变成事务回滚。超大对象应另行设计渐进迁移和应用切换,不能把本例HGETALL脚本作为生产通用方案。
验证命令与原数量:
for i in {0..7}; do
key="user:order:{1001}_$i"
count=$(redis-cli --raw HLEN "$key") || exit 1
[[ $count =~ ^[0-9]+$ ]] || exit 1
printf '分片%s | 字段总数:%s\n' "$key" "$count"
done
redis-cli HGET 'user:order:{1001}_3' order_123
分片user:order:{1001}_0 | 字段总数:775
分片user:order:{1001}_1 | 字段总数:775
分片user:order:{1001}_2 | 字段总数:775
分片user:order:{1001}_3 | 字段总数:775
分片user:order:{1001}_4 | 字段总数:775
分片user:order:{1001}_5 | 字段总数:775
分片user:order:{1001}_6 | 字段总数:775
分片user:order:{1001}_7 | 字段总数:775
"order_detail_json_data_1001"
123%8=3,因此读取user:order:{1001}_3。原键在校验和业务切换后清理:
redis-cli UNLINK 'user:order:{1001}'
共同的{1001}是Cluster哈希标签,所有分键仍会位于同一槽、同一主分片。 这能缩小单对象操作范围,但不能分散这个用户的总内存或热点到多个Cluster节点;HGET和HLEN原本也不是因字段超过1,000就失去常数复杂度。
7.2.3 ZSet按销量分数区间拆分
原排行榜rank:sale包含12,000个商品。原四段为0~1,000、1,001~5,000、5,001~10,000、10,001~999,999,适用于这个整数样本,但会漏掉小数边界、负分和999,999以上的值。下面保留四段结构,改为连续边界-inf~1000、(1000~5000、(5000~10000、(10000~+inf,避免边界空隙。
redis-cli EVAL "for i=1,12000 do redis.call('ZADD',KEYS[1],i,'goods_'..i) end" 1 rank:sale
redis-cli ZCARD rank:sale
原ZCARD返回12000。迁移脚本每批最多500个成员,减少一次unpack参数数量;全部批次仍在同一个EVAL内执行,不会向其他请求让出主线程。原动态目标键也改为KEYS显式提供。
redis-cli --raw EVAL "
if #KEYS ~= 5 then return redis.error_reply('need source and four target keys') end
if redis.call('EXISTS', KEYS[1]) == 0 then
return redis.error_reply('source does not exist')
end
for i=2,5 do
if redis.call('EXISTS', KEYS[i]) ~= 0 then
return redis.error_reply('target already exists')
end
end
local source = KEYS[1]
local slices = {
{key=KEYS[2], min='-inf', max='1000'},
{key=KEYS[3], min='(1000', max='5000'},
{key=KEYS[4], min='(5000', max='10000'},
{key=KEYS[5], min='(10000', max='+inf'}
}
local batchSize = 500
for _,slice in ipairs(slices) do
local offset = 0
while true do
local members = redis.call('ZRANGEBYSCORE', source, slice.min, slice.max,
'WITHSCORES', 'LIMIT', offset, batchSize)
if #members == 0 then break end
local args = {}
for i=1,#members,2 do
table.insert(args, members[i+1])
table.insert(args, members[i])
end
redis.call('ZADD', slice.key, unpack(args))
offset = offset + batchSize
end
end
return 'all slices copied'
" 5 rank:sale rank:sale:0 rank:sale:1 rank:sale:2 rank:sale:3
本例按原环境限定为独立实例。这些键名不共享哈希标签,在Cluster不能直接作为跨槽EVAL执行。按分数分区还需要处理商品分数变化时从旧分区移除、进入新分区,以及跨分区排名/Top N的合并问题;不等于原所有排序操作无改动可用。
redis-cli ZCARD rank:sale:0
redis-cli ZCARD rank:sale:1
redis-cli ZCARD rank:sale:2
redis-cli ZCARD rank:sale:3
redis-cli ZREVRANGE rank:sale:3 0 3 WITHSCORES
原整数样本的分区数和最高四个商品:
1000
4000
5000
2000
1) "goods_12000"
2) "12000"
3) "goods_11999"
4) "11999"
5) "goods_11998"
6) "11998"
7) "goods_11997"
8) "11997"
第二、三分区分别4,000和5,000成员,并未满足原稿“每ZSet不超过3,000”的目标;分数区间不会自动控制成员数,还需按实际分布重新规划。ZREVRANGE ... 0 3只返回4个成员,原键上相同数量的范围查询也不会读取全部12,000个;不能据此宣称一定提升数倍。拆分后迁移是否有延迟也需实际测量。
确认全部成员、分数及应用切换后,原示例清理源键:
redis-cli UNLINK rank:sale
7.2.4 客户端Gzip压缩
文本JSON可由客户端序列化后Gzip压缩,以二进制String存储;读取时由客户端解压,Redis本身不理解Gzip。原用gz:前缀区分编码。压缩率、压缩CPU、响应延迟和兼容版本都需评估,不能假设任意JSON都会从220KiB压到很小。
另一类优化是精简字段和选择合适的原生编码。listpack是Redis内部紧凑容器,实际用于哪些类型取决于版本和配置;List可能采用quicklist及其节点编码,整数Set常见intset,不能把所有整数列表统称为“采用Listpack”。使用下面命令观察实际结果:
MEMORY USAGE gz:user:info:10001
OBJECT ENCODING gz:user:info:10001
原先清理的两个实验键:
redis-cli UNLINK user:info:10001 gz:user:info:10001
user_raw.json的示例内容:
{
"uid": 10001,
"nick": "测试用户",
"phone": "13800138000",
"address": "北京市朝阳区XX街道XX小区1号楼2单元301室",
"tag": ["VIP", "母婴用户", "线下到店"],
"orderList": [
{"orderId": "OD20260627001", "amount": 299},
{"orderId": "OD20260627002", "amount": 599}
]
}
原命令for i in {1..1000}; do cat user_raw.json >> big_user.json; done会把1,000个对象直接拼接,得到多个JSON值,不是一个合法JSON文档;追加模式重复运行也会累积内容。下面仍用Bash和cat,手工修正为一个测试数组,并覆盖输出文件:
{
printf '[\n'
for i in {1..1000}; do
if (( i > 1 )); then printf ',\n'; fi
cat user_raw.json
done
printf '\n]\n'
} > big_user.json
gzip -c big_user.json > big_user.gz
gzip -t big_user.gz
redis-cli -x SET gz:user:info:10001 < big_user.gz
redis-cli MEMORY USAGE gz:user:info:10001
redis-cli -x SET user:info:10001 < big_user.json
redis-cli MEMORY USAGE user:info:10001
gzip -c把压缩数据写到标准输出;这里由重定向明确创建big_user.gz。gzip -t验证压缩流,原gunzip -c big_user.gz > /dev/null也可作完整解压检查。
原“重复拼接文本”样本内存分别为:
gz:user:info:10001 -> 1829
user:info:10001 -> 327714
这些是原字节流、Redis版本、编码和分配器下的历史值,不是修正后JSON数组的保证输出,也不是有效载荷的精确长度。高度重复文本特别容易压缩,不能据此推算真实档案的通用压缩比。上面写入没有EX,两个测试键会保留到主动删除或相应淘汰。
读取压缩值时保持二进制完整,支持-D参数的redis-cli可取消原始响应分隔符后解压:
redis-cli --raw -D '' GET gz:user:info:10001 | gzip -dc > user_decoded.json
业务客户端应直接读取bytes再解压,不把压缩数据先按UTF-8文本解码。压缩后单键仍然可能很大,也不解决热点、并发更新和缓存一致性。
7.2.5 UNLINK与渐进删除
| 命令 | 逻辑删除与内存回收 | 使用边界 |
|---|---|---|
DEL key |
默认在主线程删除并释放对象 | 小对象通常合适;复杂大对象可能阻塞 |
UNLINK key |
先移除键;达到内部异步释放条件时交给后台线程 | 减少复杂对象回收的主线程开销 |
UNLINK big_hash_key
DEL big_hash_key
原稿把UNLINK分界说成“64字节”,这不正确。相关实现按对象的释放工作量估计及引用计数等条件判断,常见阈值为64个内部工作单位,具体随类型/编码/版本变化,不是统一字节大小。大型String通常释放工作量估计仍很小,可能同步释放;UNLINK并不保证每个对象一定进后台线程。lazyfree-lazy-user-del等配置也可能改变DEL的回收方式。
一次UNLINK传入大量键仍需主线程查找、移除键和处理相关元数据。原每批不超过100键是起始示例,应根据实际延迟和对象分布调批量/间隔;后台回收也会消耗CPU和内存带宽,不能称为完全无阻塞、无代价。
7.3 缓存雪崩、穿透与击穿
| 问题 | 典型触发 | 数据库压力来源 |
|---|---|---|
| 雪崩 | 大量缓存集中失效,或缓存服务整体不可用 | 许多业务键同时回源 |
| 穿透 | 反复查询不存在的数据 | 缓存长期没有有效命中 |
| 击穿 | 一个高并发热点键失效 | 同一资源的并发回源 |
7.3.1 雪崩
- 过期时间随机偏移。 在合理范围加入抖动,分散批量预热/写入的到期点。
lazyfree-lazy-expire yes可影响符合条件的过期对象释放方式,但不消除过期检查、COW、扫描或回源压力,更不自动解决雪崩。 - 本地+分布式缓存。 Caffeine等本地缓存可承接部分流量,需限制容量、规划TTL并处理多实例失效传播。简单设置“本地TTL更短”不保证各层不会同一时刻失效。
- 限流、熔断、降级。 按接口/资源观测数据库QPS、超时和异常,限制回源并发;降级可返回允许的旧副本、静态结果或明确的繁忙状态。不能对所有业务一律返回空数据并声称正确。
- 可用性与恢复。 Sentinel/Cluster及持久化各自减少某类故障影响,持久化不是高可用的替代品;Redis故障时也不能无限制把全部流量直连数据库。
- 热点不设物理TTL。 配合主动刷新、容量和陈旧度监控可减少过期触发;仍可能被allkeys策略淘汰、人工删除或节点故障移除,不能“彻底规避”所有雪崩。
7.3.2 穿透
先校验ID、格式、字符串长度、分页和范围等参数。它有工程成本,也不能拦截所有格式合法却不存在的ID,不应称为零成本杜绝全部无效查询。
数据库未找到结果时,可缓存约定的空标记,例如:
SET user:10099 "" EX 300
应用必须区分“键不存在”和“键存在但为空值”,否则仍会反复回源。TTL300秒只是示例,还应限制空键总量、考虑新数据建立后的失效动作,防止随机ID攻击把缓存填满。
布隆过滤器可先登记合法ID,再在读取路径过滤“肯定不存在”的请求。正确构建、所有合法ID及时加入且过滤器可用时,标准布隆过滤器没有假阴性;“可能存在”仍有假阳性。过滤器漏同步、丢数据或构建不完整时,不能以数学性质保证数据库里100%没有该记录。
RedisBloom等模块/产品支持相关结构,是否内置、可用以及集群支持需按部署版本确认。频繁新增数据并非天然不能使用,关键是增量更新、重建、可见性顺序及故障处理;常规布隆过滤器也不能直接删除成员。可先采用参数校验与空值缓存,再按访问分布、误判率和成本决定是否增加过滤器。
7.3.3 击穿
- 互斥回源。 一次只让少量请求加载热点数据,其余请求有限等待、退避或降级。原SETNX思路需要补足唯一持有者标识、原子带租期加锁、正确释放和超时;分开SETNX再EXPIRE会存在无过期锁窗口。高并发场景也可以采用请求合并,不能一概说不推荐。
- 逻辑过期。 值中记录逻辑到期时间,允许时立即返回旧数据,后台更新。仍需以互斥/单飞等方式限制重建者,否则每个请求都开异步更新会再次压垮数据库;因此不是天然“无锁方案”。更新失败告警、旧数据最大可接受时间、冷数据回收都要明确。
- 提前预热。 在到期前、启动时或业务低峰更新热点,控制批量与并发;提前刷新也可能失败或多实例同时触发。
- 热点副本。 多个含相同数据的键只有在实际落到不同分片、应用分散读取时才可能分担压力;需要维护更新和失效一致性。带相同哈希标签的键仍在同一槽,复制键名本身不保证分散负载。
7.4 Redis内存治理与淘汰策略
7.4.1 maxmemory与进程实际内存
原稿以独立16GiB机器将maxmemory设为12GiB、预留25%为示例:
maxmemory 12gb
redis-cli INFO memory
这里的gb按Redis配置单位解释为1024进制。maxmemory是实例参与内存控制的重要阈值,不是操作系统对整个Redis进程RSS、所有缓冲、碎片、子进程和COW内存的硬上限。某些复制/AOF缓冲不计入对应淘汰判定;命令临时分配也可能让用量短时越过阈值。
原70%~80%可作为某些独占缓存节点的初始估计,但不是防OOM保证,超过80%也不是必然立刻崩溃。后台持久化期间大量页面被改写时,COW额外内存可能显著大于20%~30%;同机其他服务、容器/cgroup限制、碎片、客户端缓冲和操作系统也要计入预算。
原未设置上限时的输出解释:
maxmemory:0
maxmemory_human:0B
maxmemory_policy:noeviction
常见64位部署中maxmemory=0表示Redis不设置该数据内存上限,仍受系统/容器资源约束,不是可无限使用内存。持续增长可能触发系统OOM并被杀死,缓存是否可恢复还取决于持久化和副本状态,不能一律说“全部永久丢失”。
7.4.2 八种淘汰策略
原稿列七种,漏了allkeys-random;常见支持LFU的版本共有以下八种:
| 策略 | 候选范围/规则 | 取舍 |
|---|---|---|
noeviction |
不自动淘汰 | 超限时拒绝部分需要增加内存的命令,适合明确不允许静默丢键并能处理写失败的场景 |
volatile-lru |
只在带TTL的键中,按近似LRU淘汰 | 保留永久键,但TTL键不足时可能无法释放够内存 |
volatile-lfu |
只在带TTL的键中,按近似LFU淘汰 | 适合访问频率有明显区分的可淘汰键 |
volatile-random |
随机淘汰带TTL的键 | 不优先保护热点,仍可用于符合其随机淘汰语义的场景 |
volatile-ttl |
优先淘汰TTL较短的键 | 按近似候选选择,不等同所有键精确全局排序 |
allkeys-lru |
全部键中按近似LRU淘汰 | 全部数据均允许缓存丢失时常用 |
allkeys-lfu |
全部键中按近似LFU淘汰 | 关注热点频次,频率估计还带有衰减 |
allkeys-random |
全部键中随机淘汰 | 简单随机策略,无LRU/LFU热点优先保证 |
LRU关注最近访问时间,LFU关注估计频率,Redis并非始终维护所有键的精确全局LRU/LFU排序。volatile-*没有足够带TTL候选时,也可能表现为无法腾出空间并拒绝相关写入。
noeviction不能概括为“拒绝所有写命令”,例如DEL等释放内存的命令仍有意义。原错误示例:
OOM command not allowed when used memory > 'maxmemory'.
这通常与Redis配置的内存阈值/命令语义有关,不等于操作系统物理内存已经完全耗尽。业务应处理缓存写失败和后续回源压力。它不是所有生产场景都禁止的危险配置;用Redis保存不可随意淘汰的数据时,静默淘汰反而可能违背需求。
原在线修改示例:
redis-cli CONFIG GET maxmemory-policy
redis-cli CONFIG SET maxmemory-policy volatile-lru
修改立即影响对应运行实例;是否写入配置文件需用实际配置管理或允许时CONFIG REWRITE处理。不能把volatile-lru定成所有业务统一最优解,也不能只靠它保证永久键无限增长不会占满实例。allkeys策略会包含不设TTL的键。
7.4.3 后台持久化的内存预留
fork后父子进程共享数据页,父进程新增/修改相关页面时可能发生COW。除了RDB后台保存,AOF重写和复制同步的相应路径也可能涉及fork;是否使用无盘复制等还要看配置。
原优化建议保留为以下有条件的措施:
- 结合实际COW峰值、RSS、碎片、缓冲和系统/容器上限设置maxmemory,32/64GiB大实例不能只按固定70%就认为安全。
- 可调度的后台保存尽量避开密集写入高峰,同时考虑恢复点目标,不能只为低峰而失去必要备份。
appendfsync everysec常用于平衡刷盘开销与数据损失窗口;always也有其耐久性需求场景。刷盘频率不等于应用修改内存页的频率,改成everysec不会自动减少业务COW。- 在副本进行某些备份可减轻主节点对应备份任务的负担,但主节点仍可能因全量同步、其他持久化任务等触发fork,不是“主节点完全无内存压力”。
- 监控后台保存状态及相关COW/内存趋势,并核对任务失败原因。
redis-cli INFO persistence
关注rdb_last_bgsave_status等版本支持的字段。原日志:
fork: Cannot allocate memory
可能涉及可用内存、提交限制/overcommit、页表和容器限制等,不能只凭一行就认定唯一原因。下调maxmemory也不保证立即释放数据或马上让fork成功,应核对真实内存及可淘汰候选、备份状态,再决定减载、回收或扩容。
7.5 缓存架构模式
7.5.1 Cache-Aside旁路缓存
应用负责Redis和数据库之间的逻辑,Redis不会主动读取MySQL。
读路径:应用读缓存,命中则返回;未命中时查数据库,再按策略回填缓存并返回。写路径常见为先提交数据库事务,再使对应缓存失效;下次读取重新装载。
它实现简单、边界明确,适合许多商品、用户、字典等读多场景,但不天然保证一致性。缓存失效/写入失败、并发读回填、读副本延迟、事务提交边界都会影响结果。Redis故障后若直接放行全部请求到数据库,仍可能引发雪崩,必须有限流/降级。
删除与覆盖缓存各有适用场景。旁路模式常用提交后删除,减少并发覆盖的复杂性;带版本号、顺序控制等的缓存更新同样可以有合理设计,不应宣称所有业务禁止更新value。
7.5.2 Read-Through、Write-Through与Write-Behind
| 模式 | 读写职责 | 一致性与故障边界 | 主要成本 |
|---|---|---|---|
| Cache-Aside | 应用查库/回填并失效缓存 | 通常以最终一致为目标,需补失败与竞争处理 | 应用维护两层逻辑 |
| Read-Through | 缓存组件在未命中时调用加载器查询数据库 | 只是封装读路径,不自动提供强一致 | 加载器、失效和组件运维 |
| Write-Through | 组件在写路径同步处理后端存储 | 同步返回不等于两个系统原子提交,需处理部分成功 | 写延迟及协调 |
| Write-Behind | 先接受缓存/队列写入,再异步更新数据库 | 后端有延迟;未可靠记录、故障恢复不当可能丢数 | 队列、重试、顺序、积压及对账 |
Redis原生不会因为GET/SET自动查询或写入MySQL,后三者需要应用层、框架或中间件实现;“Read-Through”是架构模式,也不应与前面的“缓存穿透故障”混淆。Read-Through与写入方式是不同维度,能和相应写策略组合,不是三种互斥、统一天然强一致的Redis功能。
原“90%互联网业务”“95%最终一致”等没有调查依据,本教材不把这些比例写成统计结论。选择取决于数据能否丢失、容许陈旧时间、故障恢复和维护能力,不宜只按公司规模、是否微服务机械决定。
7.5.3 RuoYi-Vue中的缓存
RuoYi 的缓存管理可结合 Spring Cache 注解:
| 注解 | 一般语义 |
|---|---|
@Cacheable |
满足配置条件时先查询缓存,未命中再调用方法并存储结果 |
@CacheEvict |
按配置删除缓存,默认通常在方法成功返回后,也可配置调用前清理 |
@CachePut |
调用方法后按配置写入结果,不跳过方法执行 |
这些是Spring Cache能力,并不意味着任意RuoYi-Vue版本的所有业务查询都已使用这些注解,也不意味着只加注解就具备Redis介质、随机TTL和事务提交后一致性。项目可能通过RedisCache、字典/参数工具类或具体服务直接读写,需以实际源码、缓存管理器、代理调用及事务配置为准。
原希望实现的查询路径为“前端→缓存→未命中查MySQL→回填”;修改路径为“MySQL更新成功→失效缓存→后续读取回填”。若存在外层事务,方法返回并不一定已经提交,需在真正提交后安排相应失效动作。
运维重点:
- TTL及随机偏移、系统字典/菜单/权限等是否永久缓存,要核对实际实现和数据新鲜度要求,不把建议当成默认已启用;权限类变更尤其不能无限期返回旧结果。
- 若使用
volatile-lru,只会在符合条件的TTL键中淘汰;不会自动清理永久的冷字典,也不是专门“清理已过期键”的机制。 - 分页和参数校验减少无效/大范围请求;监控缓存错误和空值键增长,不能把所有页面不刷新都归因缓存。
- 仅有共享Redis层时,各应用节点要对同一目标缓存执行正确失效;不是“每台只删本地Redis”。若另加Caffeine,还必须处理本地缓存的失效传播。
- 管理端清理缓存可用于明确的重建流程,应限制范围和权限;全量一键清理可能制造集中回源,不能作为所有数据不一致的常规兜底。
7.6 缓存与数据库一致性
7.6.1 四种更新顺序
| 顺序 | 典型竞争/失败风险 |
|---|---|
| 先提交DB,再删除缓存 | 删除失败留下旧值;更早开始的读请求可能在删除后回填旧数据 |
| 先删缓存,再更新DB | 更新前的并发读可能查到旧库值并回填 |
| 先更新DB,再更新缓存 | 两次并发写可能乱序覆盖新缓存;写缓存也可能失败 |
| 先更新缓存,再更新DB | DB失败时缓存保留新值,或并发观察到尚未提交数据 |
旁路缓存常用第一种,但删除也不能保证“无覆盖竞争”。尤其从有延迟的MySQL副本回填时,即使主库已经提交、缓存已删除,副本还可能返回旧值。是否持续脏数据还与TTL、重试及后续更新有关,不能一律断言永远一致或永久不一致。
7.6.2 延迟双删、MQ与Binlog订阅
延迟双删。 原流程为提交DB→第一次删除→等待约300~1,000ms→第二次删除,期望清理删除失败或并发回填的旧值。延时应由真实查询/回填/副本延迟分布决定,固定睡眠不能覆盖所有慢请求;应用进程退出、第二次仍失败也会留下问题。它减少某些窗口,不保证可靠交付和严格一致。
MQ异步删除。 数据库提交后发送失效消息,由消费者删除对应缓存。需要持久化、确认、重试、死信、幂等及顺序/版本处理;DB提交成功而消息尚未发送就崩溃的窗口仍需可靠发布设计,不能说有MQ就绝不丢删除动作。原DEL可按对象特征替换为UNLINK,不能因此忽略处理失败。
Canal订阅Binlog。 将MySQL变更日志转换成下游事件,消费者映射到缓存键并失效,可降低业务手工埋点负担。仍需匹配MySQL版本、Binlog格式、权限、位点/保留期、故障恢复、延迟、重复/乱序和键映射;并非只部署Canal就能“100%感知且永不漏删”。变更日志可靠可读也不代表消费者已经处理成功。
原按小后台→双删、中等业务→MQ、大型微服务→Canal的选型可作讨论起点;实际应选择满足可靠性目标且维护成本可承担的方案,而非把Canal定为所有大型系统最优。
7.6.3 最终一致与强一致的边界
最终一致指在相关写入停止、消息/重试等最终成功并满足其假设后,副本/缓存最终收敛;不自动意味着“几秒内必定一致”。应明确容许陈旧时间、失败重试上限、延迟告警和恢复动作。商品展示、推荐、某些用户资料等可能接受短期陈旧,具体业务也未必容许统一1秒窗口。
强一致的含义需要由读写语义明确,例如完成写入后相关读取不得观察到更旧结果。同步分别写Redis和MySQL,或使用Write-Through命名,并不能使两个系统自动获得原子提交与强一致。 分布式事务也不是任意协议/隔离级别下都自动实现所有强一致语义。
账户、支付、库存扣减等核心状态应由明确的权威存储、事务/并发控制和一致性协议保障,不能以“同步双写”代替正确性设计。缓存可以辅助展示或性能优化,但不能把允许陈旧的缓存读当成资金或库存决策的唯一权威。
7.7 MySQL主从与Redis旁路缓存联动实验
7.7.1 环境与MySQL复制准备
| 节点 | 角色 |
|---|---|
10.0.0.13 |
MySQL主库;本章独立Redis实例 |
10.0.0.16 |
MySQL副本;原实验将业务读请求指向这里 |
本节要求两台机器已安装兼容版本的 MySQL,副本完成初始数据导入,再根据实际复制坐标接入。不要在已有业务库上重复初始化。
在.13准备Binlog目录:
mkdir -p /data/mysql/logs
chown mysql:mysql /data/mysql/logs
原chown -R /data/mysql范围更大,这里只改本实验新建的日志目录;父目录也必须满足实际目录穿越权限。AppArmor额外授权应位于实际mysqld profile有效规则范围内,例如:
/data/mysql/logs/ r,
/data/mysql/logs/** rw,
原sed -i '$i\...'是在最后一行之前插入,不是“美元代表最后一行所以自动找到profile结束大括号”。应人工核对profile及发行版支持的local include位置后加入规则,避免插到注释/错误作用域。加载和系统访问权限是两层检查:
apparmor_parser -r /etc/apparmor.d/usr.sbin.mysqld
在MySQL实际加载的/etc/mysql/mysql.conf.d/mysqld.cnf的[mysqld]组中设置:
[mysqld]
server_id=13
log_bin=/data/mysql/logs/binlog
不要把配置直接追加到未知分组,也不重复写入已有同名设置。
systemctl restart mysql.service
mysql -uroot -p
原复制账号使用repluser@'10.0.0.%'。这里收窄为本实验唯一副本的实际地址,源地址有NAT等情况时按真实连接来源调整:
CREATE USER 'repluser'@'10.0.0.16' IDENTIFIED BY 'REPLACE_WITH_DB_PASSWORD';
GRANT REPLICATION SLAVE ON *.* TO 'repluser'@'10.0.0.16';
正常CREATE USER/GRANT后无需额外FLUSH PRIVILEGES。REPLICATION SLAVE是这里的权限关键字,不因为复制命令改名就随意替换其拼写;MySQL8.4使用默认认证插件时还需按数据库教材配置安全的连接认证/公钥或TLS方式。
原备份命令保留必要选项,并显式显示错误:
mysqldump -uroot -p -A -F --source-data=1 --single-transaction > all.sql
-A导出全部数据库,-F刷新日志,--source-data=1把复制坐标及相应CHANGE语句写入导出;--single-transaction主要提供支持事务表的一致读取,不保证非事务表和并发DDL同样一致。导出成功、恢复到副本、配置唯一server_id及复制参数后才能加入复制,不是仅有一个all.sql就已完成主从。
在副本先恢复与主库坐标匹配的一致性备份,再设置独立 server_id。下面连接参数需替换为实际密码和备份中的 binlog 文件/位置,并正确配置 MySQL TLS 证书:
CHANGE REPLICATION SOURCE TO
SOURCE_HOST='10.0.0.13',
SOURCE_USER='repluser',
SOURCE_PASSWORD='REPLACE_WITH_DB_PASSWORD',
SOURCE_LOG_FILE='REPLACE_WITH_BINLOG_FILE',
SOURCE_LOG_POS=12345,
SOURCE_SSL=1;
START REPLICA;
SHOW REPLICA STATUS\G
12345 仅为位置占位示例,必须使用导出记录中的真实值;GTID 部署使用对应自动定位流程,不能混用文件位置方案。检查证书校验、复制错误、位点与业务样本:
mysql -uroot -p -e 'SHOW REPLICA STATUS\G'
原关键结果:
Replica_IO_Running: Yes
Replica_SQL_Running: Yes
两线程Yes只是基本运行状态,不等于零延迟或每个事务都已应用,仍需看错误、位点/GTID及测试数据。若仅想筛选这两行,原命令为:
mysql -uroot -p -e 'SHOW REPLICA STATUS\G' | grep '_Running:'
7.7.2 建表、插入和更新
在.13独立ruoyi测试库执行。原DROP TABLE会删除已有同名表;本节仅用于新建/可销毁的教学数据,不能当成已有RuoYi业务的升级脚本。
CREATE DATABASE IF NOT EXISTS ruoyi;
USE ruoyi;
DROP TABLE IF EXISTS sys_user_info;
CREATE TABLE sys_user_info (
id BIGINT PRIMARY KEY COMMENT '用户ID',
username VARCHAR(50),
phone VARCHAR(20),
email VARCHAR(100),
create_time DATETIME
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
INSERT INTO sys_user_info(id,username,phone,email,create_time)
VALUES(123,'zhangsan','13800138000','zhangsan@test.com',NOW());
主库和复制已追上的副本分别查询:
mysql -uroot -p -e 'SELECT * FROM ruoyi.sys_user_info;'
原两侧相同的记录:
| id | username | phone | create_time | |
|---|---|---|---|---|
| 123 | zhangsan | 13800138000 | zhangsan@test.com | 2026-08-25 11:00:17 |
随后主库执行一次业务更新:
UPDATE ruoyi.sys_user_info
SET phone='13900139000',email='zhangsan_new@test.com'
WHERE id=123;
副本查询原得到:
| id | username | phone | create_time | |
|---|---|---|---|---|
| 123 | zhangsan | 13900139000 | zhangsan_new@test.com | 2026-08-25 11:00:17 |
时间是原样本,不是本次实测;create_time未被UPDATE修改。一般异步复制存在延迟,不能靠固定“等几秒”保证所有环境已经追平。
7.7.3 Redis实例准备
已有本章目标独立实例时不重新安装。原入口如下,具体服务/配置对应关系以之前的部署结果为准:
/bin/bash deploy_redis.sh
systemctl cat redis.service
原脚本片段希望设置监听、日志、数据目录、RDB和密码。hostname -I可能返回多个地址,不能未经选择全部拼入bind。原对精确默认字符串的sed可能完全不匹配已有配置,grep '^requirepass'存在时又不改旧密码,最终实际配置可能和示例认证不一致。
下面保留同样的独立实验配置动作,改为明确选择.13地址、备份并统一写入这些指令。只适用于已核实redis.service确实加载该文件的本章实验实例,不改其他端口/Cluster实例。配置文件中的include顺序及ACL还需核对,避免后续文件覆盖本段。
MAIN_CONF=/etc/redis/redis-6379.conf
REDIS_BIND_IP=10.0.0.13
REDIS_PASS='Redis@2026'
[[ -f $MAIN_CONF ]] || exit 1
[[ ! -e ${MAIN_CONF}.before-chapter7 ]] || exit 1
cp -a -- "$MAIN_CONF" "${MAIN_CONF}.before-chapter7"
sed -i -E '/^[[:space:]]*(bind|logfile|dir|save|requirepass)([[:space:]]|$)/d' "$MAIN_CONF"
cat >> "$MAIN_CONF" <<REDIS
bind 127.0.0.1 $REDIS_BIND_IP -::1
logfile /var/log/redis/redis-6379.log
dir /var/lib/redis
save 900 1
save 300 10
save 60 10000
requirepass $REDIS_PASS
REDIS
unset REDIS_PASS
systemctl restart redis.service
read -r -s -p 'Redis实验密码:' REDISCLI_AUTH
printf '\n'
export REDISCLI_AUTH
日志和数据目录必须已存在且服务用户可访问;不要从上述片段推断服务一定以root运行或所有目录都需全量chown。服务名称、配置入口、监听和状态要按实际环境核对,重启命令返回成功也不替代验证。requirepass保护默认认证路径,不能据此忽略其他ACL用户。
原将export REDISCLI_AUTH="Redis@2026"写到/etc/profile.d/redis.sh会把同一凭据暴露给加载该环境的用户,且与服务认证是否正确没有必然关系。这里仅保留当前终端交互认证,不向全局profile写入密码。按实际来源限制网络访问;不为便于实验开放到所有地址。
7.7.4 缓存未命中与回填
先移除本次实验键,确认未命中:
redis-cli -h 10.0.0.13 UNLINK user:123
redis-cli -h 10.0.0.13 EXISTS user:123
后者应在成功且没有并发写回时返回0。查询权威数据:
mysql -uroot -p -e 'SELECT * FROM ruoyi.sys_user_info WHERE id=123;'
此时按前一步更新结果,手机号应为13900139000,邮箱为zhangsan_new@test.com。模拟应用将查询结果序列化回填,而不是Redis主动读取MySQL:
redis-cli -h 10.0.0.13 SET user:123 '{"id":123,"username":"zhangsan","phone":"13900139000","email":"zhangsan_new@test.com"}' EX 300
redis-cli --raw -h 10.0.0.13 GET user:123
{"id":123,"username":"zhangsan","phone":"13900139000","email":"zhangsan_new@test.com"}
原稿SET/GET写成13800139000,与上文数据库13900139000不同,却宣称完全相同;这里已修正。JSON只缓存所选字段,未含create_time,比较应针对这些字段而不是声称序列化完整行完全一致。
TTL300秒是陈旧值的可能兜底上限之一,不是发现不一致后可以忽略的理由;持续从滞后副本回填可能再次写入旧值。真实程序要区分缓存未命中、Redis错误和数据库空结果。
7.7.5 更新后失效与再次读取
主库.13再更新:
UPDATE ruoyi.sys_user_info
SET phone='13900138000',email='zhangsan@test.com'
WHERE id=123;
原.16查询命令:
mysql -uroot -p -e 'USE ruoyi; SELECT id,username,phone,email FROM sys_user_info WHERE id=123;'
原副本已追上的结果:
| id | username | phone | |
|---|---|---|---|
| 123 | zhangsan | 13900138000 | zhangsan@test.com |
数据库事务提交后,删除旧缓存:
redis-cli -h 10.0.0.13 UNLINK user:123
下一次读取本应由应用查库并回填。为演示数据流,原文手动模拟这一步:
redis-cli -h 10.0.0.13 SET user:123 '{"id":123,"username":"zhangsan","phone":"13900138000","email":"zhangsan@test.com"}' EX 300
redis-cli --raw -h 10.0.0.13 GET user:123
{"id":123,"username":"zhangsan","phone":"13900138000","email":"zhangsan@test.com"}
这证明的是手工序列化数据与本次查询结果的对应关系,不是已实现自动同步、真实应用缓存拦截器或强一致协议。业务从副本读时必须结合复制进度/读写一致性要求控制回填,不能仅以“等几秒”代替设计。真实系统还需处理提交后删除失败、并发旧值回填及缓存键映射。
8. NFS 分布式共享存储配套落地
8.1 存储基础
8.1.1 DAS、SAN 与 NAS
| 类型 | 接入方式与主机看到的资源 | 典型用途 |
|---|---|---|
| DAS,Direct-Attached Storage | 本地总线、SAS/SCSI 等直接连接,主机通常看到块设备 | 本地磁盘、直连阵列 |
| SAN,Storage Area Network | 专用或隔离的存储网络,通常向主机提供块设备/LUN | 数据库存储、集中块存储 |
| NAS,Network-Attached Storage | 通过 NFS、SMB 等提供文件和目录 | 多主机文件共享、家目录、上传文件 |
DAS 不必都接在主板上,部分设备支持多主机连接,能否共享还取决于控制器、访问协调和文件系统。普通单机文件系统不能因为两个主机都看到同一磁盘就安全并发挂载。
SAN 常见 FC SAN 和 IP SAN。FC 用 FC 交换机、HBA、WWN 等标识和传输;iSCSI 在 IP 网络上传输 SCSI。设备的管理接口可以有 IP,不能据此判断其数据平面是否为 FC。SAN 的距离、带宽、兼容性、成本和扩展能力取决于实际方案,并非用了光纤就一定快。
8.1.2 块、文件、对象与分布式存储
| 方式 | 接口与使用方式 | 需要澄清的边界 |
|---|---|---|
| 块存储 | 磁盘、RAID、云盘、SAN LUN;可建文件系统,也可供数据库直接使用 | 可以直接在整块设备建文件系统,不一定先分区;也不一定是本地存储 |
| 文件存储 | 路径、文件、目录和 open/read/write/seek/close 等接口 | 网络文件系统的语义、锁、一致性与本地 POSIX 实现存在差异 |
| 对象存储 | 对象键、元数据,常用 HTTP REST API/SDK,如 S3、OSS | 通常按对象上传/替换;范围读取、分段上传等并非“只能全读”,部分产品还支持追加 |
| 分布式存储 | 多节点协作组成存储服务 | 可提供块、文件或对象接口,是否冗余、容灾及一致性取决于系统设计 |
文件共享便于多客户端访问,但不能脱离设备、网络和工作负载断言其一定比块存储慢。云存储也不是单一接口类型。
8.2 NFS 与 RPC
NFS(Network File System)由 Sun 发起,客户端把远程导出挂载为本地目录,应用通过文件接口访问。常用于共享家目录、软件/媒体资源、上传文件和集中备份目标;集中备份还需要独立副本与恢复验证。
RPC 把操作和参数编码为请求,由服务器执行并返回结果。NFS 本身也使用 RPC;原文“查到端口后数据传输便不再经过 RPC”不准确,后续是不再每次经 rpcbind 查询端口。
- NFSv3 常通过 rpcbind 的 TCP/UDP 111 查找 mountd 等服务,辅助服务端口可动态分配或固定配置。
- NFSv4 把挂载、锁等协议能力整合,常规 v4-only 数据访问通常使用 TCP 2049,不要求客户端先访问 rpcbind。v4.0 回调与具体部署可能另有网络需求,不能把所有版本/功能都概括为永远只有一个连接。
- 传输块大小由版本、客户端/服务端协商及 rsize/wsize 等决定,并非固定 8 KiB。
- 默认 AUTH_SYS(sec=sys)传递 UID/GID 等身份信息,通常结合导出来源限制。root_squash 是权限映射,不是可靠的用户身份认证;可使用 RPCSEC_GSS/Kerberos 增强认证和保护。
单服务器可能受 CPU、磁盘、带宽、元数据操作和延迟限制;广域网尤其要评估延迟。hard 挂载在短暂中断后通常重试,可能表现为应用阻塞,不是每次必须手动重挂。单点、底层磁盘失效、锁恢复和备份都需独立设计。数据库是否支持特定 NFS 存储应按数据库及存储厂商要求判断。
8.2.1 软件、端口与组件
# Rocky,客户端与服务端工具主要在 nfs-utils
dnf install rpcbind nfs-utils
rpm -q rpcbind nfs-utils
# Ubuntu 服务端
apt install nfs-kernel-server
dpkg -l rpcbind
# Ubuntu 客户端
apt install nfs-common
原 Ubuntu rpcbind 为 1.2.6-2build1/amd64。安装依赖和实际版本以发行版为准。
ss -tunlp | grep -E 'rpc|:2049'
systemctl status nfs-server
| 组件 | 用途 |
|---|---|
| rpcbind | RPC 程序号到端口的映射,通常监听 111 |
| rpc.mountd | NFSv3 挂载协议及 Linux 服务端导出访问辅助处理 |
| rpc.nfsd / 内核 nfsd | 配置并提供实际 NFS 文件服务,不是普通“用户登录服务” |
| rpc.statd | NFSv2/v3 的 NSM 状态和锁恢复辅助,不修复文件内容 |
原观察中 mountd 的 UDP 端口从 58332 变为 36333,statd 出现 38632 和回环 603;这是该现场的端口分配,动态端口不是加密或认证措施。
systemctl restart nfs-server
ss -tunlp | grep -E 'rpc|:2049'
tree /var/lib/nfs/
Ubuntu 常用服务名 nfs-kernel-server,nfs-server 可能是关联单元,先核实。本地状态目录可能包含 etab、export-lock、nfsdcld/main.sqlite、rmtab、sm、sm.bak、state、v4recovery;这不是普通日志目录,不手工删除恢复状态。
8.2.2 exportfs 与 showmount
exportfs [-adfhioruvs] [host:/path]
showmount [options] [host]
| 命令/选项 | 含义 |
|---|---|
| exportfs -a | 对全部导出项操作,配合其他选项解释 |
| exportfs -r | 根据配置重新同步导出表 |
| exportfs -v / -s | 查看导出和选项 / 适合配置形式的显示 |
| exportfs -u | 撤销导出,不是卸载客户端文件系统 |
| exportfs -au | 撤销全部导出,会影响已有客户端 |
| showmount -e SERVER | 查询服务端 mount 协议公开的导出列表 |
| showmount -a SERVER | 查看服务端记录的挂载客户端,可能陈旧或不完整 |
exportfs -r
exportfs -v
showmount -e 10.0.0.13
showmount -a 10.0.0.13
v4-only 服务可能无法通过 showmount 查询;showmount 失败不等于 v4 挂载失败。
8.3 导出规则与权限
/etc/exports 每行由目录和一个或多个 客户端(选项) 组成。客户端和自己的括号间不能误加空格;不同客户端用空白分隔,选项在括号内用逗号分隔。
/path/to/dir 10.0.0.1(rw,sync,root_squash) 10.0.0.2(ro,sync,root_squash)
/another/dir 10.0.0.0/24(rw,sync,root_squash)
可写具体 IP、主机名、受支持的主机名通配模式、子网或 @netgroup。* 是宽泛访问模式;anonymous 不是一个通用的“所有客户端”关键字。掩码示例应为 255.255.255.0,不是 225.225.225.0。安全风格用 sec=krb5/krb5i/krb5p 选项表达,不能当作客户端地址。
| 选项 | 正确含义 |
|---|---|
| ro / rw | 导出只读 / 允许写入,仍需满足服务端文件权限 |
| root_squash | 将客户端 root 的相应身份映射为匿名身份 |
| no_root_squash | 不对客户端 root 做该映射,扩大权限,非普通应用所必需 |
| all_squash / no_all_squash | 所有身份都匿名映射 / 不进行这种全体映射;后者不取消 root_squash |
| anonuid / anongid | 指定匿名映射的 UID/GID,常见默认值 65534,名称依发行版 |
| sync / async | 服务端按协议要求持久化后确认 / 允许提前确认,async 增加故障丢失风险 |
| subtree_check / no_subtree_check | 启用 / 关闭导出子树位置检查,不是取消所有父目录权限检查 |
| wdelay / no_wdelay | 延迟合并相关写入 / 取消该延迟;async 下意义不同 |
| secure / insecure | 对相应请求的客户端源端口采用保留端口限制 / 放宽限制;不表示加密 / 未授权访问 |
| hide / nohide | 与另行挂载的子文件系统可见性相关;不是隐藏普通子目录,v4 有不同规则 |
| fsid=0 | 指定 NFSv4 导出命名空间根 |
常见默认包含 ro、sync、root_squash、no_all_squash、no_subtree_check,实际查看 exportfs 输出,不能忽略版本差异。
id 65534
原 Ubuntu 输出 uid=65534(nobody) gid=65534(nogroup)。RHEL 系列名称也随版本变化,授权前查真实数字 ID。
8.3.1 只读实验
服务端 .13:
mkdir -p /data/dira /data/dirb
cp /etc/fstab /data/dira/
隔离实验原规则 /data/dira * 允许任意来源尝试只读访问;正式环境收紧到实际客户端。这里只发布本实验客户端:
/data/dira 10.0.0.16(ro,sync,root_squash,no_subtree_check)
exportfs -r
exportfs -v
showmount -e 10.0.0.13
客户端 .16:
mkdir -pv /data/dir1 /data/dir2
mount -t nfs 10.0.0.13:/data/dira /data/dir1
findmnt /data/dir1
df -h /data/dir1
ls -l /data/dir1
cat /data/dir1/fstab
touch /data/dir1/test
echo '123' >> /data/dir1/fstab
原挂载协商 v4.2、ro、hard、TCP、rsize/wsize=262144,fstab 可读;touch 和追加均报 Read-only file system。原 df 混入 .208 地址,属于前后现场不一致;本实验服务端统一 .13,容量 97G/已用7.4G 等不是固定预期。
8.3.2 rw 与 root_squash
服务端将 .16 改为 rw,.12 保持 ro:
/data/dira 10.0.0.16(rw,sync,root_squash,no_subtree_check) 10.0.0.12(ro,sync,root_squash,no_subtree_check)
exportfs -r
exportfs -v
客户端若仍是只读挂载,先确认无使用者后重新挂载为 rw;只改服务端不保证本地挂载标志同步改变:
umount /data/dir1
mount -t nfs -o rw 10.0.0.13:/data/dira /data/dir1
touch /data/dir1/test-16
原此时出现 Permission denied:服务端目录 root:root、0755,客户端 root 被映射为匿名用户,没有目录写权限。这与前一阶段只读文件系统是不同问题。
原临时 chmod o+w /data/dira 后写入成功,新文件 nobody:nogroup、0644;该演示扩大了所有其他用户权限。下面用 ACL 代替,服务端操作:
apt install acl
chmod o-w /data/dira
setfacl -d -m u:nobody:rwx /data/dira
setfacl -m u:nobody:rwx /data/dira
getfacl /data/dira
默认 ACL 作用于以后新建子项,访问 ACL 作用于当前目录,两者无强制先后依赖;ACL mask、文件创建 mode 和上级路径遍历权限也影响有效权限。授权匿名用户会授权所有映射到该身份的访问者,不能实现真正的多业务隔离;正式应用优先固定业务 UID/GID 并限制客户端。
客户端再验证:
touch /data/dir1/test-16
ls -ln /data/dir1
8.4 NFSv4、自动挂载与安全
8.4.1 v3 与 v4 比较
| 项目 | NFSv3 | NFSv4 |
|---|---|---|
| 状态 | 核心文件协议无状态,辅助锁服务有状态 | 集成 open/锁/租约状态;会话为 v4.1 等版本能力 |
| 传输 | 可用 UDP/TCP,依实现 | 常规 Linux 部署以 TCP 为主,另有 RDMA 等传输 |
| 挂载与端口 | 常需 mountd、rpcbind 和锁辅助服务 | 集成挂载/锁,通常以 2049 为主要数据入口 |
| ACL | 可能有额外 ACL 协议/实现扩展 | 协议定义 NFSv4 ACL,Linux 服务端与底层文件系统支持仍需核实 |
| 恢复 | 文件请求与辅助锁恢复分别处理 | 租约、宽限期和状态恢复,不保证应用自动处理所有失败 |
选择 v4 常可简化防火墙和身份/锁管理,但“内置锁就不会写乱文件”“断线必定保留所有上下文”都不成立;应用必须正确使用锁和并发协议。已有 v3 系统按兼容性、功能与维护要求决定迁移。
8.4.2 显式伪根与 bind 实验
NFSv4 使用统一导出命名空间,但 Linux 可以构造伪文件系统;不是所有导出都必须手工 bind 到一个目录。本例显式建立伪根以获得简洁客户端路径,bind 提供同一目录树的另一挂载入口,不复制文件。
服务端 .13:
mkdir -p /nfs4share/dira /nfs4share/dirb
把下列两行补入 fstab,保留其他记录且不重复添加:
/data/dira /nfs4share/dira none bind 0 0
/data/dirb /nfs4share/dirb none bind 0 0
mount /nfs4share/dira
mount /nfs4share/dirb
findmnt /nfs4share/dira
findmnt /nfs4share/dirb
tree /nfs4share
原树中 dira/fstab、dirb;bind 仍使用同一底层文件系统。明确导出子挂载,而不是只发布根目录后假定自动进入一切子文件系统:
/nfs4share 10.0.0.16(ro,sync,root_squash,no_subtree_check,fsid=0)
/nfs4share/dira 10.0.0.16(rw,sync,root_squash,no_subtree_check)
/nfs4share/dirb 10.0.0.16(rw,sync,root_squash,no_subtree_check)
保留已有无关导出;本实验替换前节同目录的旧规则,避免继续通过其他路径宽泛发布。子目录本地权限沿用前节或明确授予业务用户,不使用 no_root_squash 代替权限设计。
如需 v4-only,在 /etc/nfs.conf 核对发行版支持后配置:
[nfsd]
vers2=n
vers3=n
vers4=y
vers4.0=y
vers4.1=y
vers4.2=y
systemctl restart nfs-kernel-server
systemctl enable nfs-kernel-server
nfsconf --dump
cat /proc/fs/nfsd/versions
exportfs -arv
exportfs -s
nfsconf 输出是配置解析,不独自证明内核实际启用版本;不支持的版本按内核调整。showmount 在 v4-only 环境可能报 RPC: Program not registered,它依赖 mount 协议,单凭此结果不能确定是 rpcbind 未启动、mountd 未注册还是网络阻断。
客户端:
apt install nfs-common netcat-openbsd
nc -zv 10.0.0.13 2049
mkdir -p /mnt/client_dira /mnt/client_dirb
mount -t nfs -o vers=4.2 10.0.0.13:/dira /mnt/client_dira
mount -t nfs -o vers=4.2 10.0.0.13:/dirb /mnt/client_dirb
findmnt /mnt/client_dira
findmnt /mnt/client_dirb
原第二条命令误写 .10,统一 .13。原协商 v4.2、rw、hard、TCP、rsize/wsize=524288。nc 成功只说明端口可达,不证明授权、文件权限、锁和实际读写均通过。
永久挂载示例:
10.0.0.13:/dira /mnt/client_dira nfs vers=4.2,hard,_netdev 0 0
_netdev 标记网络文件系统并影响启动依赖,不保证远端服务可用;关键业务需要服务挂载依赖。
8.4.3 autofs
autofs 按路径访问触发挂载,在满足空闲和可卸载条件时自动卸载。适合共享目录多、访问稀疏或避免启动时集中挂载的场景,不是保证 60 秒到点卸载。
apt install autofs
/etc/auto.master 增加:
/mnt/nfs /etc/auto.nfs --timeout=60
/etc/auto.nfs:
shared -fstype=nfs,rw,hard 192.168.1.100:/shared
systemctl enable --now autofs
ls /mnt/nfs/shared
findmnt /mnt/nfs/shared
修改现有配置按发行版要求 reload/restart;不再为同一挂载点同时设置常驻 fstab。持续使用的挂载不会因为高频访问而不断卸载/重挂,是否采用 autofs 应按启动行为、空闲周期和服务依赖决定。
8.4.4 安全基线
- 指定客户端 IP/网段,多个来源写成独立
客户端(选项)项,不能把网段用逗号拼成一个客户端。 - 保留 root_squash;业务用统一 UID/GID。all_squash 可用于有意把所有访问者归入同一受限身份的共享,不能兼顾每用户隔离。
- 不用 chmod 777/o+w 或关闭认证处理权限错误。必要 ACL 仍需检查 mask 与路径权限。
- sec=krb5 提供认证,krb5i 增加完整性保护,krb5p 才提供隐私加密;需要 KDC、服务主体、keytab、时间和名称解析等完整配置,并非一行挂载即可获得全部能力。
- 安全组/防火墙和备份独立维护;日志依发行版查看 journal、syslog 或 messages,挂载动作不保证都记录在同一文件。
Ubuntu UFW 的 v4.1/v4.2 TCP 示例,以下是文档命令;先核对现有管理入口、实际 SSH 端口、IPv6 和规则顺序,再变更:
ufw status numbered
ufw allow 22/tcp
ufw allow from 10.0.0.16 to any port 2049 proto tcp
ufw deny 2049/tcp
ufw default deny incoming
ufw default allow outgoing
ufw enable
ufw reload
ufw status numbered
UFW 与 firewalld 是不同管理工具,规则按实际启用的工具维护。允许规则要处在可生效的位置,旧的宽泛 ALLOW 需核对;允许22不能保证使用其他端口的 SSH 不断开。原规则中 6379 对所有 IPv4/IPv6 开放也不应照搬。
8.5 综合实验:RuoYi-Vue 三节点业务架构
8.5.1 项目和拓扑
RuoYi-Vue 是前后端分离的后台开发平台,包含权限、用户、角色、菜单、字典、任务与代码生成等功能。不同分支/版本的技术栈不同,不把 Vue2、Vue3、TypeScript 及不同 Spring Boot 版本的配置拼成同一套工程。
| 节点 | 作用 |
|---|---|
| 10.0.0.13 | 源码构建、Nginx、Java8080、NFS 客户端 |
| 10.0.0.16 | Redis6379、NFS 服务端,保存前端和上传文件 |
| 10.0.0.19 | MySQL3306,数据库 ry_vue |
它们是单点依赖的综合实验,未提供数据库、Redis、NFS 或应用入口的完整容灾。前文其他实验的角色不自动沿用;尤其已有 Redis 复制环境中 .16 可能是副本,若依需要连接本轮可写主节点,不能直接连只读副本。
后端使用 Spring Security、MyBatis、Druid、Redis、Quartz;JWT 登录也依赖服务端 Redis 状态,不能简单称为完全无状态。MyBatis-Plus、异构数据库适配、分布式事务等须看具体扩展/分支,不能认为该标签全部默认提供。Vue2 前端主要为 Element UI、Vue CLI、Vuex,Vue3 分支则有不同组件和构建链。
同类多节点共享方案可对照 LVS 的 VIP 与健康检查方案;该教材地址为 .19/.22/.25,本章仍按上表 .13/.16/.19 实施,不混用地址。
8.5.2 Java、Maven、Node 与 Nginx
在 .13:
apt update
apt install -y openjdk-17-jdk maven git nginx nfs-common mysql-client
java -version
mvn -v
原 Java17.0.19、Maven3.8.7、Linux6.8.0-31、amd64 是现场输出。amd64 Ubuntu 的 JAVA_HOME 示例:
export JAVA_HOME=/usr/lib/jvm/java-17-openjdk-amd64
export PATH="$JAVA_HOME/bin:$PATH"
写入 ~/.bashrc 只影响读取该文件的 Shell,不叫“全局配置”;systemd 后面使用绝对 Java 路径。其他架构核对实际 JDK 目录。
原 Maven 镜像片段可并入既有 ~/.m2/settings.xml,保留已有私服和认证配置:
<?xml version="1.0" encoding="UTF-8"?>
<settings>
<mirrors>
<mirror>
<id>aliyun</id>
<mirrorOf>central</mirrorOf>
<url>https://maven.aliyun.com/repository/public</url>
</mirror>
</mirrors>
</settings>
原 Node20 安装入口先下载并审阅脚本,然后在专用实验构建节点使用,而非把网络脚本未经查看直接送入 root Shell:
curl -fsSL https://deb.nodesource.com/setup_20.x -o /tmp/ruoyi-nodesource-20.sh
less /tmp/ruoyi-nodesource-20.sh
# 核对来源、内容和所需版本后,历史实验命令
bash /tmp/ruoyi-nodesource-20.sh
apt install -y nodejs
node -v
npm -v
npm config set registry https://registry.npmmirror.com
npm config get registry
原 Node v20.20.2、npm10.8.2;这些命令不证明旧前端与任意 Node20 小版本兼容。生产依赖审核、锁文件与 Node 支持周期单独核对。
8.5.3 MySQL 与业务账号
apt install -y mysql-server
systemctl enable --now mysql
ss -ltnp | grep -E ':3306|:33060'
mysql_secure_installation
sudo mysql
原安全向导:启用密码校验、选择 MEDIUM、移除匿名账号、禁止远程 root、移除 test 并刷新权限;不同包的初始账号和向导可能不同,不能保证新版本都自带匿名账号和 test 库。auth_socket 允许本地受信任系统身份管理,不必强改 root 为远程密码账号。
.19 的 mysqld 配置保留其他参数,只调整需要的监听:
[mysqld]
bind-address=127.0.0.1,10.0.0.19
mysqlx-bind-address=127.0.0.1
多地址需所用 MySQL 版本支持;不支持时监听业务地址并通过本地 Unix Socket 管理。X Protocol 本实验不用对外开放。
systemctl restart mysql
ss -ltnp | grep -E ':3306|:33060'
新专用实验库,由 .19 本地管理员创建:
CREATE DATABASE ry_vue CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
CREATE USER 'ruoyi'@'10.0.0.13' IDENTIFIED BY 'Ruoyi@123';
GRANT SELECT,INSERT,UPDATE,DELETE ON ry_vue.* TO 'ruoyi'@'10.0.0.13';
8.5.4 Redis 依赖
复用前文源码安装实例时,先核对真实服务名、配置、User/Group、可写目录和当前主从角色:
systemctl cat redis
systemctl status redis
ss -ltnp | grep ':6379'
redis-cli -h 10.0.0.16 --askpass INFO replication
Type=notify/supervised systemd 必须匹配编译和服务能力;不能既启动自建 redis.service,又让发行版 redis-server 在同一地址端口启动。
新安装路径在 .16:
apt install -y redis-server
编辑 /etc/redis/redis.conf 的对应项,避免用不限定上下文的 sed 反复追加:
bind 127.0.0.1 10.0.0.16
protected-mode yes
requirepass "Redis@2026"
systemctl enable --now redis-server
systemctl restart redis-server
redis-cli -h 10.0.0.16 --askpass PING
redis-cli -h 10.0.0.16 --askpass INFO replication
预期 PONG,并确认是供应用写入的 master。端口仅允许 .13 等必要来源,Redis 密码不等于传输加密;跨不可信网络使用 TLS 等保护。旧例只 bind 私网地址时本机默认127.0.0.1连接被拒绝是监听配置所致,本例显式保留回环。若启用 ACL,用户名/权限要与应用配置对应。
8.5.5 NFS 权限、发布与挂载
.13 与 .16 建立同一数字 UID/GID 的 ruoyi 身份。本例2000必须先查未被其他账号使用,已有业务用户则统一实际 UID/GID,不重复 useradd:
getent passwd ruoyi
getent passwd 2000
getent group ruoyi
getent group 2000
# 仅上述名称和ID均未占用的新节点
groupadd --gid 2000 ruoyi
useradd --uid 2000 --gid ruoyi --create-home --home-dir /home/ruoyi \
--shell /usr/sbin/nologin ruoyi
.16 本地准备共享:
apt install -y nfs-kernel-server
mkdir -p /nfs/ruoyi_web /nfs/ruoyi_uploadPath
chown root:root /nfs/ruoyi_web
chmod 0755 /nfs/ruoyi_web
chown ruoyi:ruoyi /nfs/ruoyi_uploadPath
chmod 2750 /nfs/ruoyi_uploadPath
/etc/exports 增加本轮导出,不清空无关项:
/nfs/ruoyi_web 10.0.0.13(ro,sync,root_squash,no_subtree_check)
/nfs/ruoyi_uploadPath 10.0.0.13(rw,sync,root_squash,no_subtree_check)
exportfs -arv
systemctl enable --now nfs-kernel-server
exportfs -v
本节采用直接导出路径,Linux 的自动伪根与上一节显式 fsid=0 示例是两种布局;若延续上一节手工伪根,须把本轮目录加入对应命名空间并相应修改客户端路径,不能原封不动混用。原 showmount 中 10.0.0.10/24 与配置不一致,本例限制到 .13。
前端由受控发布身份通过管理通道在 .16 的导出目录本地发布,.13 Nginx 只读;上传由同 UID 的 Java 进程写入,不需要 chmod777 或 no_root_squash。
.13 首先检查既有挂载和本地文件,已有 dist 和历史上传要备份迁移,不运行原文 rm -rf /data/ruoyi/web。历史上传迁移可参照 LVS 教材6.5–6.7,地址换为本节拓扑,并在停写窗口核对源/目标。
mkdir -p /data/ruoyi/web /data/ruoyi/uploadPath
chmod 0755 /data/ruoyi /data/ruoyi/web /data/ruoyi/uploadPath
mount -t nfs -o ro,vers=4.2 10.0.0.16:/nfs/ruoyi_web /data/ruoyi/web
mount -t nfs -o rw,hard,vers=4.2 10.0.0.16:/nfs/ruoyi_uploadPath /data/ruoyi/uploadPath
findmnt /data/ruoyi/web
findmnt /data/ruoyi/uploadPath
fstab 两行分别为六列,不用换行打断:
10.0.0.16:/nfs/ruoyi_web /data/ruoyi/web nfs ro,vers=4.2,hard,_netdev 0 0
10.0.0.16:/nfs/ruoyi_uploadPath /data/ruoyi/uploadPath nfs rw,vers=4.2,hard,_netdev 0 0
验证应用身份读写,不以客户端 root 被 squash 后失败判断所有业务失败:
sudo -u ruoyi touch /data/ruoyi/uploadPath/.ruoyi-write-check
ls -ln /data/ruoyi/uploadPath/.ruoyi-write-check
sudo -u ruoyi rm /data/ruoyi/uploadPath/.ruoyi-write-check
8.5.6 固定源码与导入初始化 SQL
.13:
git clone --branch v3.9.2 --depth 1 https://gitee.com/y_project/RuoYi-Vue.git
cd RuoYi-Vue
git describe --tags --always
ls
ls sql
ls ruoyi-ui
标签可能处于 detached HEAD,构建不要求强行新建分支。原“后端先构建最新分支,缺前端再切标签”会混用版本;固定标签后核心 SQL 文件名也不能继续硬编码另一版本的 ry_20260417.sql。
在源码根目录选择唯一核心初始化脚本并发送到数据库管理员暂存目录:
shopt -s nullglob
schemas=(sql/ry_*.sql)
if (( ${#schemas[@]} != 1 )); then
echo '核心SQL候选不唯一,先人工核对所选标签' >&2
exit 1
fi
scp "${schemas[0]}" sql/quartz.sql root@10.0.0.19:/root/
以上是一次性实验的管理员传输示例,实际管理入口按既有访问方式处理。在 .19 核对刚传入的确切文件名,只对新实验库导入:
sudo mysql ry_vue < /root/已核对的核心脚本文件名.sql
sudo mysql ry_vue < /root/quartz.sql
Quartz 在标准配置中启用时必须有相应表,不能只说“平时不用任务所以省略表”而保留启用的调度器。
.13 以运行账号核对:
mysql -h10.0.0.19 -uruoyi -p -e 'SHOW DATABASES; SHOW TABLES FROM ry_vue;'
原包括 QRTZ_BLOB_TRIGGERS、QRTZ_CALENDARS 等 Quartz 表和 sys_user_role 等系统表。只见数据库名不能证明表已导入。
8.5.7 后端连接配置与构建
保留标签内原 application.yml/application-druid.yml,使用额外配置覆盖连接、端口和文件路径。已核对 v3.9.2 上游此处是 spring.data.redis 与 spring.datasource.druid.master;不能根据前端仍为 Vue2 就猜后端沿用旧版配置层次。
.13:
install -d -m 0755 /data/ruoyi/server
install -d -o root -g ruoyi -m 0750 /data/ruoyi/config
install -d -o ruoyi -g ruoyi -m 0750 /home/ruoyi/logs
/data/ruoyi/config/application-lab.yml:
server:
address: 127.0.0.1
port: 8080
ruoyi:
profile: /data/ruoyi/uploadPath
spring:
datasource:
druid:
master:
url: 'jdbc:mysql://10.0.0.19:3306/ry_vue?useUnicode=true&characterEncoding=utf8&serverTimezone=Asia/Shanghai'
username: ruoyi
password: 'Ruoyi@123'
data:
redis:
host: 10.0.0.16
port: 6379
database: 0
password: 'Redis@2026'
timeout: 10s
chown root:ruoyi /data/ruoyi/config/application-lab.yml
chmod 0640 /data/ruoyi/config/application-lab.yml
原数据源漏写 druid 层次,可能导致业务仍用包内默认连接;Redis 必须保留正确的 spring.data.redis 层次。原“开启 slave 需要 allowPublicKeyRetrieval=true”没有因果关系;该参数与认证密钥获取相关,不是读写分离开关。内网也可能需要 TLS,不能把 useSSL=false 当作通用排障方法;本例 JDBC 未提供完整证书验证配置,实际部署按证书和网络要求配置 sslMode 等参数。
源码根目录构建:
mvn clean package -DskipTests
ls -l ruoyi-admin/target/ruoyi-admin.jar
install -m 0644 ruoyi-admin/target/ruoyi-admin.jar /data/ruoyi/server/ruoyi-admin.jar
8.5.8 systemd 后端与挂载依赖
/etc/systemd/system/ruoyi-admin.service:
[Unit]
Description=RuoYi-Vue Backend Admin Service
Wants=network-online.target
After=network-online.target
RequiresMountsFor=/data/ruoyi/uploadPath
[Service]
Type=simple
User=ruoyi
Group=ruoyi
WorkingDirectory=/data/ruoyi/server
Environment=SPRING_CONFIG_ADDITIONAL_LOCATION=file:/data/ruoyi/config/application-lab.yml
ExecStart=/usr/lib/jvm/java-17-openjdk-amd64/bin/java -Xms256m -Xmx512m -jar /data/ruoyi/server/ruoyi-admin.jar
UMask=0027
SuccessExitStatus=143
Restart=on-failure
RestartSec=5
[Install]
WantedBy=multi-user.target
远程 .19 MySQL、.16 Redis 不会因 After=mysql.service/redis-server.service 自动就绪;本例依赖网络与上传挂载,仍需应用连接失败处理。标签内 logback 默认日志位置需由 ruoyi 可写,本例准备 /home/ruoyi/logs。日志配置变动时按实际源码调整。
systemctl daemon-reload
systemctl enable --now ruoyi-admin
systemctl status ruoyi-admin
journalctl -u ruoyi-admin -f
ss -ltnp | grep ':8080'
原日志显示“若依启动成功”,端口8080;本例绑定回环,预期监听地址与原 :::8080 不同。Ctrl+C 退出 journalctl 跟随,不是停止服务。
8.5.9 前端构建和发布
.13 同一标签源码目录:
cd ruoyi-ui
if [[ -f package-lock.json ]]; then npm ci; else npm install; fi
cat .env.production
npm run build:prod
ls dist
由于 .13 前端 NFS 只读,不能再 cp -r dist 到挂载点。把发布包传到 .16 管理目录,核对后在 NFS 服务端本地发布:
# .13,在 ruoyi-ui
tar -C dist -czf /tmp/ruoyi-dist-v3.9.2.tar.gz .
scp /tmp/ruoyi-dist-v3.9.2.tar.gz root@10.0.0.16:/root/
# .16,只接受已核实来源的本轮构建包
mkdir -p /nfs/ruoyi_web/dist
tar --no-same-owner -xzf /root/ruoyi-dist-v3.9.2.tar.gz -C /nfs/ruoyi_web/dist
find /nfs/ruoyi_web/dist -type d -exec chmod 0755 {} +
find /nfs/ruoyi_web/dist -type f -exec chmod 0644 {} +
这是新建实验目录的首次发布。已有版本应使用备份、独立发布目录和切换策略,解包覆盖不会自动清掉旧文件,也不保证访问期间原子切换。历史上传不在前端发布目录内。
8.5.10 Nginx 反向代理
.13 的 /etc/nginx/conf.d/ruoyi.conf:
server {
listen 80;
server_name ruoyi.example.com;
root /data/ruoyi/web/dist;
index index.html;
location / {
try_files $uri $uri/ /index.html;
}
location ^~ /prod-api/ {
proxy_pass http://127.0.0.1:8080/;
proxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
}
location ^~ /profile/ {
proxy_pass http://127.0.0.1:8080/profile/;
proxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
}
location ~* \.(js|css|png|jpg|jpeg|gif|ico|svg)$ {
expires 1d;
add_header Cache-Control public;
}
}
原 /profile/ 没有 ^~,上传图片等扩展名可能被后面的正则静态 location 抢走,已修正。prod-api 的 proxy_pass 尾斜线剥掉该前缀,profile 则保留相应后端路径。接口和上传不能因为扩展名而统一当作可公开缓存静态资源。
Nginx worker 需遍历上级目录并读取 NFS 前端。上传经后端提供,不需要让所有本地用户直接读取共享上传目录。
给 Nginx 增加单元 drop-in /etc/systemd/system/nginx.service.d/ruoyi-mount.conf:
[Unit]
RequiresMountsFor=/data/ruoyi/web
先用 mkdir -p 创建 drop-in 目录。包自带默认站点若影响本轮 Host 匹配,只取消已确认无其他用途的默认链接,不清空所有站点:
if [[ -L /etc/nginx/sites-enabled/default ]]; then
rm /etc/nginx/sites-enabled/default
fi
systemctl daemon-reload
nginx -t
systemctl enable --now nginx
systemctl reload nginx
新增挂载依赖应在服务启动/重启时确认已按预期建立,单纯 reload 不重建全部启动依赖;本例前面已显式挂载。整机多站点环境中要评估把该依赖加到全局 Nginx 服务的影响。
8.5.11 验收与上传结果
原初始化管理员 admin/admin123;在实验首次登录后及时更改,不能把公开初始密码当正式环境凭据。
点击右上角头像进入个人信息,再将鼠标移到头像、选择上传图片,完成保存;核对页面显示和网络请求。
.16 查看实际持久化结果:
tree /nfs/ruoyi_uploadPath
ls -ln /nfs/ruoyi_uploadPath
原目录为 avatar/2026/06/28/ca3f81826f824214be70052693244021.png,5层子目录、1文件。文件名、日期和目录数量随本轮上传变化。
9. 备份与恢复补充
9.1 复制、持久化与备份
副本会同步误删除和错误写入,不能替代独立备份。缓存可从数据库重建时,评估冷启动对数据库的压力;会话、队列和库存等状态还需要明确的丢失与补偿策略。恢复旧缓存可能重新引入过期状态,不能把缓存备份当作数据库的完整替代。
RDB 与 AOF 是不同的持久化恢复方式,不能将任意 RDB 与任意 AOF 叠加。Redis 7 多文件 AOF 包含 manifest、base 和 incr,必须成套保持一致。BGREWRITEAOF 用于控制日志体积,不是增量备份,也不决定每次写入的落盘窗口。
备份调度按 RPO/RTO、数据量、fork/COW、磁盘与复制延迟设计,不能假定副本总是只延迟几毫秒。备份包含敏感数据,需限制权限、加密、异地保存和恢复验证。
9.2 RDB 导出脚本
可从专用副本通过复制协议导出完整 RDB,避免只等待后台标志归零就复制到旧文件。导出会增加源实例与网络负载,先验证复制权限和容量。保存为 /data/scripts/redis_rdb_backup.sh:
#!/usr/bin/env bash
set -euo pipefail
umask 077
: "${REDISCLI_AUTH:?provide authentication in protected environment}"
backup_dir=/data/redis_backup/rdb
redis_host=${REDIS_BACKUP_HOST:-10.0.0.31}
redis_port=${REDIS_BACKUP_PORT:-6379}
mkdir -p "$backup_dir"
exec 9>"$backup_dir/.backup.lock"
flock -n 9 || exit 0
backup_stamp=$(date -u +%Y%m%dT%H%M%SZ)
tmp_file=$(mktemp "$backup_dir/.rdb.XXXXXX")
trap 'rm -f "$tmp_file"' EXIT
cli=(redis-cli -h "$redis_host" -p "$redis_port")
if [[ -n ${REDIS_BACKUP_USER:-} ]]; then
cli+=(--user "$REDIS_BACKUP_USER")
fi
timeout 30m "${cli[@]}" --rdb "$tmp_file"
test -s "$tmp_file"
redis-check-rdb "$tmp_file"
final_file="$backup_dir/redis-$backup_stamp.rdb"
mv "$tmp_file" "$final_file"
sha256sum "$final_file" > "$final_file.sha256"
printf '%s\n' "$final_file"
认证由受保护的调度环境提供 REDISCLI_AUTH,不要写入参数或脚本。TLS 环境在 cli 数组添加 CA、证书等参数。运行用户只需写备份目录和读取凭据,不需要 NOPASSWD: ALL;脚本由管理员维护、运行用户只读,备份目录 0700、文件 0600。Cron 不继承交互环境,需安全加载凭据并将失败接入告警。
9.3 AOF 与恢复边界
在线 cp -r appendonlydir 可能遇到追加或 manifest 切换,不能作为可靠的一致性备份。可在独立备份副本正常停机后复制完整目录,或使用经过验证的官方流程/一致性存储快照。停止副本前确认剩余拓扑及读流量,不同时停止多数节点。
恢复先在隔离实例使用兼容版本,校验哈希、redis-check-rdb 和 redis-check-aof,不在唯一副本上执行 --fix。检查键数、TTL、业务样本和 Stream 消费组,并记录恢复耗时。启用 AOF 时通常优先加载 AOF;恢复 RDB 要明确配置,避免旧 AOF 覆盖目标状态。
Cluster 逐分片备份并记录拓扑,各分片独立快照不构成全局事务时间点;跨分片业务一致性需应用协调。
10. 云 Redis 与应用接入
托管 Redis/Tair 的引擎、拓扑、命令、数据库数量、备份与迁移能力取决于产品规格,不能默认所有实例都是一主一从或支持 256 个数据库。Redis Cluster 通常只支持 DB 0。
优先使用 VPC 内网、认证、TLS 和来源白名单。业务账号按命令和 key 前缀授权,与 DMS/运维账号分离。以控制台提供的 Redis 域名为准,不能误用 MySQL RDS 域名。
redis-cli --tls --cacert /etc/app/redis-ca.pem \
-h redis.example.internal -p 6379 --user app --askpass PING
Spring Boot 3.x/4.x 常用 spring.data.redis,旧版可能使用 spring.redis。下面面向单点或托管代理入口:
spring:
data:
redis:
host: redis.example.internal
port: 6379
username: app
password: ${REDIS_PASSWORD}
database: 0
connect-timeout: 2s
timeout: 2s
ssl:
enabled: true
确认客户端信任服务端 CA,按实际框架核对配置项。直连 Sentinel 配置 master 名及多个 Sentinel 地址,区分 Sentinel 与 Redis 认证;直连 Cluster 使用支持 MOVED/ASK 与拓扑刷新的客户端。随机负载均衡 Service 不能作为固定主库入口。
迁移验证登录、验证码、字典缓存、限流、TTL、连接池与重连,不能只根据页面能打开判断全部流量已切换。
11. Kubernetes 与集群生命周期
11.1 数据与配置
使用 StatefulSet 保持身份,每个实例独占 PVC。Secret 保存密码/ACL,ConfigMap 保存无密钥配置;需重写的 Redis 或 Sentinel 配置复制到可写、必要时持久的目录,不能直接依赖只读 ConfigMap。节点初始化脚本必须随清单一起版本管理。
- 使用仍维护的 Operator/Helm chart,固定版本并检查渲染清单,确认初始 bootstrap、重建、备份、扩缩容和升级的行为。
- Redis Cluster 增加 StatefulSet 副本数不会自动初始化集群或分配槽位;持久保留 nodes.conf,并验证 Pod IP 变化后的通告地址更新。
- Sentinel 至少 3 个独立故障域实例,master 名与认证一致,持久保留故障转移状态;客户端查询当前主,不能认定最初的 Pod 永远是主。
- Cluster 使用至少 3 主分片并为每主配置副本,检查故障域分布、客户端端口和集群总线端口;跨集群/NAT 必须保证返回的通告地址可达。
- 不清空现有
/etc/exports,不向全网开放*(rw,no_root_squash)。单台 NFS 是故障点,数据库盘须按延迟、隔离和持久性要求选型。 - 业务使用 ClusterIP 与 NetworkPolicy,生产配置 ACL/TLS;TCP 探针只证明监听,还需带认证的读写与恢复验收。
11.2 初始化与扩缩容
以下仅用于网络、认证、持久化已准备好的空白 Cluster 实验,认证通过当前受限环境的 REDISCLI_AUTH 提供,TLS 环境增加对应参数:
redis-cli --cluster create \
10.0.0.11:6379 10.0.0.12:6379 10.0.0.13:6379 \
10.0.0.14:6379 10.0.0.15:6379 10.0.0.16:6379 \
--cluster-replicas 1
redis-cli --cluster check 10.0.0.11:6379
redis-cli -h 10.0.0.11 CLUSTER INFO
redis-cli -h 10.0.0.11 CLUSTER NODES
只对未加入其他集群的空节点执行 create,人工核对主副本分配,确认 cluster_state:ok、16384 槽覆盖、无迁移残留和复制健康后接入业务。域名支持取决于工具及服务端版本,不把旧版本限制视为通用结论。
扩容先加入新主及副本,再通过 reshard 迁移槽位:
redis-cli --cluster add-node 10.0.0.17:6379 10.0.0.11:6379
redis-cli --cluster add-node 10.0.0.18:6379 10.0.0.11:6379 \
--cluster-slave --cluster-master-id NEW_MASTER_ID
redis-cli --cluster reshard 10.0.0.11:6379
redis-cli --cluster check 10.0.0.11:6379
NEW_MASTER_ID 必须来自实际集群。迁移期间客户端处理 ASK/MOVED,并限制迁移负载。缩容先迁出目标主的全部槽与数据,确认复制关系和全局视图,再执行 --cluster del-node,最后回收 Pod/PVC。StatefulSet 从最大序号缩容,必须先让这些具体实例满足退役条件,不能直接删除有槽的主节点。
12. 监控与应用验证
redis_exporter 的 Redis 访问凭据与 /metrics 保护分别配置;指标不暴露口令和敏感业务键。Cluster 覆盖所有节点,Sentinel 单独检查;exporter 的 up=1 不等于 Redis 可用。
scrape_configs:
- job_name: redis-exporter
static_configs:
- targets: ["redis-exporter.middleware.svc:9121"]
按实际版本核对 redis_up、内存、命令、淘汰、复制和持久化指标。Counter 先 rate 再聚合,命中率处理 hit/miss 总数为 0 的情况。重点告警包括连接/认证失败、主从链路断开、复制延迟、内存水位、持久化失败和槽不可用。
Grafana 模板 763、14615、17507 仅作查询线索,导入前核对 exporter、数据源、job 和标签;空面板先查询 Prometheus 原始指标。
以下 redis-py 示例面向专用测试实例,测试键有 TTL 并在结束时清理:
import os
import secrets
import redis
client = redis.Redis(
host=os.environ["REDIS_HOST"],
port=int(os.environ.get("REDIS_PORT", "6379")),
username=os.environ.get("REDIS_USER", "default"),
password=os.environ["REDIS_PASSWORD"],
socket_connect_timeout=2,
socket_timeout=2,
decode_responses=True,
)
key = "healthcheck:" + secrets.token_hex(8)
try:
assert client.ping()
assert client.set(key, "ok", ex=60, nx=True)
assert client.get(key) == "ok"
finally:
try:
client.delete(key)
finally:
client.close()
生产 TLS 添加 ssl=True 和可信 CA,直连 Cluster 使用 RedisCluster,Sentinel 使用对应客户端;单节点读写成功不等于故障转移验收完成。
评论