
安全加固与高可用扩展资料
本篇包含 iptables 扩展、DNAT 与反向代理抓包、nftables、若依 Actuator、LVS 与 Keepalived 实验。各节是独立环境,规则、接口、源地址和连接状态均以对应实验为准,不把多套防火墙规则叠加使用。
1. iptables 扩展实践
1.1 UDP 与 ICMP
UDP 端口匹配:
[!] --source-port / --sport port[:port]
[!] --destination-port / --dport port[:port]
与 -p udp 配合使用。ICMP 类型匹配:
[!] --icmp-type {type[/code]|typename}
0/0  echo-reply       Echo 应答
8/0  echo-request     Echo 请求
本节引用已准备好的 iptables.rules 基线;如尚无文件,先在规则仍符合预期时备份,而不是从未知位置恢复:
iptables-save > iptables.rules
iptables-restore < iptables.rules
iptables -nL INPUT --line-numbers
原基线示例为 INPUT 默认 ACCEPT,优先放行管理来源 10.0.0.1:
Chain INPUT (policy ACCEPT)
num target prot opt source    destination
1   ACCEPT all  --  10.0.0.1  0.0.0.0/0
拒绝 .12 主动向 .13 发起 ping,但允许 .13 ping .12 后接收其应答:
iptables -t filter -A INPUT -s 10.0.0.12 -p icmp --icmp-type 8 -j REJECT
iptables -t filter -nL INPUT
ACCEPT all  -- 10.0.0.1  0.0.0.0/0
REJECT icmp -- 10.0.0.12 0.0.0.0/0 icmptype 8 reject-with icmp-port-unreachable
此处不能省略 --icmp-type 8,否则会连同该来源的 Echo Reply 等其他 ICMP 一起拒绝。
原实验结果:
# Rocky 10,10.0.0.12
# ping 10.0.0.13 -c1
来自 10.0.0.13 icmp_seq=1 目标端口不可达

# 其他来源的 openEuler 节点
# ping 10.0.0.13 -c1
64 字节,来自 10.0.0.13: icmp_seq=1 ttl=64 时间=0.530 毫秒
这里“端口不可达”来自 REJECT 的返回类型,并不是 ICMP ping 本身有端口。
1.2 源 MAC 匹配
mac 扩展可用于有二层头部信息的入站/转发路径,如 PREROUTING、INPUT、FORWARD:
-m mac [!] --mac-source XX:XX:XX:XX:XX:XX
示例客户端:
# ip a show ens160
2: ens160: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 state UP
    link/ether 00:0c:29:b1:f4:54 brd ff:ff:ff:ff:ff:ff
    inet 10.0.0.12/24
服务器 .13 另有测试地址 .110,需先确认该地址可用且已配置;如果本机尚未绑定,在本实验使用:
ip addr add 10.0.0.110/24 dev ens33
只允许对应源 MAC 访问这个目标地址,同时保留基线管理来源:
iptables-restore < iptables.rules
iptables -A INPUT -d 10.0.0.110 -m mac --mac-source 00:0c:29:b1:f4:54 -j ACCEPT
iptables -A INPUT -j REJECT
iptables -nvL INPUT
原计数输出:
pkts bytes target prot in out source    destination
268  21840 ACCEPT all  *  *   10.0.0.1 0.0.0.0/0
28    1912 ACCEPT all  *  *   0.0.0.0/0 10.0.0.110 MAC 00:0c:29:b1:f4:54
23    1708 REJECT all  *  *   0.0.0.0/0 0.0.0.0/0 reject-with icmp-port-unreachable
测试:
# .12 客户端
# curl 10.0.0.13
curl: (7) Failed to connect to 10.0.0.13 port 80: 拒绝连接
# curl 10.0.0.110
www.magedu.com --- this page from 10.0.0.13

# 其他来源
# ping 10.0.0.13
来自 10.0.0.13 icmp_seq=1 目标端口不可达
# curl 10.0.0.13
curl: (7) Failed to connect to 10.0.0.13 port 80 after 0 ms: Couldn't connect to server
改变的是 MAC,不是 IP。临时修改示例,需在可恢复连接的客户端环境执行:
ip link set dev ens160 down
ip link set dev ens160 address 00:0c:29:b1:f4:55
ip link set dev ens160 up

# 老工具的替代方式,选择一种即可
# ifconfig ens160 hw ether 00:0c:29:b1:f4:56

# 可选增加源 IP,再指定它测试
ip addr add 10.0.0.122/24 dev ens160
ping -I 10.0.0.122 10.0.0.110
修改后不再符合 MAC 白名单,可能被拒绝。MAC 匹配只看到当前链路上的发送方地址;跨路由后通常是上一跳 MAC,不能当作互联网终端的可靠身份认证。恢复时还原原 MAC、清除本次新增 IP,并加载基线规则。
1.3 time 时间匹配
time 扩展按数据包到达时间匹配,默认使用 UTC:
--datestart YYYY[-MM[-DD[Thh[:mm[:ss]]]]]
--datestop  YYYY[-MM[-DD[Thh[:mm[:ss]]]]]
--timestart hh:mm[:ss]
--timestop  hh:mm[:ss]
[!] --monthdays day[,day...]
[!] --weekdays Mon,Tue,Wed,Thu,Fri,Sat,Sun
--contiguous
--kerneltz
星期也支持相应数字,具体以本机帮助为准。--kerneltz 使用内核时区,未必等于用户态本地时区,不能因为 timedatectl 显示 CST 就认为扩展自动按 CST。
Asia/Shanghai 的 09:00–12:00 对应 UTC 01:00–04:00:
timedatectl
iptables-restore < iptables.rules
iptables -A INPUT -m time --timestart 01:00 --timestop 04:00 -s 10.0.0.12 -j REJECT
iptables -vnL INPUT
TIME from 01:00:00 to 04:00:00 UTC reject-with icmp-port-unreachable
在匹配时段,.12 的 ping/curl 被拒绝。课件通过在隔离实验机调整时钟验证离开时间窗口后的行为:
# timedatectl set-ntp 0
# date -s '+5 hours'
2024年12月03日 星期二 14:16:32 CST

# .12: curl 10.0.0.13
www.magedu.com --- this page from 10.0.0.13
# .12: ping 10.0.0.13
64 字节,来自 10.0.0.13: icmp_seq=1 ttl=64 时间=0.290 毫秒
恢复规则与授时:
iptables-restore < iptables.rules
timedatectl set-ntp 1
timedatectl
原恢复后时间记录为 2024-12-03 09:18:19 CST。NTP 不一定瞬间完成大幅校正,需检查实际授时服务状态;真实业务机可用调整测试规则窗口来验证,避免跳变系统时间。
课件一个 CentOS 8 环境曾提示:
Warning: Extension time revision 0 not supported, missing kernel module?
iptables v1.8.4 (nf_tables): RULE_APPEND failed (No such file or directory): rule in chain INPUT
这是具体内核/后端组合的结果,不能概括为所有 CentOS 8 都不支持 time。应检查 iptables 后端、xt_time 模块及内核构建。
1.4 connlimit 并发连接数
--connlimit-upto N      小于等于 N 时匹配
--connlimit-above N     大于 N 时匹配
用于按源地址等维度限制连接跟踪记录数量,不是请求速率限制。多源分布式流量还需其他措施;它同样能影响 Nginx 连接,不能说“因为 Nginx 并发高就看不到效果”。
准备 100 MiB 文件:
dd if=/dev/zero of=/var/www/html/test.img bs=100M count=1
只限制 TCP 80 新连接的例子:
iptables-restore < iptables.rules
iptables -A INPUT -p tcp --syn --dport 80 -m connlimit --connlimit-above 2 -j REJECT --reject-with tcp-reset
iptables -vnL INPUT
客户端启动两条慢速下载,让连接保持:
# wget --limit-rate=1024 http://10.0.0.13/test.img >/dev/null 2>&1 &
[1] 2649
# wget --limit-rate=1024 http://10.0.0.13/test.img >/dev/null 2>&1 &
[2] 2650
# wget --limit-rate=1024 http://10.0.0.13/test.img
正在连接 10.0.0.13:80... 失败:拒绝连接。
结束一条下载后再测试:
ps ax | grep wget
kill 2649
跟踪条目不一定在进程结束时立即删除,是否还能新建连接需结合 conntrack 状态和超时检查。
课件还演示了没有限定协议/端口的宽泛规则,作为单独的对照实验:
iptables-restore < iptables.rules
iptables -A INPUT -m connlimit --connlimit-above 2 -j REJECT
这会把更多流量纳入限制范围,可能连 SSH 也受影响。原实验在一条 wget 保持时,第一个 SSH 可以登录,第二个 SSH 被拒绝:
# ssh root@10.0.0.13
root@10.0.0.13's password:

# 另一终端再建立连接
# ssh root@10.0.0.13
ssh: connect to host 10.0.0.13 port 22: Connection refused
它用来说明匹配范围过宽的副作用,不是推荐的 Web 防护规则。实验结束恢复基线。
1.5 limit:令牌桶报文速率
limit 匹配报文速率,不是服务器的总连接数。单条规则共享一个令牌桶;要按每个源 IP 分别限速,可考虑 hashlimit 等机制。
--limit rate[/second|/minute|/hour|/day]
--limit-burst number
burst 为桶容量;初始可有一批突发令牌,随后按速率补充,不是“前 N 个包永远不计入限制”。
iptables-restore < iptables.rules
iptables -A INPUT -p icmp -m limit --limit 20/minute --limit-burst 10 -j ACCEPT
iptables -A INPUT -p icmp -j REJECT
iptables -nL INPUT
原 ping 实验节选:
icmp_seq=13 ttl=64 时间=0.426 毫秒
icmp_seq=14 ttl=64 时间=0.389 毫秒
icmp_seq=15 目标端口不可达
icmp_seq=16 ttl=64 时间=0.377 毫秒
icmp_seq=17 目标端口不可达
icmp_seq=18 目标端口不可达
icmp_seq=19 ttl=64 时间=0.484 毫秒
icmp_seq=20 目标端口不可达
icmp_seq=21 目标端口不可达
icmp_seq=22 ttl=64 时间=0.453 毫秒
默认每秒 ping 一次时,令牌耗尽后大致每 3 秒放行一个包。它不是按自然分钟窗口固定计数,初始突发、时间间隔及此前规则都会影响实际通过数。恢复基线:
iptables-restore < iptables.rules
1.6 state 与连接跟踪
现代规则可使用 conntrack 的 --ctstate,旧 state 的 --state 也可用于演示。
| 状态 | 含义 |
|---|---|
| NEW | 尚未观察到双向通信等条件的新流量;不只限于第一次 SYN |
| ESTABLISHED | 已识别到双向报文的跟踪流量;不是直接复用 TCP Socket 状态定义 |
| RELATED | 与已有连接相关,如部分 ICMP 错误或配置了 helper 的 FTP 数据连接 |
| INVALID | 不能有效关联跟踪状态的流量 |
| UNTRACKED | 被明确设置为不跟踪的流量,如 raw 中的 NOTRACK |
相关功能可能内置,也可能由规则按需加载模块:
uname -r
lsmod | grep nf_conntrack
modprobe nf_conntrack
lsmod | grep nf_conntrack
Rocky 原记录:
6.12.0-124.8.1.el10_1.x86_64
CONFIG_NF_CONNTRACK_PROCFS=y
nf_conntrack   217088 0
nf_defrag_ipv6  24576 1 nf_conntrack
nf_defrag_ipv4  16384 1 nf_conntrack
libcrc32c      16384 2 nf_conntrack,xfs
该构建提供 /proc/net/nf_conntrack。Ubuntu 原记录为内核 6.8.0-49-generic,CONFIG_NF_CONNTRACK_PROCFS 未设置,但已有 nf_conntrack 模块:
nf_conntrack   196608 2 nf_conncount,xt_connlimit
nf_defrag_ipv6  24576 1 nf_conntrack
nf_defrag_ipv4  12288 1 nf_conntrack
libcrc32c      12288 2 nf_conntrack,nf_tables
ls: 无法访问 '/proc/net/nf_conntrack': 没有那个文件或目录
PROCFS 选项只控制这个旧查询接口;文件不存在不表示系统不能进行连接跟踪。可使用 Netlink 工具:
# Ubuntu 的查询工具包
apt install conntrack
conntrack -L
1.7 保留旧连接,拒绝新连接
先从 .13 持续 ping .12,让双方报文进入跟踪状态,再在 Rocky .12 加规则:
iptables -A INPUT -m conntrack --ctstate ESTABLISHED -j ACCEPT
iptables -A INPUT -m conntrack --ctstate NEW -j REJECT
iptables -nL INPUT
需要相关错误报文时常用 ESTABLISHED,RELATED。规则必须位于会抢先拒绝流量的规则之前。
原持续会话可以继续,新启动的 ping 进程使用不同 ICMP ID,可能被视为新跟踪流量而拒绝:
# 旧会话
64 bytes from 10.0.0.12: icmp_seq=221 ttl=64 time=0.365 ms
64 bytes from 10.0.0.12: icmp_seq=223 ttl=64 time=0.442 ms

# 新会话
From 10.0.0.12 icmp_seq=17 Destination Port Unreachable
From 10.0.0.12 icmp_seq=20 Destination Port Unreachable
跟踪条目示例:
ipv4 2 tcp 6 299 ESTABLISHED src=10.0.0.12 dst=10.0.0.1 sport=22 dport=12700 src=10.0.0.1 dst=10.0.0.12 sport=12700 dport=22 [ASSURED] mark=0 zone=0 use=2
ipv4 2 icmp 1 29 src=10.0.0.13 dst=10.0.0.12 type=8 code=0 id=4398 src=10.0.0.12 dst=10.0.0.13 type=0 code=0 id=4398 mark=0 zone=0 use=2
ipv4/2 为协议族,tcp/6 或 icmp/1 为协议与编号;299/29 是该条目的剩余超时秒数,后面为原方向、回复方向等字段。ICMP 不应因为出现在这个位置就被称为传输层协议。
超时取决于协议、状态和实际内核参数,不是“连续 29 次异常包再加 1 次就是 30 秒”,也不是所有 wget 连接都固定保留 30 秒:
sysctl net.netfilter.nf_conntrack_icmp_timeout
sysctl net.netfilter.nf_conntrack_tcp_timeout_established
2. DNAT 与七层反向代理抓包
2.1 连接模型
| 对比 | DNAT | Nginx HTTP 反向代理 |
|---|---|---|
| 主要处理位置 | 内核 Netfilter/NAT | 用户态 HTTP 代理 |
| TCP 终止 | 普通 DNAT 不终止端到端 TCP | 客户端连接终止于代理,后端另建或复用连接 |
| 地址 | 根据规则改写目标/源地址或端口 | 后端连接通常以代理地址发起 |
| 载荷 | 普通 TCP DNAT 不主动改写 HTTP 头 | 可按配置修改 HTTP 头 |
| 典型用途 | 端口映射、数据库、SSH、私有 TCP/UDP | HTTP 路由、TLS 接入、限流、站点分流 |
DNAT 会改变经过转换点前后的元组,不能说“五元组全程不变”。仅做 DNAT 且回程正确时后端可看到客户端源 IP;若同时 SNAT/masquerade,后端看到的源地址会改变。
2.2 DNAT 实验环境
- 网关外侧 ens33:10.0.0.13。
- 网关内侧 ens34:192.168.8.13。
- 后端:192.168.8.16:9999。
- 客户端:10.0.0.1,访问 10.0.0.13:9999。
这些均是实验私网地址,10.0.0.1 不是公网地址。后端接口名以本机为准,课件使用 ens33。
后端准备:
ip route replace default via 192.168.8.13 dev ens33
apt install -y tcpdump
python3 backend_server.py
backend_server.py 来自配套 scripts 目录,PDF 未提供源码。课件输出为“兼容 TCP/HTTP 双协议服务,监听 9999 端口”。
原课件省略的网关最小设置补齐如下,前提是转发链上没有更早的拒绝规则:
sysctl -w net.ipv4.ip_forward=1
iptables -t nat -A PREROUTING -i ens33 -d 10.0.0.13 -p tcp --dport 9999 -j DNAT --to-destination 192.168.8.16:9999
iptables -A FORWARD -i ens33 -o ens34 -p tcp -d 192.168.8.16 --dport 9999 -m conntrack --ctstate NEW,ESTABLISHED -j ACCEPT
iptables -A FORWARD -i ens34 -o ens33 -m conntrack --ctstate ESTABLISHED,RELATED -j ACCEPT
这里不加 SNAT,以观察后端保留客户端源地址的情形。抓包:
# 网关
tcpdump -i any -nnS tcp port 9999
# 后端
tcpdump -i ens33 -nnS tcp port 9999
后端看到的 SYN
17:27:33.705443 IP 10.0.0.1.10871 > 192.168.8.16.9999: Flags [S], seq 415963048, win 64240, options [mss 1460,nop,wscale 8,sackOK,TS val 814613695 ecr 0], length 0
客户端源地址保留,目标改成后端地址。
后端发回的 SYN+ACK
17:27:33.705468 IP 192.168.8.16.9999 > 10.0.0.1.10871: Flags [S.], seq 797140993, ack 415963049, win 31856, options [mss 1460,sackOK,TS val 1311879626 ecr 814613695,nop,wscale 7], length 0
其 IP 目标是客户端,但链路下一跳可以是内网网关;不要把“经网关发送”误写为“IP 目标就是网关”。
网关外侧的回复
17:27:33.774325 IP 10.0.0.13.9999 > 10.0.0.1.10871: Flags [S.], seq 797140993, ack 415963049, win 31856, options [mss 1460,sackOK,TS val 1311879626 ecr 814613695,nop,wscale 7], length 0
返回方向按 NAT 状态改写为 VIP/外侧地址,普通转换的序列号并未因代理终止而重新生成。NAT 还会更新相关校验和,必要时转换端口,不只是机械修改 IP 头一个字段。
转为下一个代理实验前删除本次规则,不清空整张 NAT 表:
iptables -t nat -D PREROUTING -i ens33 -d 10.0.0.13 -p tcp --dport 9999 -j DNAT --to-destination 192.168.8.16:9999
iptables -D FORWARD -i ens33 -o ens34 -p tcp -d 192.168.8.16 --dport 9999 -m conntrack --ctstate NEW,ESTABLISHED -j ACCEPT
iptables -D FORWARD -i ens34 -o ens33 -m conntrack --ctstate ESTABLISHED,RELATED -j ACCEPT
若转发开关也是本实验临时从 0 改为 1,且本机没有其他转发业务,结束后恢复原值;不能不问原状态就一律关闭转发。
2.3 Nginx 代理实验
配置 /etc/nginx/conf.d/vhost.conf,修正原文 location/{ 的语法:
server {
    listen 9999;
    location / {
        proxy_pass http://192.168.8.16:9999;
    }
}
apt install -y nginx
rm -f /etc/nginx/sites-enabled/default
nginx -t && systemctl reload nginx
Windows 客户端:
C:\Users\ThinkPad>curl 10.0.0.13:9999
service ok
抓包片段:
# 客户端 → Nginx:客户端连接的 SYN
17:22:40.744701 IP 10.0.0.1.10838 > 10.0.0.13.9999: Flags [S], seq 4197344053, win 64240, options [mss 1460,nop,wscale 8,sackOK,TS val 814320667 ecr 0], length 0

# Nginx → 后端:另一条连接的 SYN
17:22:40.677772 IP 192.168.8.13.33754 > 192.168.8.16.9999: Flags [S], seq 4104613908, win 32120, options [mss 1460,sackOK,TS val 1409666421 ecr 0,nop,wscale 7], length 0

# Nginx → 后端:发送载荷,不是后端向 Nginx 回包
17:22:40.679699 IP 192.168.8.13.33754 > 192.168.8.16.9999: Flags [P.], seq 4104613909:4104614009, ack 1278466610, win 251, options [nop,nop,TS val 1409666422 ecr 597523007], length 100

# Nginx → 客户端:客户端连接的 SYN+ACK
17:22:40.744784 IP 10.0.0.13.9999 > 10.0.0.1.10838: Flags [S.], seq 1306686552, ack 4197344054, win 31856, options [mss 1460,sackOK,TS val 2173076969 ecr 814320667,nop,wscale 7], length 0
两段连接的端口、序列号空间不同,后端看到的源是代理内网地址 192.168.8.13。这些片段来自不同抓包视角,时钟和采样范围未说明,不能单凭时间戳拼成严格同步的完整请求时序。
需要传递客户端信息时显式配置,例如:
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
原配置本身没有这些行,不能声称抓包中必然新增了这两个头。后端还应只信任合适的代理来源,不能把任意客户端伪造的头当作真实身份。
3. nftables 框架
3.1 匹配与语句
规则通常由匹配表达式和语句组成,多条件通常按 AND 组合。accept/drop/reject 是终止性 verdict;counter/log 可以继续执行,不能认为每条规则都必须以放行或丢弃结束。
| 类型 | 示例 | 说明 |
|---|---|---|
| 地址族/协议 | ip、ip6、tcp、udp、icmp | 选择相应协议字段 |
| IPv4 地址 | ip saddr 10.0.0.12、ip daddr 10.0.0.13 |
源/目标地址 |
| 集合与网段 | ip saddr {10.0.0.12,10.0.0.15}、ip saddr 10.0.0.0/24 |
多地址或网段 |
| 端口 | tcp dport 22、udp sport 53 |
源/目标端口 |
| 端口集合 | tcp dport {22,80,443}、tcp dport 1000-2000 |
多值或范围 |
| 接口 | iifname "ens33"、oifname "ens34" |
按接口名匹配,适合持久配置 |
| 连接状态 | ct state established,related |
连接跟踪状态 |
| MAC | ether saddr 00:11:22:33:44:55 |
需要可访问对应二层头,不能仅按是否 bridge/arp 家族概括 |
| 语句/动作 | 作用 |
|---|---|
| accept | 接受当前规则路径中的包;后续其他 base chain 仍可能影响最终结果 |
| drop | 丢弃,不返回拒绝响应 |
| reject | 拒绝并按配置返回 ICMP 错误或 TCP RST |
| counter | 计数 |
| log | 记录日志,不自动丢弃 |
| jump 链名 | 跳入用户链,按返回语义继续 |
| dnat to 地址:端口 | NAT 目标转换 |
| snat to 地址 | NAT 源转换 |
静默丢弃并不在所有场景下天然“更安全”,应按暴露策略、故障排查及连接行为选择。
3.2 SSH 规则顺序实验
本节只操作专用实验规则集。若尚未创建表/链,先准备:
nft add table inet myfw
nft 'add chain inet myfw input { type filter hook input priority 0; policy accept; }'
nft 'add chain inet myfw output { type filter hook output priority 0; policy accept; }'
nft 'add chain inet myfw forward { type filter hook forward priority 0; policy drop; }'
已有相同表/链时不重复创建。先保留管理来源,再拒绝 .12,最后放行 TCP 22:
nft add rule inet myfw input ip saddr 10.0.0.1 accept
nft add rule inet myfw input ip saddr 10.0.0.12 reject
nft add rule inet myfw input tcp dport 22 accept
nft list chain inet myfw input
 table inet myfw {
    chain input {
        type filter hook input priority filter; policy accept;
        ip saddr 10.0.0.1 accept
        ip saddr 10.0.0.12 reject with icmp port-unreachable
        tcp dport 22 accept
    }
 }
.12 的 SSH 请求先命中来源拒绝,不能再由后面的端口规则放行:
# ssh root@10.0.0.13
ssh: connect to host 10.0.0.13 port 22: Connection refused
上面的描述是“拒绝源 .12 的入站包”,不是“拒绝目标 .13 的所有流量”;默认 policy 仍是 accept。
3.3 用 ct state 保留既有 SSH
先从 .15 建立 SSH,然后在服务器查看:
# w
14:17:26 up 5:08, 2 users, load average: 0.00, 0.00, 0.00
USER FROM       LOGIN@ IDLE JCPU  PCPU WHAT
root 10.0.0.1   09:08  5:08m 0.00s 1.14s sshd: root@pts/0
root 10.0.0.15  14:14  5:08m 0.00s 0.06s sshd: root@pts/2
nft -a list chain inet myfw input
课件句柄为 36:管理来源,37:拒绝 .12,38:允许 22。实际句柄每个环境不同,须读取当前结果后替换相应值。按该次记录插入:
nft insert rule inet myfw input position 36 ct state established,related accept
nft insert rule inet myfw input position 38 ip saddr 10.0.0.15 ct state new reject
nft -a list chain inet myfw input
原结果:
chain input {
    type filter hook input priority filter; policy accept;
    ct state established,related accept                 # handle 39
    ip saddr 10.0.0.1 accept                            # handle 36
    ip saddr 10.0.0.12 reject with icmp port-unreachable # handle 37
    ip saddr 10.0.0.15 ct state new reject with icmp port-unreachable # handle 40
    tcp dport 22 accept                                # handle 38
}
旧连接执行 ls /etc/hosts 仍返回 /etc/hosts;另开终端新建 SSH 则被拒绝。该来源规则没有限定 22,因而拒绝 .15 的更多 NEW 流量;若只希望控制 SSH,应在其条件中增加 tcp dport 22。
3.4 Web 访问实验
服务器准备:
apt install -y nginx
printf 'Nginx Web Page from ubuntu24-13\n' > /var/www/html/index.nginx-debian.html
curl http://127.0.0.1/
按顺序允许 .1,再拒绝同网段其余来源访问 TCP 80:
nft add rule inet myfw input ip saddr 10.0.0.1 tcp dport 80 accept
nft add rule inet myfw input ip saddr 10.0.0.0/24 tcp dport 80 reject
nft list chain inet myfw input
原规则整体:
chain input {
    type filter hook input priority filter; policy accept;
    ct state established,related accept
    ip saddr 10.0.0.1 accept
    ip saddr 10.0.0.12 reject with icmp port-unreachable
    ip saddr 10.0.0.15 ct state new reject with icmp port-unreachable
    tcp dport 22 accept
    ip saddr 10.0.0.1 tcp dport 80 accept
    ip saddr 10.0.0.0/24 tcp dport 80 reject with icmp port-unreachable
}
规则顺序仍然重要,不能因为 HTTP 和 SSH 是不同端口就认为顺序无所谓;前面的全来源 accept/reject 和 established 都会先匹配。
原 .12 的 curl 失败,但它已经被较早的整机来源规则拒绝,单凭这个结果不能证明最后的 HTTP 规则。用未被前置来源规则覆盖的 .19 新建连接,才能更清楚地验证这个 HTTP 限制。
Windows .1 浏览器测试:
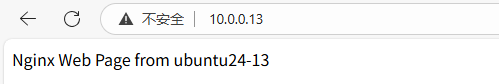
已有 HTTP 连接可能在前面的 established 规则放行,若要测试新策略,应新建连接并查看匹配计数。
3.5 规则保存与服务
Ubuntu 常用 /etc/nftables.conf,也可从其中 include 自定义目录。具体开机/停止动作以系统提供的 nftables.service 为准:
systemctl is-enabled nftables.service
systemctl status nftables.service
systemctl cat nftables.service
原状态为 disabled、inactive (dead),并不表示内核里没有 nft 规则。
在只使用本实验规则的专用环境,保存当前完整规则,并把 flush 与重建放在同一文件事务中,避免先清空后加载的无规则窗口:
{
    printf 'flush ruleset\n'
    nft list ruleset
} > /etc/nftables.conf
nft -c -f /etc/nftables.conf
nft -f /etc/nftables.conf
systemctl enable --now nftables.service
nft list ruleset
nft -c 检查而不应用。完整文件示例包含 input/output/forward 三条 base chain,forward policy=drop;如果这台机器还要承担路由转发,需单独设计转发规则。
flush ruleset 会覆盖本机其他 nft/iptables-nft 管理者的规则,所以不能把上述全量快照方案直接套到 Docker、firewalld 等共管防火墙的机器。专用实验可在维护窗口重启后验证持久化:
reboot
# 重新连接后
nft list ruleset
4. RuoYi-Vue 开放 Actuator 观测
4.1 依赖与管理端口
在 ruoyi-admin/pom.xml 的 dependencies 中加入:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-actuator</artifactId>
</dependency>
版本由项目的 Spring Boot 依赖管理统一控制,不必随意另外指定。application.yml:
management:
  endpoints:
    web:
      base-path: /actuator
      exposure:
        include: health,info,metrics
  endpoint:
    health:
      show-details: when_authorized
  server:
    port: 8091
    address: 127.0.0.1
管理端口 8091 与业务端口分开,仅绑定本机。原文暴露 '*' 并对全部 Actuator permitAll,会把 env 等敏感管理能力一起放开;这里限制暴露项,详情只向授权身份显示。
4.2 Spring Security 规则
在既有授权链、anyRequest 之前按项目版本加入相应 matcher,示意链式配置:
.requestMatchers("/actuator/health", "/actuator/health/**").permitAll()
.requestMatchers("/actuator/**").authenticated()
.anyRequest().authenticated();
这是已有类的局部配置,不是完整的 SecurityFilterChain 定义。需要与若依实际认证过滤器、允许列表和 Spring Security 版本协调;不能用 Java 行尾的 # 当作注释。
mvn clean package -DskipTests
java -jar ruoyi-admin/target/ruoyi-admin.jar
前台测试和已有 systemd 服务不要同时占用同一个业务端口。部署包更新的课件命令:
cp ruoyi-admin/target/ruoyi-admin.jar /data/ruoyi/server/
systemctl restart ruoyi-admin.service
4.3 健康检查
无需身份时,health 通常只显示总状态。要查看完整详情和 metrics,按项目认证方案提供访问凭据;若依 JWT 示例使用已登录获取的原始 token:
read -rsp '若依登录 token: ' RUOYI_TOKEN
printf '\n'
curl -fsS -H "Authorization: Bearer $RUOYI_TOKEN" http://127.0.0.1:8091/actuator/health | jq
原课件授权详情的内容整理如下,组件及其名字随实际版本变化:
{
  "components": {
    "db": {
      "components": {
        "dynamicDataSource": {
          "components": {
            "MASTER": {
              "details": {
                "database": "MySQL",
                "validationQuery": "isValid()"
              },
              "status": "UP"
            }
          },
          "status": "UP"
        },
        "masterDataSource": {
          "details": {
            "database": "MySQL",
            "validationQuery": "isValid()"
          },
          "status": "UP"
        }
      },
      "status": "UP"
    },
    "diskSpace": {
      "details": {
        "total": 210238414848,
        "free": 188782104576,
        "threshold": 10485760,
        "path": "/root/RuoYi-Vue/.",
        "exists": true
      },
      "status": "UP"
    },
    "livenessState": {"status": "UP"},
    "ping": {"status": "UP"},
    "readinessState": {"status": "UP"},
    "redis": {
      "details": {"version": "7.0.15"},
      "status": "UP"
    },
    "ssl": {
      "details": {
        "expiringChains": [],
        "invalidChains": [],
        "validChains": []
      },
      "status": "UP"
    }
  },
  "groups": ["liveness", "readiness"],
  "status": "UP"
}
UP 说明这些健康探针当时符合各自阈值,不等于所有 SQL、业务请求和所有磁盘容量都已验证正常。
4.4 指标查看
curl -fsS -H "Authorization: Bearer $RUOYI_TOKEN" http://127.0.0.1:8091/actuator/metrics | jq
curl -fsS -H "Authorization: Bearer $RUOYI_TOKEN" http://127.0.0.1:8091/actuator/metrics/jvm.memory.used | jq
curl -fsS -H "Authorization: Bearer $RUOYI_TOKEN" 'http://127.0.0.1:8091/actuator/metrics/jvm.memory.max?tag=area:heap' | jq
curl -fsS -H "Authorization: Bearer $RUOYI_TOKEN" http://127.0.0.1:8091/actuator/metrics/jvm.gc.pause | jq
curl -fsS -H "Authorization: Bearer $RUOYI_TOKEN" 'http://127.0.0.1:8091/actuator/metrics/logback.events?tag=level:error' | jq
| 指标 | 含义与关注点 |
|---|---|
| jvm.memory.used | 已用内存;按 heap/nonheap、内存池标签分析趋势 |
| jvm.memory.max | 对应内存池/区域最大值,部分值可能未定义;不能把未过滤汇总直接当作 Xmx |
| jvm.gc.pause | GC 停顿计数与耗时等;分位数/直方图需要相应监控配置,原生 JSON 不保证自带 p95/p99 |
| jvm.gc.overhead | 可用时观察 GC 时间占比,告警线按收集器和业务基线设置,10% 不是通用故障判据 |
| jvm.threads.live | 活线程数,观察异常增长与线程池压力 |
| jvm.threads.peak | 历史线程峰值 |
| process.cpu.usage | 进程 CPU 指标,结合版本、CPU 配额和统计口径解释 |
| system.cpu.usage | 系统 CPU 指标,容器中注意其实际观测范围 |
| system.load.average.1m | 1 分钟负载,不等同于 CPU 使用率 |
| process.uptime | 进程已运行时间,可辅助发现重启,不直接等于 SLA |
| disk.free / disk.total | 监控文件系统的空间,结合标签和具体挂载点 |
| tomcat.sessions.active.current | 当前 HTTP Session 数,不直接等于在线人数,JWT 无状态服务可能几乎不用 Session |
| tomcat.sessions.rejected | 被拒绝的 Session 创建数 |
| logback.events | 日志事件计数,按 level 标签筛选,ERROR 增量结合业务分析 |
原文还查看 /actuator/env。按本文默认暴露列表,该端点不开放;只有确需受控诊断时,按项目版本临时启用并添加 env,且保留认证,再访问:
curl -fsS -H "Authorization: Bearer $RUOYI_TOKEN" http://127.0.0.1:8091/actuator/env
诊断结束恢复暴露范围,不在日志或共享材料中打印 token/敏感配置:
unset RUOYI_TOKEN
5. LVS 扩展资料
5.1 动态调度方法
以下公式用于理解选取较低相对负载的思路,具体计数、常数和实现以目标内核版本为准,不能当作固定时延测量公式。
| 调度器 | 主要思路 |
|---|---|
| LC,Least Connections | 选择连接开销较小的 RS,适合处理能力相近的节点 |
| WLC,Weighted Least Connections | 按权重归一化连接开销,权重大者可承受更多负载 |
| SED,Shortest Expected Delay | 按 (活动连接数+1)/权重 估计新增任务的相对开销 |
| NQ,Never Queue | 优先选择没有活动连接的可用节点;没有空闲节点时按类似 SED 的比较选择 |
| LBLC | 按目标局部性维持后端映射,过载或不可用时选择其他节点,常见于缓存/代理场景 |
| LBLCR | 为一个目标维护可复制的后端映射集合,在局部性与负载之间平衡 |
课件常用的示意模型:
LC:  overhead = active × 256 + inactive
WLC: relative_overhead = (active × 256 + inactive) / weight
SED: relative_overhead = (active + 1) / weight
SED 的所有候选同乘常数 256 不改变相对选择结果;+1 用来估计新增任务影响,不是把所有后端真的伪造出一个已建立连接。NQ 也不是强制先做一轮普通轮询。
LBLCR 的“复制”指调度映射/服务器集合,不是 IPVS 自动把应用缓存数据从一台 RS 复制到另一台;缓存内容管理仍由应用承担。
5.2 其他调度器
- FO,Weighted Fail Over:优先使用符合条件、权重较高的后端,不能把名字解释为“权重过载”。
- OVF,Overflow Connection:按权重等条件优先填充后端,达到相应活动连接阈值后转向其他候选。
- MH,Maglev Hashing:使用 Maglev 哈希思想保持映射稳定,可结合源地址及相应选项;不是 Masquerading Hashing。
“活动连接小于权重”是 OVF 一类选择逻辑中的条件,不能把它推广为所有 LVS 调度器共同的可用性判断。一般还需考虑正权重、过载标志、目标状态及调度器本身规则。
DR、TUN、NAT 是转发模式,不是这里的调度算法;不要把混淆二者的名称放进调度器清单。可用调度器随内核和工具构建变化:
ipvsadm --help
lsmod | grep ip_vs
modinfo ip_vs_mh
模块未动态出现在 lsmod 不代表一定不支持,还可能内置。
5.3 IPVS 规则持久化
命令行修改的是内核运行时规则,重启后是否恢复取决于保存文件和启动服务。不能由某一次 systemctl restart ipvsadm 规则不变,就认为所有发行版的重启行为都相同。
在专用实验机定制规则,已有同名虚拟服务时先用 ipvsadm -Ln 核对,按需要删除相应服务再重建:
ipvsadm -Ln
# 仅当本实验服务已存在且需重建时使用
# ipvsadm -D -t 192.168.8.14:80
# ipvsadm -D -t 192.168.8.15:80

ipvsadm -A -t 192.168.8.14:80 -s wlc
ipvsadm -A -t 192.168.8.15:80 -s wlc
ipvsadm -a -t 192.168.8.15:80 -r 192.168.8.17:80 -g
ipvsadm -a -t 192.168.8.14:80 -r 192.168.8.18:80 -g
-g 明确使用 DR。课件 Ubuntu 软件包中的初始文件:
# /etc/ipvsadm.rules
# empty rules file for ipvsadm
该环境支持服务保存接口:
# service ipvsadm save
* Saving IPVS configuration... [ OK ]
保存后示例:
-A -t 192.168.8.14:80 -s wlc
-a -t 192.168.8.14:80 -r 192.168.8.18:80 -g -w 1
-A -t 192.168.8.15:80 -s wlc
-a -t 192.168.8.15:80 -r 192.168.8.17:80 -g -w 1
增加一个 NAT 转发 RS 并重新保存:
ipvsadm -a -t 192.168.8.14:80 -r 10.0.0.130:80 -m -w 30
ipvsadm-save -n > /etc/ipvsadm.rules
这只是展示不同目的项的参数和保存方法;实际服务是否混合不同模式,需要按每个 RS 的网络与回程条件验证,不能认为添加成功就能正常转发。
Ubuntu/Debian 该软件包的开机配置示例:
# /etc/default/ipvsadm
AUTO="true"
查看实际启动服务与加载来源,确认它读取相应文件:
systemctl cat ipvsadm
systemctl is-enabled ipvsadm
ipvsadm -Ln
在空的规则环境中可手工恢复:
ipvsadm-restore < /etc/ipvsadm.rules
重启实验机后核对 ipvsadm -Ln,再按原状态将 AUTO 恢复为 false。/etc/default/ipvsadm、服务名和保存接口均依软件包而异,不是所有系统的统一路径。
5.4 NAT、DR、TUN 的选择
| 模式 | 请求路径 | 回复路径与约束 |
|---|---|---|
| NAT | Director 改写地址/端口后转到 RS | 通常需要回复也经过 Director,注意双向带宽、CPU 和路由 |
| DR | Director 在可达的二层网络中把请求交给 RS | RS 直接回复,需正确配置 VIP、ARP 行为和回程 |
| TUN | Director 封装后把请求送到远端 RS | RS 解封后直接回复,需隧道可达、协议支持、MTU 和回程条件 |
同等硬件下,DR 不处理业务回复通常减少 Director 的响应带宽压力,TUN 有封装开销,NAT 处理双向流量。但“DR 十万并发、TUN 固定为 DR 的 70%、NAT 固定为一半”没有本资料的实测依据,不能当作容量结论。
QPS、并发连接数、PPS、吞吐和延迟是不同指标。容量测试应固定报文/响应大小、连接复用、网卡、CPU、业务耗时和目标延迟,再比较。
同机房且满足二层与 VIP/ARP 条件时,可优先评估 DR;“同一 IP 子网”不是代替二层可达性检查的万能条件。回包仍可能遇到 RS、自身网络或其他设备的瓶颈,不能说采用 DR 就再无带宽瓶颈。
跨三层网络可评估 TUN,但还要考虑 IPIP 是否被网络放行、MTU、源地址策略、VIP 回程以及跨地域容灾设计。TUN 不是异地多活/灾备唯一可选方案,也不自动提供加密或完整故障切换策略。选型应看实际网络和业务约束,不强制所有若依集群使用同一种模式。
6. Keepalived 优先级与脑裂
6.1 同优先级的选举
参与 VRRP 选举时,优先级相等通常再比较通告源主 IP,较大的 IP 可作为胜者条件。例如同为 100 的 192.168.1.10 和 192.168.1.11,后者在相应选举条件下更优。
实际切换还受运行状态、地址所有者、抢占、通告时序等影响。相同优先级本身不等于脑裂,state MASTER/BACKUP 也不是永不变化的固定身份。为了角色清晰,本实验用主优先级 150、备优先级 100。
6.2 脑裂的原因与处理思路
脑裂表现为同一个服务 VIP 被多个互不认可对方主身份的节点同时持有。常见原因:
- 心跳链路分区,协议 112 被防火墙阻断,或单播对端地址错误。
- 同一 VIP 的 VRID、版本、认证等关键参数不一致。
- 选错接口、源地址与接口不匹配、服务配置故障。
- 监控、仲裁或隔离机制不能识别并处理分区。
单节点宕机通常触发正常接管,不能笼统地把任何节点故障都叫脑裂。应检查稳定且冗余的网络、匹配的 VRRP 参数、合理的检测时间,并监控两端 VIP、状态与通告。
fencing/STONITH 是通过隔离或关闭冲突节点确保唯一服务所有者的策略,但 Keepalived 不会因为配置了优先级就自动完成完整的仲裁/fencing。需要可靠的外部机制和明确的失败处理,不能把简单“互相 ping”当成绝对唯一性保证。
6.3 正常双网卡基线
| 节点 | 业务接口 ens33 | 心跳接口 ens37 | VIP |
|---|---|---|---|
| 主节点 .13 | 10.0.0.13 | 192.168.8.13 | 10.0.0.100 |
| 备节点 .16 | 10.0.0.16 | 192.168.8.16 | 正常不持有 |
安装与检查:
apt install -y keepalived iptables tcpdump
ip -br address
主配置应确实加载 /etc/keepalived/conf.d/cluster1.conf,例如包含:
include /etc/keepalived/conf.d/*.conf
主节点 cluster1.conf:
vrrp_instance VI_1 {
    state MASTER
    interface ens37
    virtual_router_id 50
    priority 150
    advert_int 1
    unicast_src_ip 192.168.8.13
    unicast_peer {
        192.168.8.16
    }
    authentication {
        auth_type PASS
        auth_pass 1111
    }
    virtual_ipaddress {
        10.0.0.100/24 dev ens33 label ens33:1
    }
    track_interface {
        ens33
    }
}
备节点 cluster1.conf:
vrrp_instance VI_1 {
    state BACKUP
    interface ens37
    virtual_router_id 50
    priority 100
    advert_int 1
    unicast_src_ip 192.168.8.16
    unicast_peer {
        192.168.8.13
    }
    authentication {
        auth_type PASS
        auth_pass 1111
    }
    virtual_ipaddress {
        10.0.0.100/24 dev ens33 label ens33:1
    }
    track_interface {
        ens33
    }
}
认证字段对应课件 IPv4/VRRPv2 实验,不是强加密;VRRP 版本和认证支持需按实际版本检查。这里将源地址所在的心跳接口统一为 ens37,VIP 放在业务 ens33,修正原稿恢复配置中接口和源地址不匹配的问题。
两端先校验并启动:
keepalived -t -f /etc/keepalived/keepalived.conf
systemctl restart keepalived
systemctl status keepalived
hostname -I
原拓扑正常结果:
# 主节点
10.0.0.13 192.168.8.13 10.0.0.100
# 备节点
10.0.0.16 192.168.8.16
这里只需重启 Keepalived 服务,不是每次修改都重启整台主机。
6.4 VRID 不一致
在主节点把以下字段从 50 临时改为 88,备节点仍为 50:
virtual_router_id 88
两端变成不同的 VRRP 虚拟路由器,却配置同一 VIP,可能各自进入主状态。需要一致的是 virtual_router_id,不是 global_defs 中用于标识本机的 router_id 字符串。
原观测:
# 主节点
10.0.0.13 192.168.8.13 10.0.0.100
# 备节点
10.0.0.16 192.168.8.16 10.0.0.100
试验后恢复主节点 VRID=50,再校验并重载/重启相应服务。
6.5 单播地址错误
在主节点把 unicast_peer 的对端地址误写成:
unicast_peer {
    192.168.8.166
}
正确对端应为 192.168.8.16。主通告未到达真实备节点时,备节点可能超时升级,出现两端持有同一 VIP。课件结果仍是上一节的双 VIP 地址列表。
应检查:
ip route get 192.168.8.16
tcpdump -i ens37 -nn 'ip proto 112'
journalctl -u keepalived --since '-5 min'
恢复正确单播地址并确认双方接收通告;只看服务 active 不能证明心跳正常。
6.6 接口名称与接口选择
两台机器的网卡名字可以不同,只要各自指定的是正确的心跳接口、源地址和网络路径。不能因为主用 ens33、备用 ens37 就断定必然脑裂。
原课件把主接口改为 ens33,但仍用心跳地址 192.168.8.13。该环境中它选择了不匹配的网络路径,可能导致通告收发失败、配置错误或进入 FAULT;具体表现以日志和抓包为准。原课件记录两端都持有 VIP,但这只是该拓扑的结果。
恢复方法是把每台配置的 interface、unicast_src_ip 与实际地址归属对应,而不是强行给两台主机网卡改成同名。
6.7 心跳网络中断
恢复第 6.3 节配置后,原正常状态为 .13 持有 VIP,.16 不持有。课件通过修改虚拟网络连接方式,使心跳路径断开,在两台地址列表中再次观察到 VIP。
应区分:
- 心跳报文被隔离,但接口仍 UP、VIP 业务网仍连通:可能双主。
- 当前 VRRP 接口或 track_interface 直接 DOWN:Keepalived 可能进入 FAULT 并移除本地 VIP,表现为正常接管而非双主。
- 两台机器连入不同业务广播域:即使都列出 VIP,也不等于客户端所在网络一定出现同一二层域的地址冲突。
因此“拔网线一定演示不出来”不是普遍结论。测试须明确断的是心跳报文路径、被跟踪的接口,还是业务网。
恢复网络后,正常 VRRP 通信通常会让节点按选举和抢占策略重新收敛,不是必须重启两端才可能恢复;不收敛时检查 nopreempt、优先级、错误配置和日志。
6.8 防火墙阻断 VRRP
保留接口和业务网正常,在备节点只丢弃来自主节点的 VRRP,避免用“丢弃该来源全部协议”误伤其他流量:
iptables -I INPUT 1 -i ens37 -s 192.168.8.13 -p 112 -j DROP
iptables -vnL INPUT
tcpdump -i ens37 -nn 'ip proto 112'
VRRP 是 IP 协议 112,不是 TCP/UDP 112 端口。原课件宽泛 DROP 规则曾命中 1 包、40 字节;那是旧规则的记录,不作为本修正规则的实测计数。
备节点收不到主通告,超时后可能升主。原双 VIP 观测:
# 主节点
10.0.0.13 192.168.8.13 10.0.0.100
# 备节点
10.0.0.16 192.168.8.16 10.0.0.100
恢复时只删除本实验规则,不清空全部 INPUT:
iptables -D INPUT -i ens37 -s 192.168.8.13 -p 112 -j DROP
journalctl -u keepalived --since '-5 min'
ip -br address
原恢复结果备节点不再持有 VIP:
10.0.0.16 192.168.8.16
按实际运行状态同时验证服务连通、VIP 所有者和通告恢复,不只看一端 hostname -I。
7. 整理与核对范围
按 32 页原文手工整理,保留实验、抓包字段、输出、参数表和原图。直接修正 UDP 拼写、limit/connlimit 区别、连接跟踪接口与状态、NAT 地址/方向、nft 规则顺序、Actuator 暴露和指标解释、LVS 算法名/容量断言、VRID 与接口、VRRP 防火墙及恢复逻辑。
配套 backend_server.py 未包含于 PDF,未补造实现。原实验数据、修正后配置和预期结果分别标明;命令没有在本机执行,静态核对不代表网络、数据库、Java 服务或高可用实机测试。图片保留原尺寸,不裁剪。
评论